

机器学习数据划分详解:Python实现留出法与交叉验证法

本文深入解析机器学习中的数据划分策略,重点对比留出法与交叉验证法的原理及适用场景。通过Python sklearn库代码示例,详细演示如何实现train_test_split、KFold及LeaveOneOut等关键函数,帮助开发者根据数据量大小选择最优划分方案,平衡计算成本与模型评估的准确性。
机器学习数据划分概述
在机器学习任务中,通常采用在训练集上构建模型,并在测试集上评估模型表现的标准流程。核心目标在于确保模型在未见过的测试数据上具备最佳的性能表现。
然而,实际场景中往往仅拥有包含m个观测值的数据集D。既要利用该数据集进行模型训练,又要对其进行测试评估,这就必须对数据集D进行合理的划分处理。
针对数据集D的划分过程,原则上应满足以下三项基本要求:
- 确保训练集拥有充足的样本数量。
- 模型训练过程中的计算资源消耗需在可接受范围内。
- 由于不同的划分方式会导致训练集与测试集构成不同,进而产生差异化的结果,因此需要采取措施消除这种随机划分带来的影响。
本文将分别介绍留出法(Hold-out)与交叉验证法(Cross Validation),并提供相应的Python实现代码。自助法(Bootstrapping)将在后续文章中单独介绍。
留出法原理与Python实现
1. 留出法(Hold-out)
留出法是最为常用、直接且简单的数据划分方法。其核心操作是将数据集D直接拆分为两个互斥的集合:一个作为训练集R,另一个作为测试集T。具体划分关系可表示为:
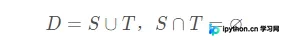
在使用留出法时,需重点关注以下事项:
- 必须保证样本量足够大,以支撑模型训练的效果。
- 在划分过程中需确保数据分布的一致性。例如,若500个样本中正例与反例的比例为2:3,则划分后的训练集和测试集中正负例比例也应维持2:3。实现这一目标只需采用随机分层抽样即可。
- 为降低随机划分对结果的影响,建议多次重复划分训练集和测试集,并将多次实验的结果取平均值作为最终评估结果。
- 通常情况下,训练集与测试集的比例设定为8:2或7:3。
当然,留出法的缺点也十分明显:一方面会损失部分样本信息,另一方面要求数据集规模较大。
使用Python实现留出法十分简便,仅需调用sklearn库即可。
from sklearn.model_selection import train_test_split
#使用train_test_split划分训练集和测试集
train_X , test_X, train_Y ,test_Y = train_test_split(
  X, Y, test_size=0.2,random_state=0)
'''
X为原始数据的自变量,Y为原始数据因变量;
train_X,test_X是将X按照8:2划分所得;
train_Y,test_Y是将X按照8:2划分所得;
test_size是划分比例;
random_state设置是否使用随机数
'''
交叉验证法原理与Python实现
2. 交叉验证法(Cross Validation)
交叉验证法能够有效解决留出法存在的诸多问题。该方法对数据量的要求相对较低,且样本信息的损失较小。
交叉验证法首先将数据集D划分为k个大小相近且互斥的子集,即:
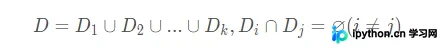
为确保数据分布的一致性,可从数据集D中进行随机分层抽样。
随后,每次迭代使用k-1个子集的并集作为训练集,剩余的一个子集作为测试集。由此可获得k组训练/测试集组合,进行k次训练与测试,最终返回这k组测试结果的均值。
具体而言,以k=10为例进行说明: 第一次迭代选取第10份数据作为测试集,前9份作为训练集; 第二次迭代选取第9份数据作为测试集,第1-8份及第10份作为训练集; … 第十次迭代选取第1份数据作为测试集,第2-9份作为训练集; 由此,共获得10组训练集和测试集,进行10次训练和测试,最终返回10次测试结果的平均值。
显然,交叉验证法结果的稳定性和保真性在很大程度上取决于k值的选择。为了强调这一点,该方法也被称为“k折交叉验证法”。k值最常取10,有时也取5或20。
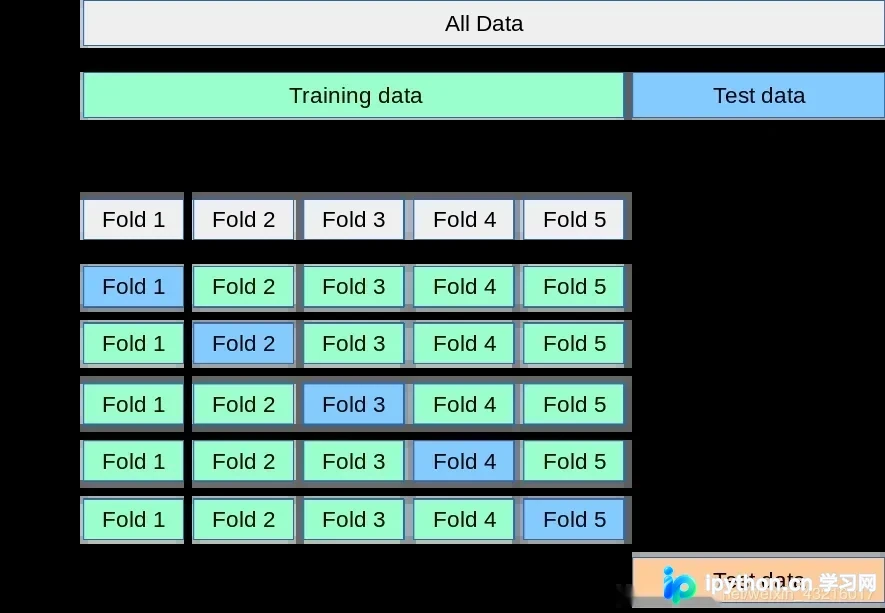
同时,为了规避因数据划分随机性导致的误差,可以重复进行p次实验。
p次k折交叉验证法,相当于执行了p*k次留出法(比例为k-1:1)。
使用Python实现交叉验证法,同样只需调用sklearn库。需要注意的是,相关函数返回的是样本的序号。
import pandas as pd
from sklearn.model_selection import KFold

data = pd.read_excel('') #导入数据
kf = KFold(n_splits = 4,shuffle = False,random_state = None)
'''n_splits表示将数据分成几份;shuffle和random_state表示是否随机生成。
如果shuffle = False,random_state = None,重复运行将产生同样的结果;
如果shuffle = True,random_state = None,重复运行将产生不同的结果;
如果shuffle = True,random_state = (一个数值),重复运行将产生相同的结果;
'''
for train, test in kf.split(data):
 print("%s %s" % (train, test))
 '''
 结果
[ 5 6 7 8 9 10 11 12 13 14 15 16 17 18] [0 1 2 3 4]
[ 0 1 2 3 4 10 11 12 13 14 15 16 17 18] [5 6 7 8 9]
[ 0 1 2 3 4 5 6 7 8 9 15 16 17 18] [10 11 12 13 14]
[ 0 1 2 3 4 5 6 7 8 9 10 11 12 13 14] [15 16 17 18]
'''
若希望多次重复使用交叉验证法对数据集进行划分,可使用RepeatedKFold函数,该函数额外包含一个参数n_repeats。
留一法(Leave-One-Out)
与留出法相比,交叉验证法的数据损失较小,更适用于小样本场景。但其计算复杂度较高,且存储空间需求较大。极端情况下,若将数据集D(m个样本)划分为m份,每次取m-1个样本作为训练集,剩余一个作为测试集,共进行m次训练和测试。这种方法被称为留一法(Leave-One-Out)。
留一法的优点显而易见:数据损失仅为一个样本,且不受样本随机划分的影响。然而,其计算复杂度过高,且占用大量存储空间。
使用Python实现交叉验证法(包括留一法),只需调用sklearn库。
from sklearn.model_selection import LeaveOneOut
X = [1, 2, 3, 4]
loo = LeaveOneOut()
for train, test in loo.split(data):
 print("%s %s" % (train, test))
'''结果
[1 2 3] [0]
[0 2 3] [1]
[0 1 3] [2]
[0 1 2] [3]
'''
方法选择建议与总结
综上所述:
- 当数据量充足时,选择留出法简单且省时,在牺牲极小准确度的前提下,换取计算的简便性;
- 当数据量较小时,应选择交叉验证法,因为此时若划分样本集会导致训练数据过少;
- 当数据量特别少时,可以考虑使用留一法。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









