

Python机器学习scikit-learn决策树算法详解:分类、回归与多输出实现

本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
决策树概述与优缺点分析
本文详细介绍Python机器学习库scikit-learn中决策树的实现方法,供读者参考学习。
决策树
决策树(DTs)是一种非参数监督学习方法,适用于分类和回归任务。其核心目标是构建一个模型,通过从数据特征中提取简单的决策规则,来预测目标变量的值。
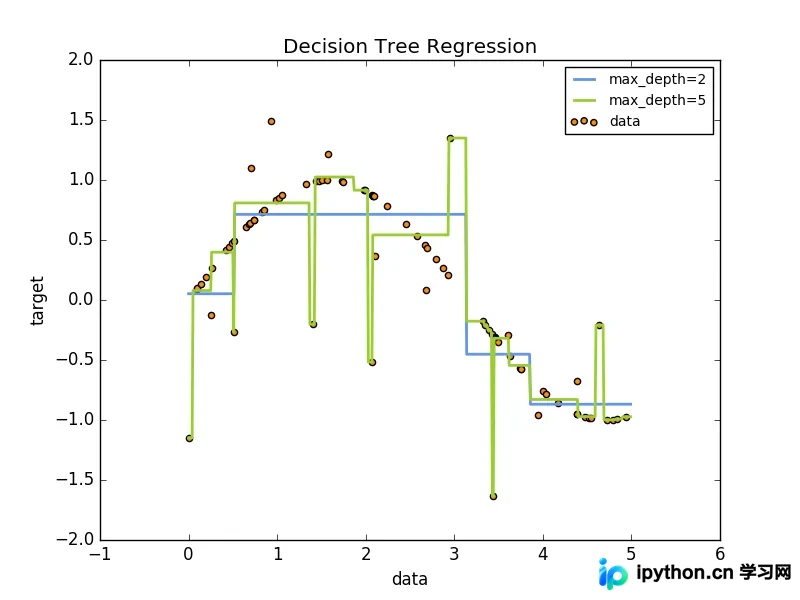
例如,在相关示例中,决策树通过一组if-then-else规则从数据中学习并近似正弦曲线。随着树深度的增加,决策规则变得更为复杂,模型的拟合程度也随之提高。
决策树具有以下优势:
- 易于理解和解释,决策树可以以可视化的方式呈现;
- 数据准备需求极少。相比之下,其他技术通常需要对数据进行标准化处理,创建虚拟变量,并剔除缺失值。
- 训练决策树的时间成本与数据点数量的对数成正比。
- 能够同时处理数值型和分类型数据。其他许多技术往往仅针对单一变量类型的数据集进行分析。
- 支持多输出问题的处理。
- 采用白盒模型。若某种情况在模型中可被观测到,其解释可通过布尔逻辑清晰表达。相比之下,黑盒模型(如人工神经网络)的结果往往难以解释。
- 可通过统计测试验证模型,从而评估模型的可靠性。
- 即使生成数据的真实模型在某种程度上违反了假设,决策树仍能表现良好。
决策树也存在一些缺点:
- 决策树学习可能生成过于复杂的树,无法代表普遍规律,这被称为过拟合。为避免此问题,必须采取修剪机制(目前尚不支持)、设置叶节点所需的最小样本数或限制树的最大深度。
- 决策树可能不稳定,数据中的微小变化可能导致生成完全不同的树。通过在集合中使用多个决策树可以缓解这一问题。
- 实际的决策树学习算法基于启发式方法,例如在每个节点进行局部最优决策的贪婪算法。这种算法无法保证返回全局最优决策树。通过在集合学习者中训练多棵树,并对特征和样本进行随机抽取,可以减少这种情况。
- 某些概念难以学习,因为决策树难以直接表达,例如XOR、奇偶性或复用问题。
决策树分类器应用
分类
决策树分类器(DecisionTreeClassifier)是一个能够在数据集上执行多类分类的类。
与其他分类器类似,决策树分类器接收两个数组作为输入:数组X(稀疏或密集),[n_samples,n_features],保存训练样本;以及数组Y(整数值),[n_samples],保存训练样本的类别标签:
>>> from sklearn import tree
>>> X = [[0, 0], [1, 1]]
>>> Y = [0, 1]
>>> clf = tree.DecisionTreeClassifier()
>>> clf = clf.fit(X, Y)
模型可用于预测样本的类别:
>>> clf.predict([[2., 2.]])
array([1])
或者,可以预测每个类别的概率,即叶节点中属于同一类别的训练样本的比例。
>>> clf.predict_proba([[2., 2.]])
array([[ 0., 1.]])
DecisionTreeClassifier支持二元分类(标签为[-1, 1])和多类分类(标签为[0, ..., k-1])。
使用虹膜数据集,我们可以构建如下决策树:
>>> from sklearn.datasets import load_iris
>>> from sklearn import tree
>>> iris = load_iris()
>>> clf = tree.DecisionTreeClassifier()
>>> clf = clf.fit(iris.data, iris.target)
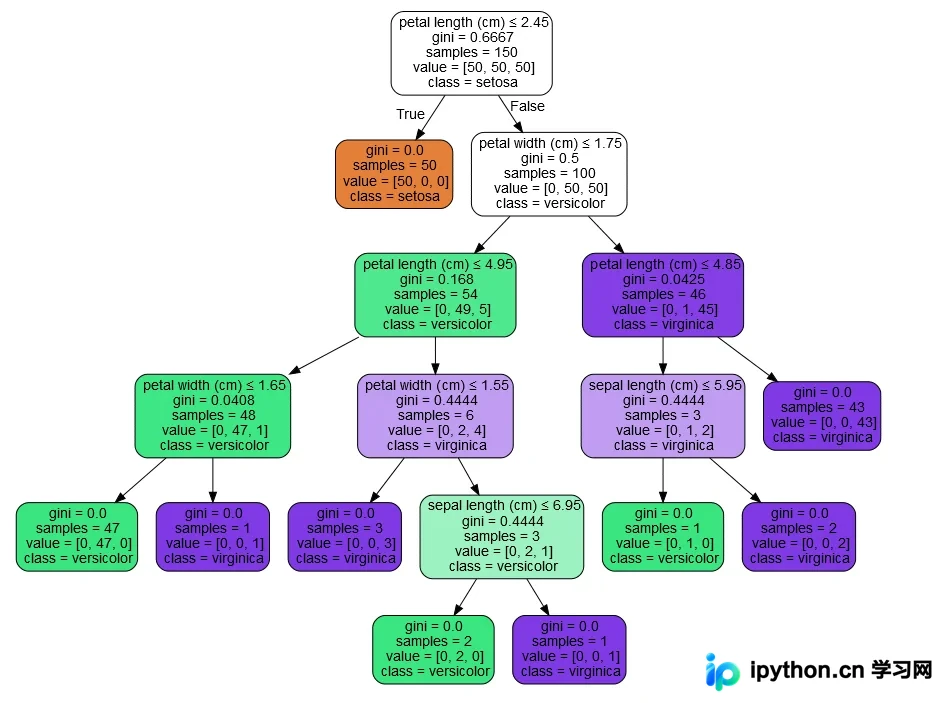
训练完成后,可以使用export_graphviz将树导出为Graphviz格式。以下是在整个iris(虹膜)数据集上输出的树示例:
>>> with open("iris.dot", 'w') as f:
...   f = tree.export_graphviz(clf, out_file=f)
随后,我们可以使用Graphviz的dot工具生成PDF文件(或其他支持的文件类型):dot -Tpdf iris.dot -o iris.pdf
>>> import os
>>> os.unlink('iris.dot')
或者,如果已安装Python模块pydotplus,可以直接在Python中生成PDF文件(或其他支持的文件类型):
>>> import pydotplus
>>> dot_data = tree.export_graphviz(clf, out_file=None)
>>> graph = pydotplus.graph_from_dot_data(dot_data)
>>> graph.write_pdf("iris.pdf")
export_graphviz还支持多种选项,包括根据类别(或回归值)对节点进行着色,以及使用显式的变量和类别名称。IPython还可以使用Image()函数来显示这些图表:
>>> from IPython.display import Image
>>> dot_data = tree.export_graphviz(clf, out_file=None,
             feature_names=iris.feature_names,
             class_names=iris.target_names,
             filled=True, rounded=True,
             special_characters=True)
>>> graph = pydotplus.graph_from_dot_data(dot_data)
>>> Image(graph.create_png())
模型可用于预测样本的类别:
>>> clf.predict(iris.data[:1, :])
array([0])
或者,可以预测每个类别的概率,即叶节点中属于同一类别的训练样本的比例:
>>> clf.predict_proba(iris.data[:1, :])
array([[ 1., 0., 0.]])
Examples:
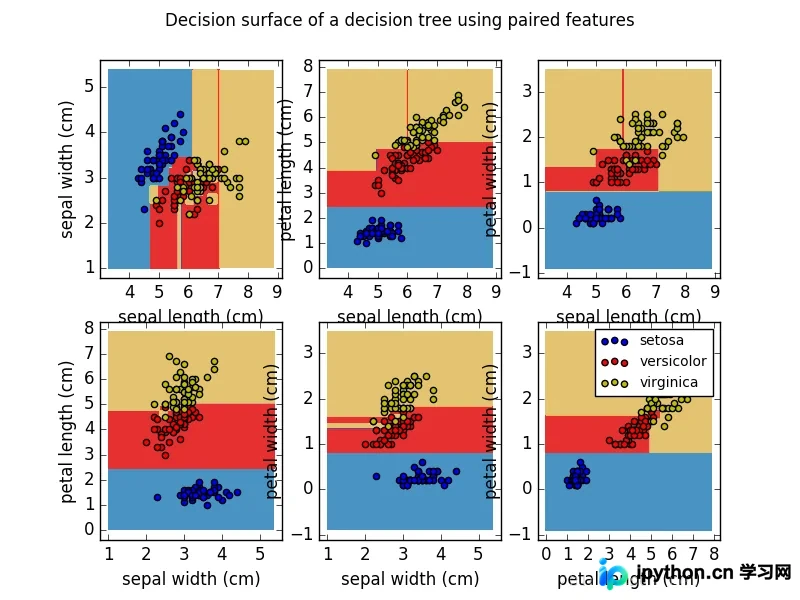
Plot the decision surface of a decision tree on the iris dataset
决策树回归应用
回归
利用决策树类回归,决策树也可应用于回归问题。
在分类设置中,fit方法将数组X和y作为参数;在此情况下,y期望包含浮点值而非整数值:
>>> from sklearn import tree
>>> X = [[0, 0], [2, 2]]
>>> y = [0.5, 2.5]
>>> clf = tree.DecisionTreeRegressor()
>>> clf = clf.fit(X, y)
>>> clf.predict([[1, 1]])
array([ 0.5])
Examples:
Decision Tree Regression
多输出问题处理策略
多输出问题
多输出问题是指有多个输出需要预测的监督学习问题,即当Y是一个二维数组[n_samples,n_output]时。
当输出之间没有相关性时,解决此类问题的一个简单方法是建立n个独立模型(每个输出一个),然后独立使用这些模型预测每个输出。
然而,由于与相同输入相关的输出值本身可能存在相关性,通常更好的方法是构建一个能够同时预测所有n输出的单一模型。首先,这降低了训练时间,因为只需构建一个估计量。其次,结果估计量的泛化精度通常会提高。
对于决策树,该策略可轻松用于支持多输出问题。这需要以下更改:
- 在叶节点中存储n个输出值,而非1个;
- 使用分割标准来计算所有n输出的平均下降。
该模块提供了支持多输出问题的方法,通过DecisionTreeClassifier和DecisionTreeRegressor实现此策略。
如果决策树拟合大小为n_samples,n_output的输出数组Y,则得到的估计值将是:
- 预测输出的n_output个值;
- 在
predict_proba上输出n_output个类别的概率数组。
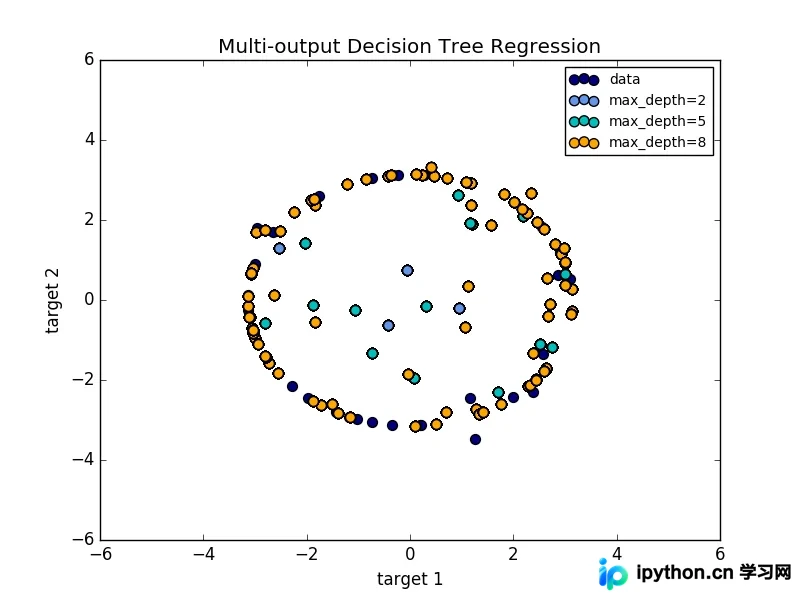
多输出决策树回归展示了多输出树的回归应用。在此示例中,输入X是一个单一的实际值,输出Y是X的正弦和余弦。
Examples:
决策树多输出回归
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数据结构与算法教程》、《Python加密解密算法与技巧总结》、《Python编码操作技巧总结》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》
希望本文所述对大家Python程序设计有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









