Jupyter Notebook 快速入门指南:从安装到核心功能详解
本文详细介绍 Jupyter Notebook 的安装、启动及核心操作。涵盖 Anaconda 与 pip 安装方法,解析 Notebook 架构与内核机制,演示代码与 Markdown 单元格使用,并深入讲解 Magic 命令及常用快捷键,帮助数据爱好者高效进行数据挖掘与建模。
2026-10-13
7


本文详细介绍 Jupyter Notebook 的安装、启动及核心操作。涵盖 Anaconda 与 pip 安装方法,解析 Notebook 架构与内核机制,演示代码与 Markdown 单元格使用,并深入讲解 Magic 命令及常用快捷键,帮助数据爱好者高效进行数据挖掘与建模。
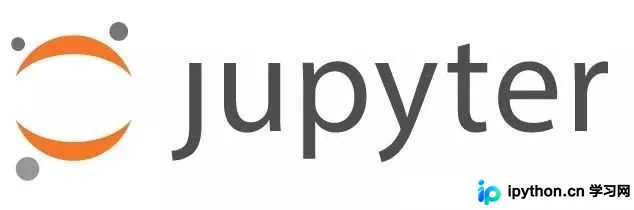
本文详解 Jupyter Notebook 中用于内嵌绘图的魔法函数 %matplotlib inline。该函数允许图表直接显示在代码单元格下方,无需调用 plt.show()。文章介绍了行级与单元级魔法函数的区别,并指出其在 PyCharm 等非 IPython 环境中不可用,适用于机器学习二维数据可视化场景。
本文详细介绍在Linux服务器环境下搭建Python多版本管理、配置Jupyter Notebook远程访问以及集成PySpark进行Web端Spark开发的完整流程。内容涵盖使用pythonbrew管理Python版本、生成SSL证书与密码以安全远程连接Jupyter,以及配置环境变量启动pyspark-jupyter,助力数据分析师实现高效、优雅的远程编程体验。
数据科学场景中常需自动化生成包含代码、Markdown及执行结果的交互文档。本文演示如何使用 nbformat 和 nbconvert 库通过 Python 脚本创建 Notebook 对象,配置单元格属性与模拟输出,最终将其稳定导出为可展示的 HTML 文件或可直接打开的 .ipynb 格式文件。
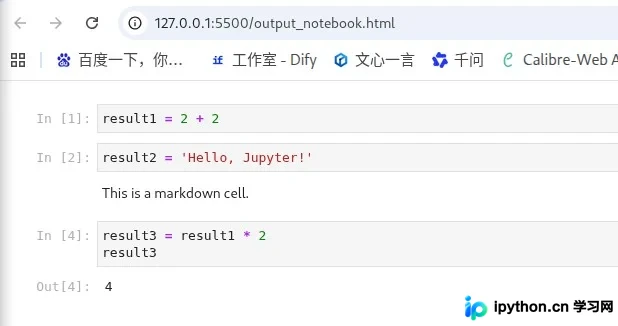
本文解析选择Python进行数据分析的五大核心优势,包括丰富的库生态、跨语言集成能力及持续创新的算法实现。同时详细指导如何配置Anaconda环境,通过命令行启动Jupyter Notebook服务,并介绍Cell操作、Markdown转换及多IDE集成等关键实操步骤,帮助开发者快速搭建高效的数据分析工作流。
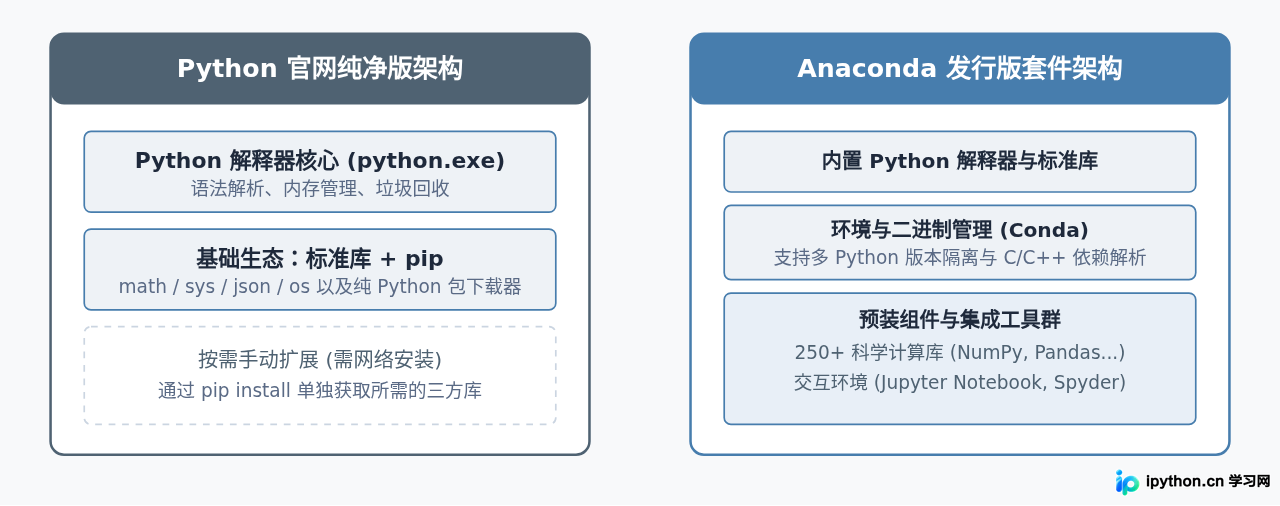
全面对比Python官方纯净版与Anaconda发行版的区别,从核心构成、包管理机制到磁盘占用,并为不同学习路线的新手提供具体的选择标准与安装验证步骤。
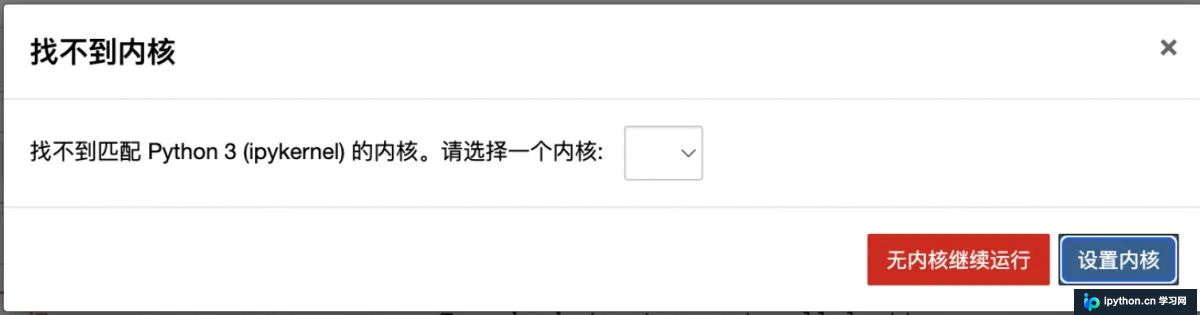
本文详细介绍如何在 Jupyter Notebook 中配置自定义 Python 解释器。通过修改 kernel.json 文件,将默认解释器指向特定的虚拟环境路径,实现多版本 Python 的管理。文中还涵盖了配置过程中可能遇到的 ipykernel 缺失报错及日志排查方法,确保环境稳定运行。
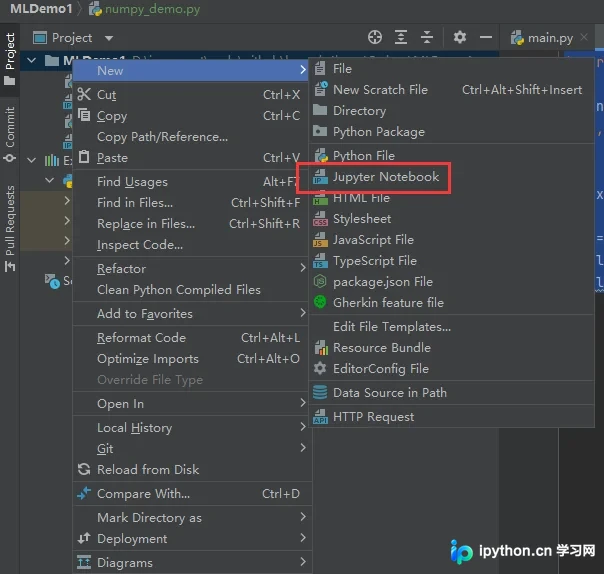
本文详细介绍如何在PyCharm中配置远程Jupyter Notebook环境。通过创建.ipynb文件并配置远程服务器URL与Token,可解决CreateProcess失败等常见报错。文章还分享了密钥拼接注意事项、后台启动命令及无Token模式的备用方案,帮助开发者高效搭建远程Python开发环境。
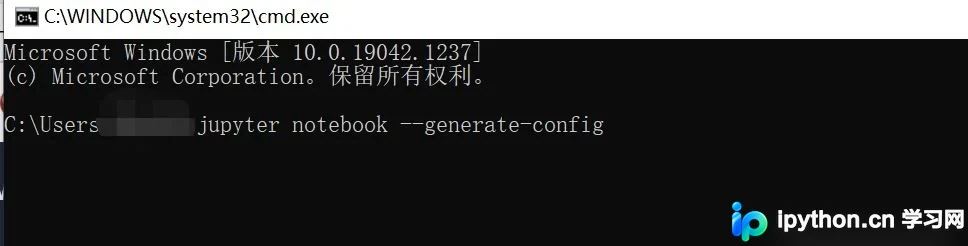
本文详细解决Jupyter Notebook启动后点击Launch无反应或无法自动打开浏览器的问题。核心步骤包括生成配置文件、修改jupyter_notebook_config.py指定浏览器路径,以及配置系统环境变量。若遇到内核忙或代码无响应,可参考相关进阶排查文章。
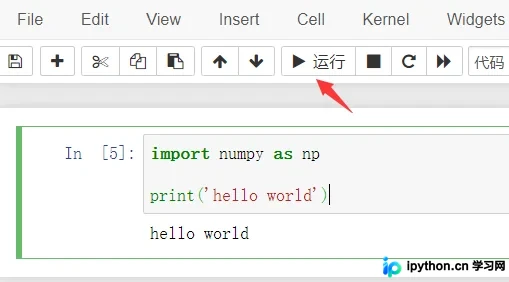
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。
本文详细讲解在Windows环境下安装Anaconda3的完整步骤,涵盖从下载安装包到完成安装的界面操作。重点介绍如何创建和激活Python虚拟环境,并将自定义环境注册至Jupyter Notebook。此外,提供修改Jupyter默认启动浏览器及指定工作目录的配置文件修改方法,帮助用户快速搭建本地数据科学开发环境。
本文详细介绍如何解决 Jupyter Notebook 启动后不自动弹出网页的问题。通过生成配置文件、修改浏览器路径设置,即可实现自动打开指定浏览器。