

Python XPath提取HTML片段并解决中文乱码问题

本文介绍如何使用Python的lxml库通过XPath定位HTML文档中的特定元素,并解决提取内容中出现的中文乱码问题。通过html.tostring获取字节流后,利用HTMLParser.unescape方法将HTML实体编码转换为可读字符串,从而完整保留原始文本内容。
XPath定位HTML元素
在某些场景下,我们需要从HTML文档中提取特定区域的文本内容,例如从网页结构中抓取指定模块的数据。
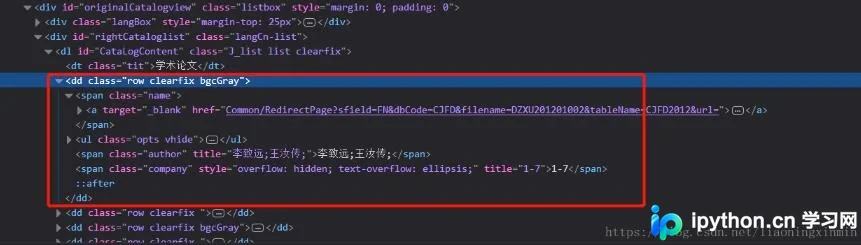
若要获取包含特定属性的HTML节点(如dd标签),首先需通过其属性值(例如class='row clearfix ')确定节点位置,随后使用XPath语法定位并提取该部分HTML结构。
name = tree.xpath("//dd[@class='row clearfix ']")
from lxml import html
import requests
url = 'http://navi.cnki.net/knavi/JournalDetail/GetArticleList?year=2018&issue=04&pykm=DZXU&pageIdx=0&pcode=CJFD'
res = requests.get(url)
tree = html.fromstring(res.text)
name = tree.xpath("//dd[@class='row clearfix ']")
print(name)
直接打印XPath查询结果通常无法获得预期的字符串格式,而是返回元素对象列表。

提取HTML字节流
为了获取具体的HTML代码,需对提取到的Element对象进行处理。可以使用html.tostring方法将节点转换为字节串,例如name1 = html.tostring(name[0]),具体实现参考以下代码。
from lxml import html
import requests
url = 'http://navi.cnki.net/knavi/JournalDetail/GetArticleList?year=2018&issue=04&pykm=DZXU&pageIdx=0&pcode=CJFD'
res = requests.get(url)
tree = html.fromstring(res.text)
name = tree.xpath("//dd[@class='row clearfix ']")
name1 = html.tostring(name[0])
print(name1)
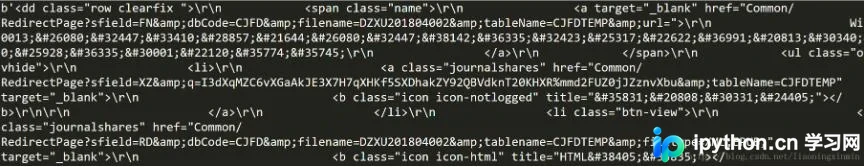
执行上述代码后的输出结果如下图所示。
处理中文乱码与实体解码
观察打印结果会发现,其中的中文内容可能显示为乱码或特殊符号。这是因为html.tostring方法输出的是经过修正的HTML代码,且返回类型为bytes。在Python中,bytes类型无法直接进行常规编码处理,必须将其转换为字符串类型,可通过name1.decode()实现从bytes到str的转换。
此时关键问题是如何将类似$#26080;的符号还原为汉字。首先需要明确,这类符号属于HTML或XML等SGML语言中的转义序列(实体编码),并非字符编码格式,因此不能直接使用utf-8或gbk等编码方式处理。正确的做法是使用HTMLParser进行解析,完整代码示例如下。
from lxml import html
import requests
from html.parser import HTMLParser #导入html解析库
url = 'http://navi.cnki.net/knavi/JournalDetail/GetArticleList?year=2018&issue=04&pykm=DZXU&pageIdx=0&pcode=CJFD'
res = requests.get(url)
tree = html.fromstring(res.text)
name = tree.xpath("//dd[@class='row clearfix ']")
name1 = html.tostring(name[0])
name2 = HTMLParser().unescape(name1.decode())
print(name2)
运行上述修正后的代码,最终输出结果如下图所示。
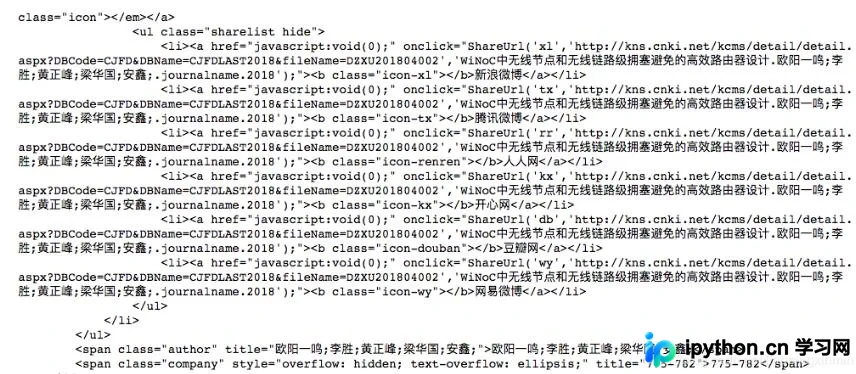
至此,成功实现了HTML指定部分的提取及中文内容的正确显示。
以上关于使用Python XPath获取HTML文档部分内容及处理编码问题的教程到此结束,希望能为读者提供有价值的参考。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









