

Python爬虫实战:BeautifulSoup库解析与遍历全指南
本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
2026-10-15
3

本文详解Python中BeautifulSoup库的核心用法,涵盖从安装配置到解析器选择(html.parser、lxml等)。深入解析Tag、NavigableString、Comment三大基本元素,系统讲解下行、上行及平行遍历技巧,并演示如何利用find_all结合正则表达式精准提取网页数据,助力爬虫开发入门。
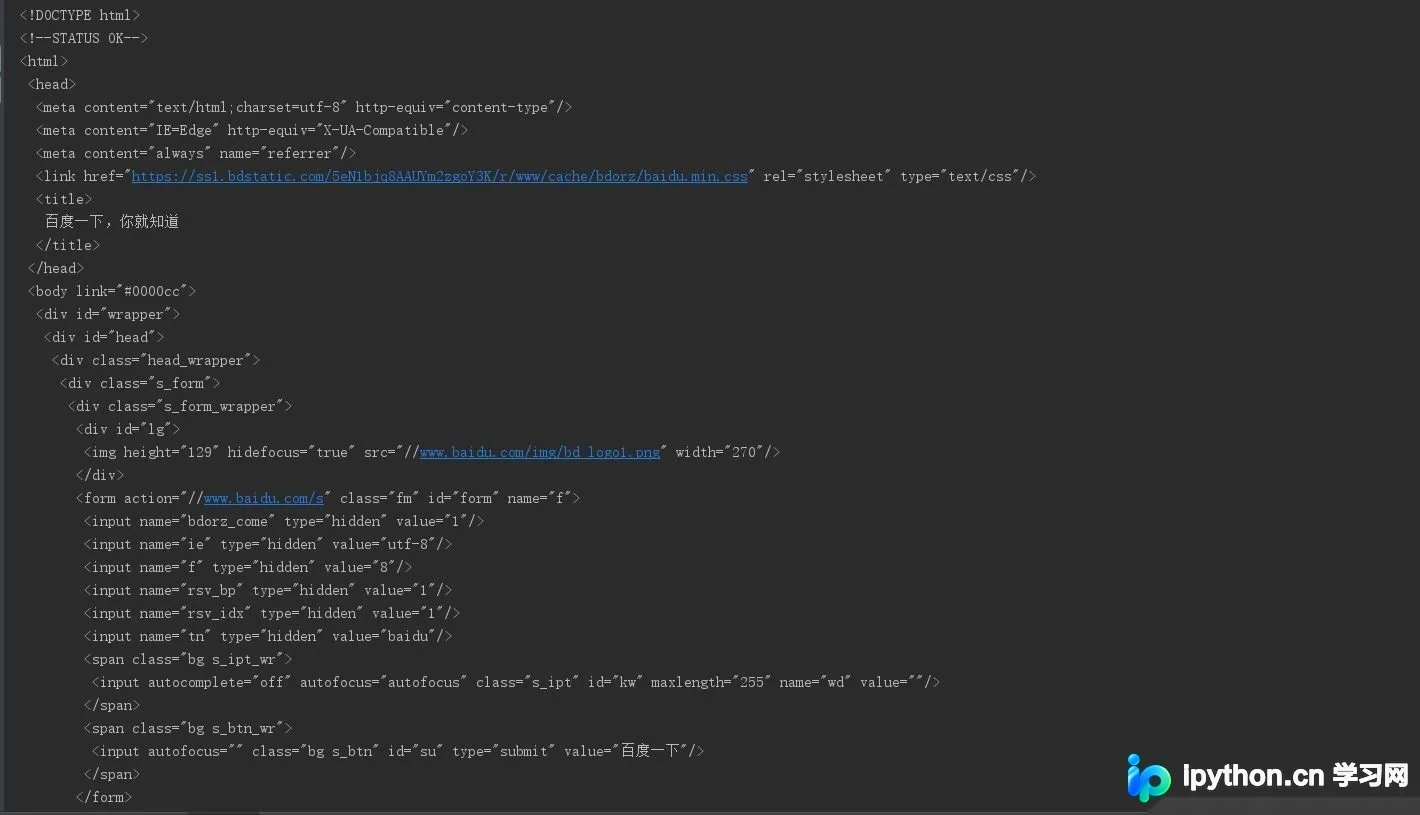
在HTML中使用锚点链接时,默认的href="#"会导致页面滚动至顶端。本文对比分析了javascript:void(0)、####、空字符串及return false等常见解决方案的优缺点,重点推荐结合onclick事件与return false的最佳实践,以提升用户体验并避免浏览器兼容性问题。
本文提供了一套完整的PHP正则表达式,用于将包含HTML标签、JavaScript代码及特殊实体的字符串快速转换为纯净文本。通过移除无关脚本与标记、清理空白字符并还原常见HTML实体,实现高效的文本清洗操作。
本文详细汇总了Python下载网络图片的多种方法,涵盖从已知URL直接下载到通过正则表达式和BeautifulSoup解析HTML获取链接的批量处理技巧。针对动态网页和反爬机制,提供了User-Agent模拟、Referer设置、IP池及Cookie管理等解决方案,并介绍了Selenium动态加载与Pyautogui模拟点击等进阶策略,帮助开发者高效完成图片抓取任务。
本文介绍 JavaScript 中的 void 运算符。它用于计算表达式并丢弃返回值,常被设为链接的 href 属性以阻断页面跳转,从而在点击时仅执行 onclick 事件逻辑。相比使用 #,void(0) 可避免浏览器自动滚动至顶部的问题,是前端开发中常用的技巧。
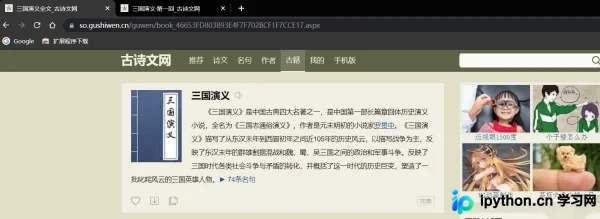
本文详细介绍Python中数据解析的概念,重点讲解BeautifulSoup库的安装与核心用法。通过实例演示如何利用BeautifulSoup定位HTML标签、提取文本内容及属性值,并完整展示爬取三国演义章节及内容的Python代码实现过程。
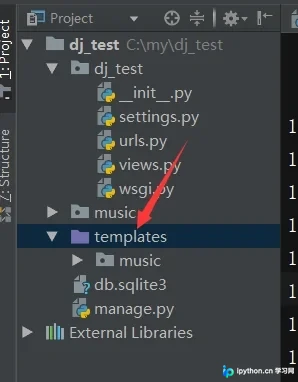
本文介绍Django中调用HTML前端页面的基础方法。重点讲解render函数的使用、templates目录的创建与配置,以及views.py和urls.py的具体实现步骤,帮助初学者快速掌握Django模板渲染流程。
本文详解Python中BeautifulSoup库的基本用法,重点介绍如何通过html.parser读取本地HTML文件。内容涵盖使用select方法结合标签名与class属性(如div下的span)进行元素定位,以及利用find方法提取特定属性值。文章通过具体代码示例展示了如何获取ResultSet类型结果,帮助开发者快速掌握网页数据抓取的核心技巧。
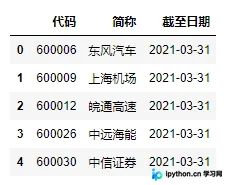
本文介绍如何利用Python Pandas库中的to_html()函数,将Excel表格数据直接转换为HTML格式。通过读取Excel文件并调用相关方法,可生成包含标准HTML标签的网页表格,支持自定义标题、索引及对齐方式等参数,适用于无需复杂前端知识即可快速生成数据展示页面的场景。
在PHP开发中,去除字符串中的HTML标签是常见需求。本文介绍三种实现方式:使用内置函数strip_tags直接移除所有标签、通过str_replace针对性替换特定标签,以及利用strtr函数进行字符映射转换。解析各方法的语法、适用场景及代码示例,帮助开发者根据实际需求选择最高效的方案。
本文介绍如何使用原生JavaScript和CSS实现简单的伸缩式(手风琴)导航菜单。通过切换子菜单的CSS class名来显示或隐藏内容,利用DOM事件监听父级链接的点击行为。这种方法不依赖任何第三方库,适合学习前端基础交互逻辑。
本文介绍如何通过 JavaScript 代码禁用浏览器默认的鼠标右键菜单。主要方法是重写 document.oncontextmenu 事件并返回 false,从而阻止上下文菜单弹出。该方法适用于需要自定义交互或防止内容被轻易复制的场景。