

Python深度学习入门:逻辑回归的局限性与神经网络基础

本文介绍Python深度学习入门知识,首先分析逻辑回归在非线性分类中的局限性,引出特征转换与多层逻辑回归的概念。随后阐述神经网络的基本结构、全连接机制及矩阵运算方式,并详解交叉熵损失函数的计算原理,帮助初学者理解深度学习核心逻辑。
1.逻辑回归的限制
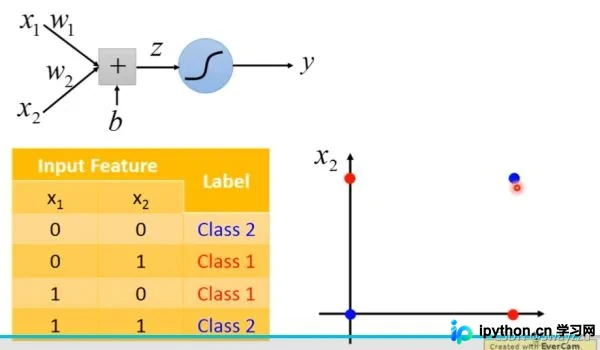
在逻辑回归分类任务中,模型将线性函数的输出输入到Sigmoid函数中进行转换,从而得出分类结果,并在特征空间内绘制出一条线性分类边界。然而,如图所示的情况表明,对于某些非线性可分的数据分布,无论怎样调整参数,单一直线都无法将其完全正确分开。
但如果我们对输入特征进行适当的变换,则有可能实现完美分类。例如:
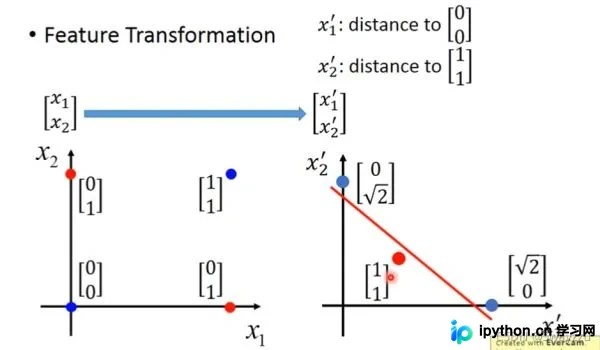
我们可以构造两个新特征:x1表示样本点到原点(0,0)的欧氏距离,x2表示样本点到点(1,1)的欧氏距离。利用这两个新特征重新计算四个样本点的值,并绘制在坐标系中(见右图)。经过这种非线性变换后,原本线性不可分的数据变得线性可分,此时再输入逻辑回归模型即可实现完全分类。
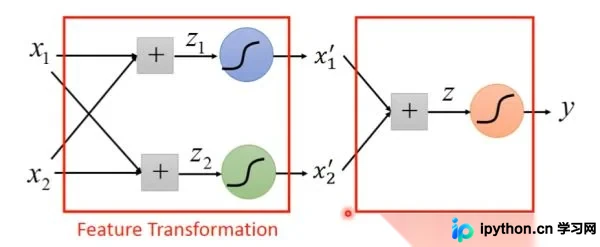
虽然直接寻找这种特征转换标准较为困难,但我们可以利用逻辑回归自动学习这些标准。具体做法是:使用第一个逻辑回归模型学习第一个转换后的参数x1,再使用第二个逻辑回归模型学习第二个转换后的参数x2。将这两个新特征作为输入,送入第三个逻辑回归模型,即可完成分类任务。
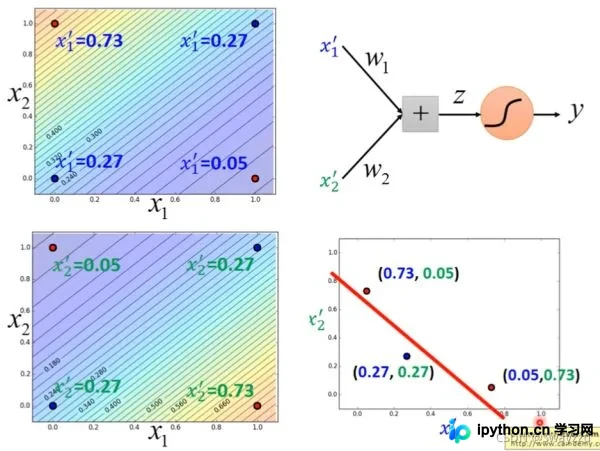
因此,通过调整参数,我们可以使输入的x1和x2分别对应属于两类的概率(即0到1之间的数值,暂称为概率)。如下图所示,左上角的点属于第一类的概率为0.73,属于第二类的概率为0.05。同理,其他各点也拥有各自属于两类的概率值。将这些概率值映射到坐标轴上,即完成了对原始特征的转换。将转换后的结果作为输入,送入新的逻辑回归模型,即可完成分类。
2.深度学习的引入
可以看出,每一个逻辑回归单元既可以是接收者,接收输入数据;也可以是发送者,将其输出结果作为其他逻辑回归单元的输入。
多个逻辑回归单元相互交织连接,即构成神经网络,其中每一个逻辑回归单元对应一个神经元。这种学习机制被称为深度学习。
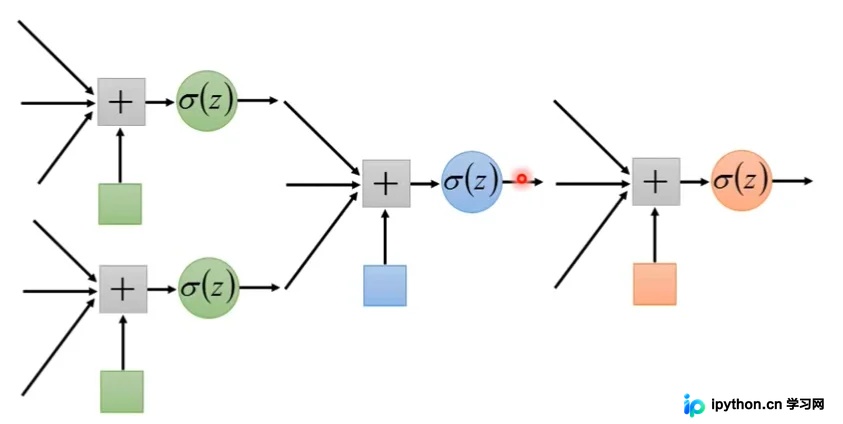
以下是一个具体示例:
假设初始输入数据为1和-1,且已知所有权重参数。例如,两个输入数据到第一层两个神经元的权重分别为1、-1、-2和1。通过Sigmoid函数转换后,计算得到的输出分别为0.98和0.12。同理,若已知后续所有权重(参数),我们最终可以得到两个输出值:0.62和0.83。
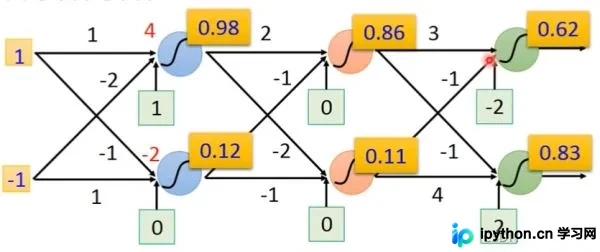
当初始输入数据为0和0时,通过相同的转换过程,可以得到输出0.51和0.85。由此可见,无论输入数据如何,我们总能够通过一系列参数调整,进行多次转换,最终输出特征截然不同的数据。
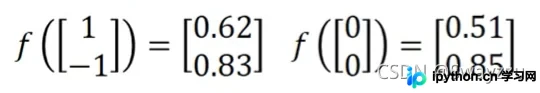
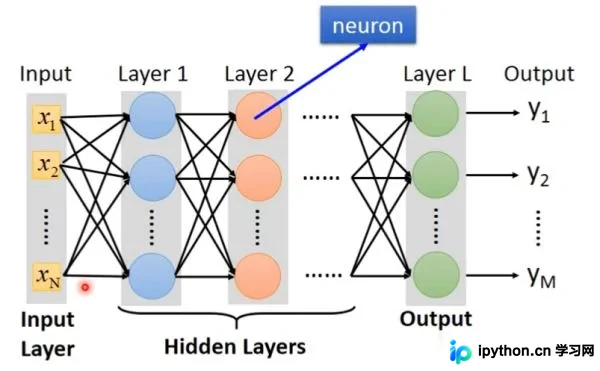
因此,整个网络可以视为一个复杂的函数。更一般地,如下图所示,每个圆圈代表一个神经元。最前端的输入层称为输入层,末端未连接任何神经元的层称为输出层,中间所有层称为隐藏层。如图中所示,若每个神经元都连接到下一层的所有神经元,则称为全连接神经网络。
3.深度学习的计算方式
在深度学习中,通常采用矩阵运算来进行高效计算。
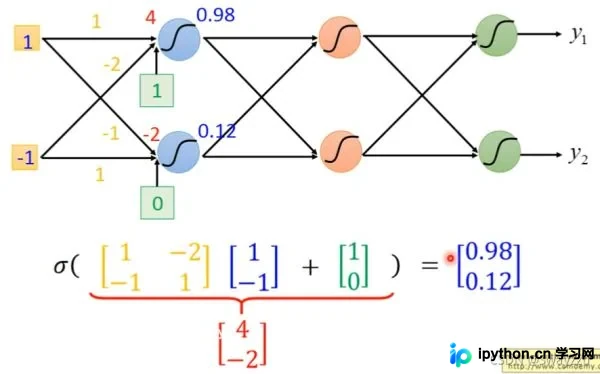
更一般地:
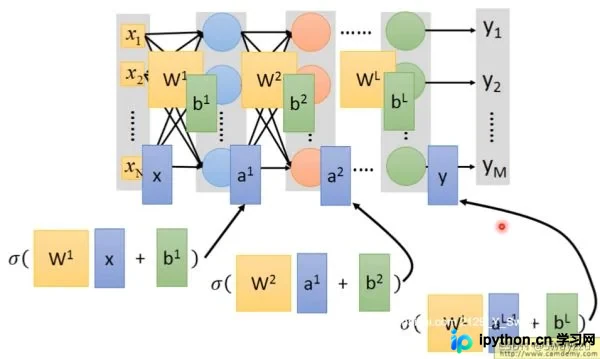
即上一层的参数乘以该层输入的数值,再加上偏置项,最后对整体结果进行Sigmoid函数转换,即可输出本层数据供下层使用。所有神经元均执行相同的操作,直至输出层。
4.神经网络的损失函数
对于单个样本,其损失函数如下图所示:
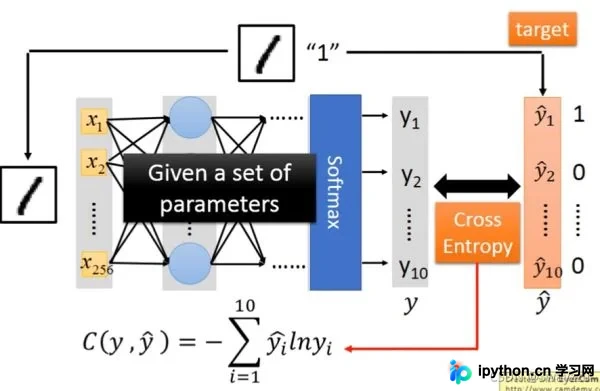
例如,输入样本“1”,包含256个像素点,即256个特征。将其输入神经网络后,最终输出为一个10维向量,每个维度对应一个概率值。例如,“1”的概率为0.8,“2”的概率为0.1等。而实际标签为“1”,即只有y1_hat为1,其余为0。将预测概率向量与真实标签向量计算交叉熵并求和(如上图公式所示),所得C即为该样本的损失值。
对于整体数据集,只需将所有样本的损失值计算出来并求和即可。
以上就是Python人工智能深度学习入门中关于逻辑回归限制与神经网络基础的详细内容,更多关于Python人工智能逻辑回归限制的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









