

深入解析卷积神经网络(CNN):从基础原理到结构优化

本文系统解析卷积神经网络(CNN)的核心机制,涵盖局部连接、权值共享及池化降采样等关键概念。详细阐述CNN标准结构组件,包括卷积层、ReLU激活与全连接层的组合策略,并深入探讨通过小滤波器组合、零填充及合理步长设置来大幅减少参数量、防止过拟合并提升模型泛化能力的具体实践方法。
一、卷积神经网络的概述
卷积神经网络(Convolutional Neural Network,CNN)最初旨在解决图像识别任务,如今其应用范围已扩展至视频、时间序列信号(如音频)及文本数据等领域。CNN作为深度学习架构的核心诉求之一,是降低对图像数据预处理的依赖,避免复杂的人工特征工程。在CNN中,首个卷积层直接接收像素级输入,每一层卷积(滤波器)负责提取数据中最有效的特征。这种机制能够提取图像的基础特征,并通过后续的组合与抽象形成高阶特征。因此,CNN在理论上具备对图像缩放、平移和旋转的不变性。
卷积神经网络(CNN)的核心要点包括局部连接(Local Connection)、权值共享(Weights Sharing)以及池化层(Pooling)中的降采样(Down-Sampling)。局部连接与权值共享显著降低了参数量,从而大幅降低训练复杂度并减轻过拟合风险。同时,权值共享赋予卷积网络对平移操作的容忍性,而池化层的降采样进一步减少了输出参数量,增强了模型对轻度形变的容忍度,进而提升了模型的泛化能力。可以将卷积层的操作理解为利用少量参数在图像多个位置提取相似特征的过程。
卷积层的空间排列涉及输出数据体中神经元的数量及其排列方式,由三个超参数控制:深度(depth)、步长(stride)和零填充(zero-padding)。首先,输出数据体的深度是一个超参数,与使用的滤波器数量一致,每个滤波器在输入数据中寻找不同的特征。其次,滑动滤波器时需指定步长。有时需在输入数据体边缘用0进行填充,零填充的尺寸也是一个超参数。零填充的一个显著优势是可以控制输出数据体的空间尺寸,最常用的是保持输入数据体在空间上的尺寸,使输入和输出的宽高相等。输出数据体的空间尺寸可通过输入数据体尺寸(W)、卷积层中神经元的感受野尺寸(F)、步长(S)和零填充数量(P)的函数计算得出(假设输入数组空间形状为正方形,即高度和宽度相等)。公式为:(W - F + 2P) / S + 1。在计算上,输入数据体的长和宽按此公式计算,深度则取决于滤波器数量。需注意这些空间排列超参数之间的相互限制。例如,当输入尺寸W=10,不使用零填充(P=0),滤波器尺寸F=3时,若步长S=2,则结果为4.5而非整数,这意味着神经元无法整齐对称地滑过输入数据体,因此该配置不可行。
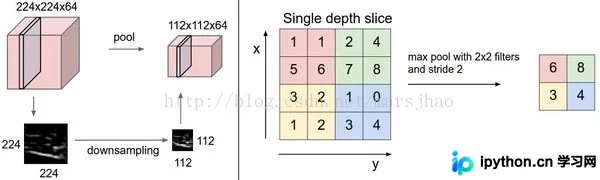
汇聚层使用MAX操作,对输入数据体的每一个深度切片独立进行操作,以改变其空间尺寸。最常见的形式是使用尺寸为2x2的滤波器,以步长为2对每个深度切片进行降采样,从而丢弃其中75%的激活信息。每个MAX操作是从4个数字中取最大值(即在深度切片中的某个2x2区域)。此操作保持深度不变。
二、卷积神经网络的结构
卷积神经网络通常由三种层构成:卷积层、汇聚层(除非特别说明,一般指最大值汇聚)和全连接层(fully-connected,简称FC)。ReLU激活函数也应被视为一层,它逐元素地进行激活函数操作。
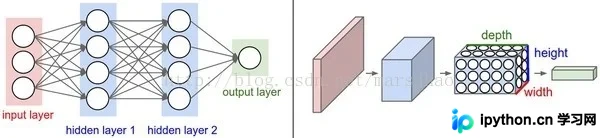
卷积神经网络最常见的形式是将若干卷积层和ReLU层组合在一起,随后紧跟汇聚层,并重复此过程,直到图像在空间上缩小至足够小的尺寸。在某个阶段过渡到全连接层也是常见做法。最后的全连接层生成输出,例如分类评分等。
最常见的卷积神经网络结构如下:
INPUT -> [[CONV -> RELU]*N ->POOL?]*M -> [FC -> RELU]*K -> FC
其中*代表重复次数,POOL?表示可选的汇聚层。通常N >=0,且N<=3;M>=0,K>=0,且通常K<3。
组合使用几个小滤波器卷积层优于使用一个大滤波器卷积层。直观而言,选择带有小滤波器的卷积层组合比使用带有大滤波器的单层卷积层更佳。前者能够表达输入数据中更多强有力的特征,且使用的参数更少。唯一的缺点是,在反向传播过程中,中间的卷积层可能会占用更多内存。
输入层(包含图像的)尺寸应能被2整除多次。常用数字包括32(如CIFAR-10)、64、96(如STL-10)或224(如ImageNet卷积神经网络)、384和512。
卷积层应使用小尺寸滤波器(如3x3或最多5x5),并采用步长S=1。这一点非常重要:对输入数据进行零填充,以确保卷积层不会改变输入数据在空间维度上的尺寸。通常对于任意滤波器尺寸F,当P=(F-1)/2时能保持输入尺寸。如果必须使用更大的滤波器尺寸(如7x7等),通常仅应用于第一个面对原始图像的卷积层。
汇聚层负责对输入数据的空间维度进行降采样,从而提升模型对畸变的容忍能力。最常用的设置是使用感受野为2x2的最大值汇聚,步长为2。需注意,此操作将丢弃输入数据中75%的激活数据(因为对宽度和高度都进行了2倍降采样)。另一种较少使用的设置是使用感受野为3x3、步长为2的配置。最大值汇聚的感受野尺寸很少超过3,因为汇聚操作过于激烈,容易造成数据信息丢失,这通常会导致算法性能下降。
三、CNN最大的特点在于卷积的权值共享(参数共享),可以大幅度减少神经网络的参数数量,防止过拟合的同时又降低了神经网络模型的复杂度。如何理解?
假设输入图像尺寸为1000*1000且为灰度图像(即只有一个颜色通道),则一张图片包含100万个像素点,输入维度为100万。若采用全连接层(Fully Connected Layer,FCL),且隐含层与输入层大小相同(100万个隐含层节点),则会产生100万*100万=1万亿个连接,仅这一项就有1万亿个参数需要训练,这是不可想象的。考虑到人的视觉感受野概念,每个感受野只接受一小块区域的信号,每个神经元无需接收全部像素点信息,只需接收局部像素点作为输入,综合所有神经元接收的局部信息即可得到全局信息。因此,将全连接模式修改为局部连接,假设局部感受野大小为10*10,即每个隐含节点仅与10*10个像素点相连,则现在只需10*10*100万=1亿个连接,相比之前的1万亿已缩小10000倍。若假设局部连接方式为卷积操作,即默认每个隐含节点的参数完全相同,则参数数量将为10*10=100个。无论图像尺寸多大,均为这100个参数(即卷积核的尺寸),这就是卷积对减少参数量的贡献,也就是所谓的权值共享。通过增加卷积核数量来提取更多特征,每个卷积核滤波得到的图像即为某类特征的映射,即一个Feature Map。一般而言,在第一个卷积层使用100个卷积核已足够,此时我们有100*100=10000个参数,相比之前的1亿又缩小了10000倍。卷积的优势在于,无论图片尺寸如何,需要训练的参数数量仅与卷积核大小和数量有关。需要注意的是,尽管参数数量大幅下降,但隐含节点的数量并未下降,隐含节点数量仅与卷积的步长有关。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









