Java 9大性能优化经验总结:从代码到架构的实战指南
本文总结了Java高性能应用开发的9大核心优化经验。内容涵盖代码层面的细节调整、MySQL SQL语句与索引优化、分布式缓存(Redis)的高并发应对策略(如雪崩、穿透)、异步化处理解耦、Web前端资源加载优化、服务化拆分、硬件选型以及产品逻辑设计。旨在帮助开发者系统性提升系统响应速度与吞吐量。
2026-10-15
5

本文总结了Java高性能应用开发的9大核心优化经验。内容涵盖代码层面的细节调整、MySQL SQL语句与索引优化、分布式缓存(Redis)的高并发应对策略(如雪崩、穿透)、异步化处理解耦、Web前端资源加载优化、服务化拆分、硬件选型以及产品逻辑设计。旨在帮助开发者系统性提升系统响应速度与吞吐量。
MySQL使用ORDER BY RAND()进行随机查询会导致严重的性能问题,因为RAND()在排序过程中会被多次评估。本文通过对比测试发现,利用JOIN语法结合主键范围生成的子查询是最高效的方案,可在15万条数据的表中实现毫秒级响应。文中详细给出了包含MIN/MAX边界处理的完整SQL模板及性能数据。
在 SQL 查询中,JOIN 连接后的筛选条件放置位置不同会导致结果集显著差异。文章通过 LEFT JOIN 实例对比指出:写在 ON 后面的条件(如 AND)仅影响右表的匹配过程,左表未匹配行仍保留;而写在 WHERE 后的条件则对连接生成的完整临时表进行过滤,可能导致左表特有数据被移除。理解此逻辑是编写正确复杂查询的关键。
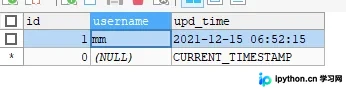
本文详解 MySQL 中 TIMESTAMP 类型 ON UPDATE CURRENT_TIMESTAMP 的自动更新时间机制。核心要点包括:仅当行数据发生实际变更时才会触发更新;MySQL 5.7 前后版本对默认值的处理差异及避坑指南;建表实例与索引优化建议,帮助开发者正确使用此特性并避免潜在陷阱。
针对MySQL大表执行ALTER TABLE导致服务中断和耗时过长的问题,本文介绍了两种常见运维策略及底层原理。重点阐述了如何利用.frm文件特性快速修改列默认值和枚举常量,通过创建影子表和交换定义文件实现无重建表操作,从而显著缩短变更时间并降低业务影响。
本文深入解析 MySQL 索引的分类(普通、唯一、主键、全文等)及底层存储原理,详细讲解 B-Tree 与 Hash 索引的区别。重点阐述多列索引的最左前缀匹配规则,并提供基于查询条件选择索引列、利用短索引和优化 SQL 语句的具体实践方法,帮助开发者提升数据库查询效率并降低写操作开销。
在处理MySQL数据库时,如何高效剔除重复数据是常见的SQL优化问题。本文详细解析并演示三种主流去重方案:适用于基础场景的DISTINCT语句、利用聚合逻辑的GROUP BY方法,以及针对复杂需求的窗口函数ROW_NUMBER()(含MySQL 8.0+与5.7及以下版本的差异写法)。通过真实代码示例帮助开发者选择最佳策略。
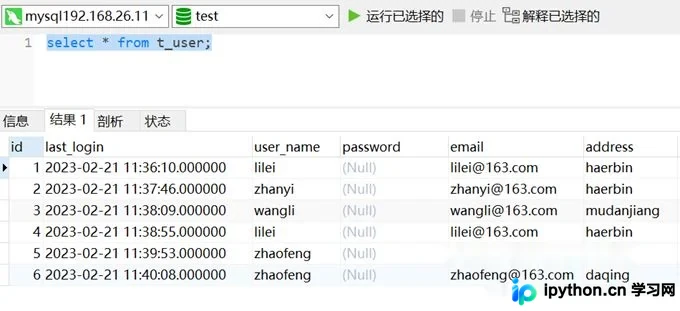
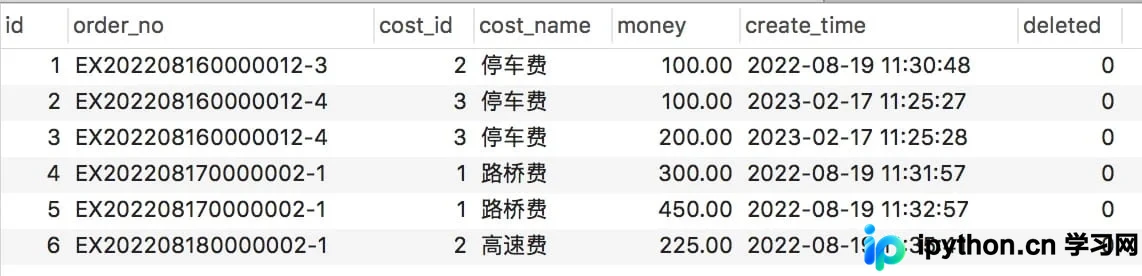
本文针对 MySQL 数据库中因业务 Bug 产生的重复脏数据,提供一种在保留“deleted”逻辑删除标记前提下,清理冗余记录并仅保留最新一条数据的方法。通过构建中间表规避 “You can't specify target table for update in FROM clause” 错误,实现高效的数据清洗。
本文深入解析MySQL索引的数据结构演变。从基础的全表扫描问题出发,探讨二叉搜索树、红黑树及B-Tree的局限性,重点阐述InnoDB引擎为何最终采用B+Tree作为索引结构,包括其叶子节点双向链表、磁盘IO优化及范围查询优势,帮助开发者理解索引底层逻辑以优化SQL性能。
深入解析 SQL Server 内存管理机制,涵盖虚拟内存体系结构、动态内存分配策略及缓冲区管理器工作原理。重点介绍 AWE 内存使用注意事项、从 2012 版本开始的任何大小页面分配器变化,以及针对长 I/O 请求的故障排查方法,帮助 DBA 优化系统性能。
本文深入解析Django数据库性能优化策略,涵盖使用QuerySet.explain()分析执行计划、合理创建索引以平衡查询速度与存储成本、利用select_related和prefetch_related减少N+1查询问题,以及通过bulk_create和bulk_update进行批量数据操作的最佳实践,帮助开发者显著提升应用响应速度。
本文深入解析 MySQL JOIN 的七种连接类型及其底层执行原理,重点对比 Simple、Index 和 Block Nested-Loop Join 三种算法的性能差异。通过 Explain 工具分析驱动表选择、索引使用及 Join Buffer 机制,提供建立索引、调整 buffer size、避免隐式转换等核心优化策略,助您写出高效 SQL。