MySQL全文索引优化:B树、默认FULLTEXT与n-gram实战对比
针对模糊查询性能问题,分析MySQL三种全文检索方案。无索引慢但零开销;B树索引无法匹配尾部通配符;默认FULLTEXT仅匹配完整词;n-gram支持子串搜索但存储成本高且受全局配置限制。本文通过100万数据测试对比各方案在读写性能、空间占用及维护上的优劣。
2026-10-16
5

针对模糊查询性能问题,分析MySQL三种全文检索方案。无索引慢但零开销;B树索引无法匹配尾部通配符;默认FULLTEXT仅匹配完整词;n-gram支持子串搜索但存储成本高且受全局配置限制。本文通过100万数据测试对比各方案在读写性能、空间占用及维护上的优劣。
本文整理了Oracle数据库中30条关键的SQL优化Hint语法,涵盖基于代价与规则的优化选择、全表与索引扫描策略、连接方式(嵌套循环、哈希、排序合并)以及视图合并与并行处理等。通过具体代码示例,解析如何精准控制执行计划以提升查询效率和数据插入速度。
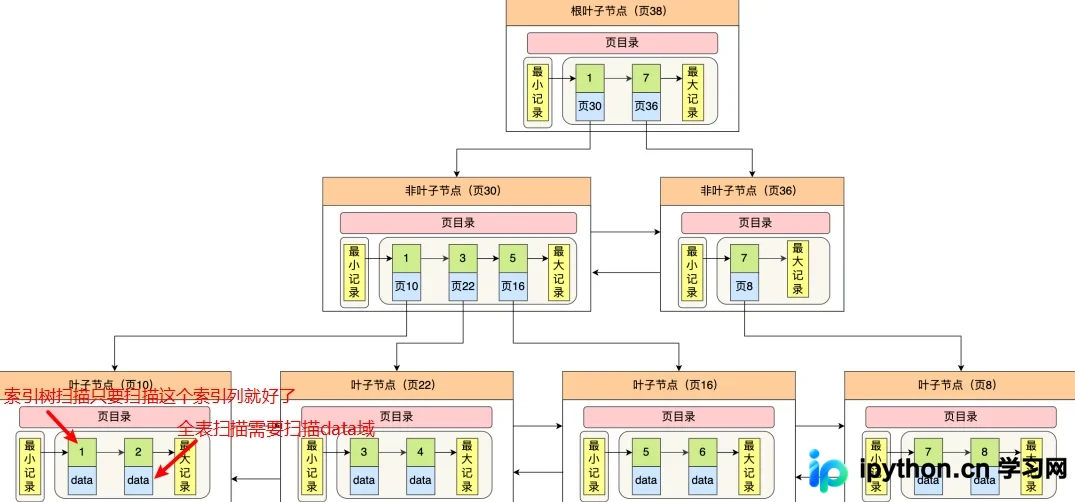
在MySQL中,EXPLAIN输出的type字段为ALL时代表全表扫描,为index时代表索引树扫描。两者底层均遍历聚簇索引B+树,但核心区别在于:索引树扫描若仅查询主键或覆盖列,可通过Using index优化避免回表;而全表扫描涉及非索引列时需读取完整行数据。本文通过实例对比两种场景的开销差异。
本文详细解析MySQL索引失效的九种常见场景,涵盖违反最佳左前缀法则、主键插入乱序、范围查询右侧列失效、函数计算导致失效、like左模糊匹配、is not null过滤以及字符集不统一等问题。通过SQL示例和执行计划对比,帮助开发者规避性能陷阱,确保查询高效利用B+树索引。
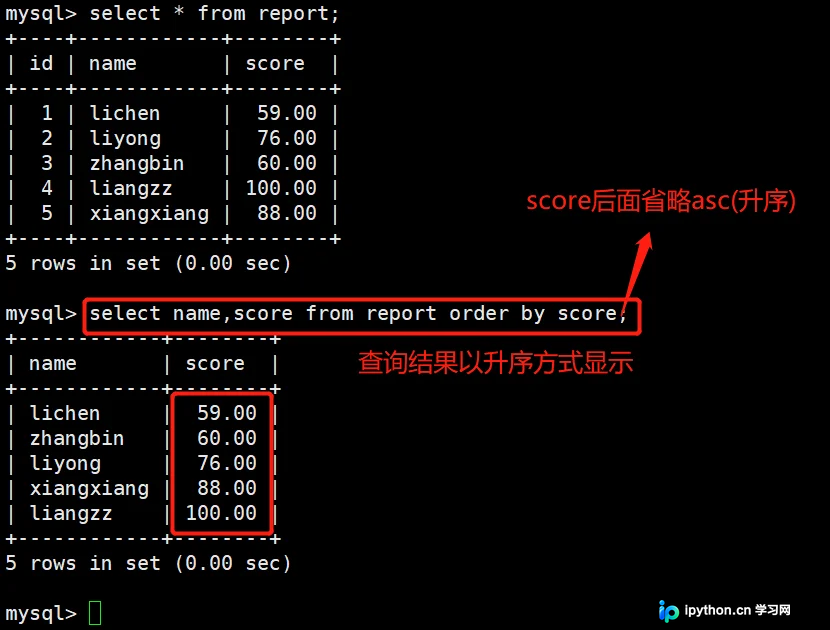
本文详细介绍MySQL数据库中常用的高级SQL查询语句,包括如何使用ORDER BY进行单字段或多字段排序,利用AND/OR实现复杂条件过滤,通过DISTINCT去除重复记录,结合聚合函数使用GROUP BY进行数据分组统计,以及运用LIMIT限制返回结果数量。同时涵盖别名设置与LIKE通配符模糊匹配等实用技巧,帮助开发者高效处理数据集。
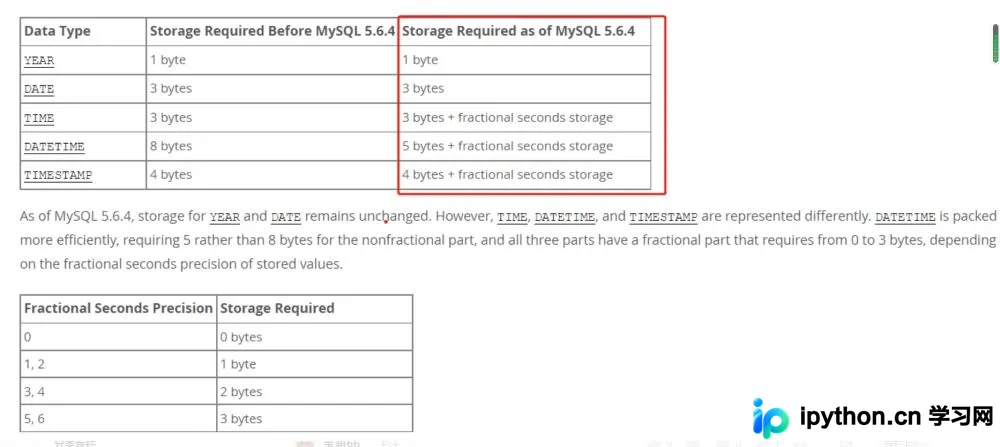
本文深入解析MySQL中datetime与timestamp在存储空间、取值范围及时区处理上的核心差异,详解如何通过参数定义毫秒精度。同时揭示Java应用连接MySQL时因serverTimeZone配置不当导致的时间偏差原理,并提供TIMESTAMP DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP的最佳实践。
针对需从多个不关联表中获取统计数据的场景,传统笛卡尔积或多次查询会导致性能下降。本文介绍使用 UNION ALL 将不同表的查询结果纵向合并,再通过外层 SUM 聚合求和的方法,实现单次请求完成多表统计,显著降低数据库压力并提升执行效率。
针对大数据量MySQL表查询性能问题,本文介绍了基于范围分区的自动维护方案。通过手动初始化分区、创建动态添加与清理分区的存储过程,并结合Event Scheduler定时任务,实现每日自动扩容分区以保留近期数据,从而提升查询效率并管理存储空间。
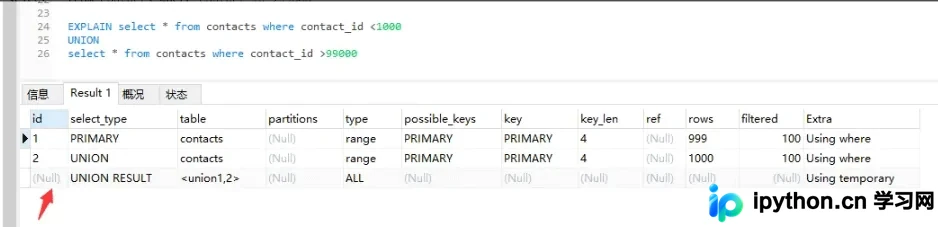
本文详细解析MySQL中EXPLAIN命令输出的各项字段,包括id、select_type、type(访问类型)、key(使用索引)及Extra等关键指标。通过理解各字段的含义与性能层级,结合覆盖索引、索引下推等特性,帮助开发者快速定位慢查询瓶颈,制定针对性的SQL与索引优化策略。
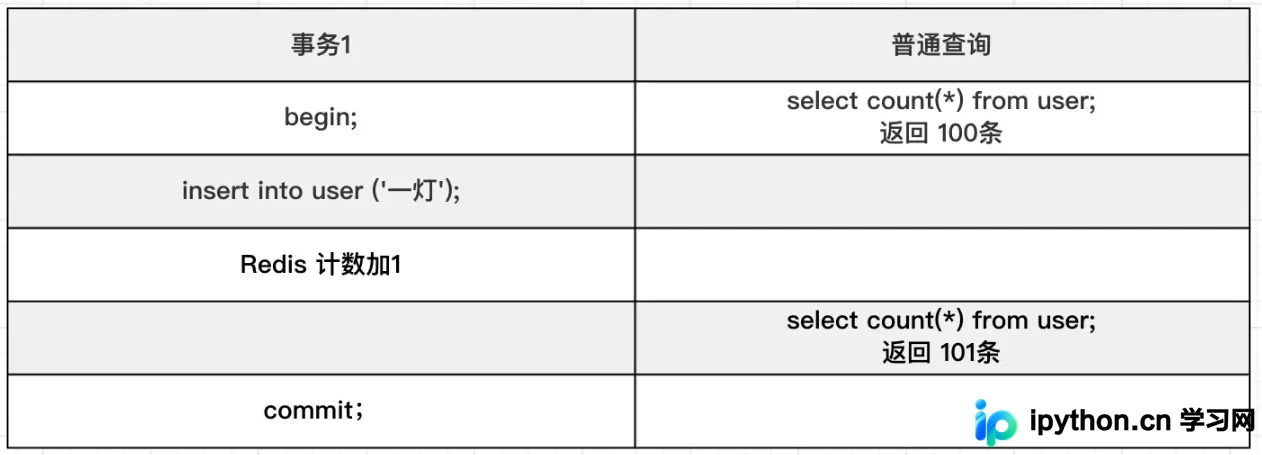
针对MySQL InnoDB引擎下count(*)统计耗时过长的问题,分析MyISAM与InnoDB的行数记录机制差异。介绍使用show table status估算行数的快速方案,对比count(*)、count(id)及count(字段)的性能差异,并指出Redis等缓存方案在处理高并发事务时的局限性,提供实用的查询优化建议。
本文深入解析MySQL InnoDB引擎的索引实现原理,重点阐述覆盖索引、联合索引的最左前缀原则以及索引下推(ICP)机制。通过对比回表查询与索引过滤的差异,提供减少I/O开销、提升SQL执行效率的具体策略与代码示例,帮助开发者掌握MySQL核心性能优化手段。
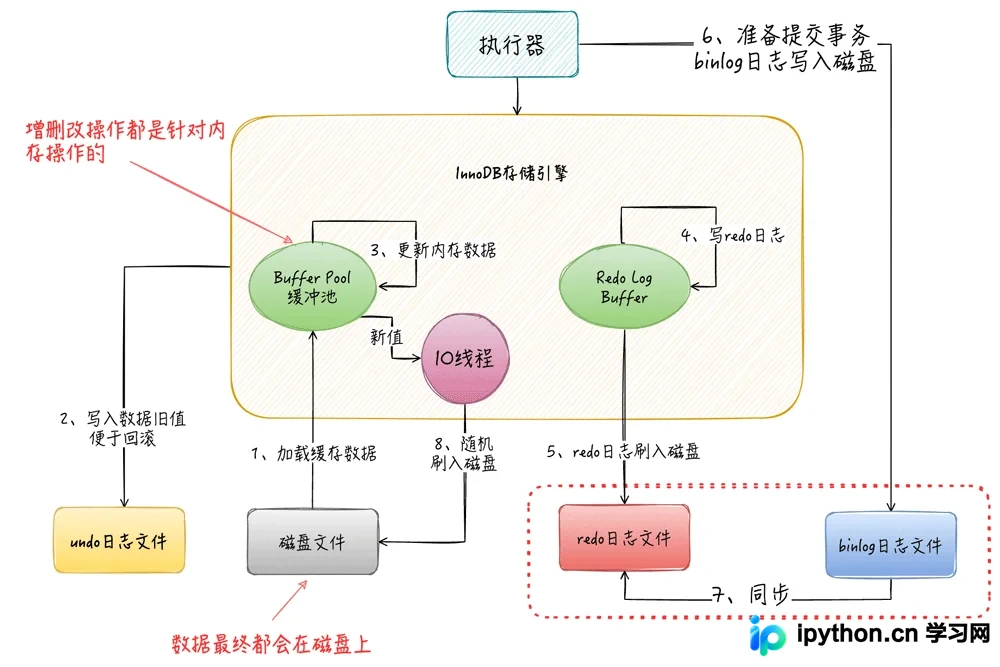
MySQL InnoDB 引擎通过 Buffer Pool 缓存磁盘数据以提升性能。本文解析其内部结构,包括 16KB 标准数据页的映射机制、描述元数据的存储位置及占比(约5%),以及脏数据恢复原理。同时提供生产环境中根据服务器内存合理调整 innodb_buffer_pool_size 的配置方法。