

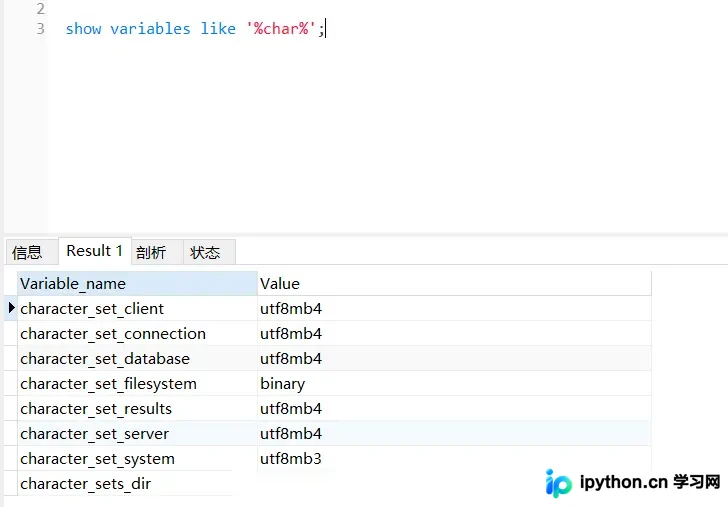
MySQL字符集与排序规则详解:解决乱码及修改配置
本文详解MySQL字符集与排序规则的应用,涵盖版本差异(latin1与utf8mb4)、常用SQL查询命令、配置文件修改方法以及各类后缀的含义。通过具体操作指导如何设置正确的字符集以彻底解决中文乱码问题,确保数据准确存储与比较。
2026-10-15
5

本文详解MySQL字符集与排序规则的应用,涵盖版本差异(latin1与utf8mb4)、常用SQL查询命令、配置文件修改方法以及各类后缀的含义。通过具体操作指导如何设置正确的字符集以彻底解决中文乱码问题,确保数据准确存储与比较。
在SQL Server中,当数据量大时,使用NOT IN或NOT EXISTS子查询可能导致全表扫描,造成执行时间长达30秒以上甚至服务无响应。通过将NOT IN改为LEFT JOIN配合IS NULL判断,可将执行时间显著降低至毫秒级,有效解决性能瓶颈。
本文深入探讨 MySQL 中模糊查询(LIKE)的优化方案。通过实测对比,展示了普通索引、左前缀索引对查询效率的巨大提升(最高达数百倍)。同时验证了 LOCATE、POSITION 等函数无法替代索引加速,澄清了常见的 SQL 优化误区,为处理大数据量下的字符串搜索提供可靠参考。
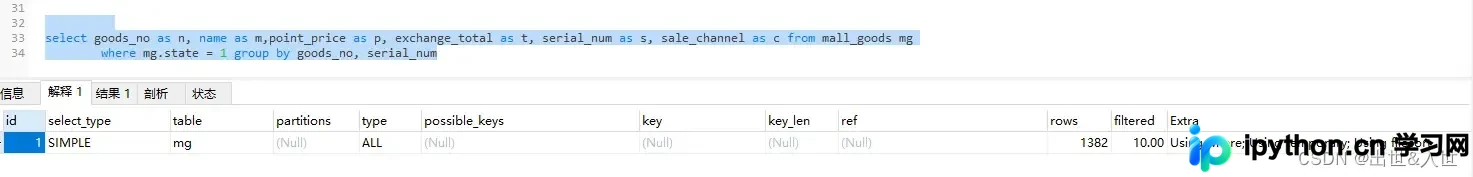
本文系统梳理了 MySQL 慢 SQL 优化的核心思路与开发规范,涵盖索引设计的六大原则(如最左前缀、避免冗余)、查询语句的十七项规范(如禁止 SELECT *、大分页处理)。通过 EXPLAIN 分析和代码示例,帮助开发者识别 Using temporary/filesort 等性能瓶颈,提供从建表到 SQL 编写的完整优化方案。
Oracle基于代价的优化器(CBO)通常能选择最优执行计划,但在统计信息缺失或数据分布极端时可能失效。DBA可通过添加HINTS提示强制指定表的访问路径(如全表扫描、索引扫描)、连接类型及顺序。本文解析Hints语法规范、常见类型及使用注意事项,帮助解决特定SQL执行缓慢的问题。
MySQL默认字符集不支持中文正确排序,导致查询结果混乱。本文介绍三种解决方法:为字段添加binary属性进行二进制比较;重新编译MySQL并指定--with-charset=gbk参数;或在SQL查询中使用CONVERT函数及COLLATE gbk_chinese_ci强制按拼音排序。
本文通过实际测试对比 MySQL 中 NOT IN、LEFT JOIN IS NULL 和 NOT EXISTS 三种去重查询方式的执行效率。结果显示,结构不当的 LEFT JOIN 可能产生巨大笛卡尔积导致性能骤降,而 NOT IN 和特定写法的 LEFT JOIN 在索引得当的情况下表现优异。文章提供了基于 EXPLAIN 的分析和避免子查询陷阱的优化建议。
深入解析SQL语句从发送到返回结果的完整生命周期。文章详细阐述了服务器端的解析阶段,包括语法语义检查、权限验证及执行计划生成与缓存机制;说明了基于数据缓冲存储区的执行逻辑,区分内存读取与物理I/O的性能差异;并梳理了SELECT语句的标准执行顺序(FROM→WHERE→GROUP BY等)。最后提供清除SQL Server缓存的方法,帮助开发者准确评估查询性能优化效果。
介绍如何使用MySQL的inet_aton()和inet_ntoa()函数将IPv4地址转换为整数存储。该方法仅需4字节空间替代字符串,提升存储效率与索引性能,并通过数值范围查询实现高效的子网过滤操作。
MySQL中利用ORDER BY RAND()进行随机查询在大数据量下效率极低,可能导致秒级延迟。本文分析其因索引失效导致的多次扫描问题,并提供基于主键ID区间的优化方案。通过比较JOIN语法与WHERE子句写法,验证了JOIN方式在执行速度上的显著优势,实测0.15秒可优化至0.015秒左右,适用于需要高频获取随机记录的场景。
在 SQL Server 数据库开发中,经常需要处理包含中英文混合的字符串并统计其中汉字的数量。本文介绍一种基于字符字节长度的巧妙算法:利用 DATALENGTH 函数获取数据的字节长度,而 LEN 函数返回字符长度。由于中文在 VARCHAR 中通常占 2 个字节,英文占 1 个字节,两者相减即可直接得出汉字的个数。该方法代码简洁且执行效率优于复杂的正则替换或循环拆分方案。
本文介绍在MySQL中以逗号分隔字符串存储标签时,如何高效进行相关性检索。对比低效的LIKE查询,推荐使用FIND_IN_SET函数进行精确匹配。对于复杂排序需求,可结合MATCH...AGAINST全文检索功能,但需注意最小分词长度和停用词配置优化。