

MySQL去重查询的三种方法:distinct、group by与row_number()

数据库应用中经常会遇到表中有重复数据或关联查询产生冗余的问题。本文详细介绍三种MySQL数据去重方法:DISTINCT简单过滤、GROUP BY分组提取,以及适用于MySQL 8.0以上版本的ROW_NUMBER()开窗函数和兼容低版本的变量模拟方案。旨在为不同业务场景提供高效的去重思路。
准备测试环境
在开始具体方法前,首先需要构建一个包含重复数据的测试表 t_user,以便观察去重效果。假设表中主要包含用户信息字段。
以下是测试数据的典型结构,其中存在多条记录拥有相同的 user_name:
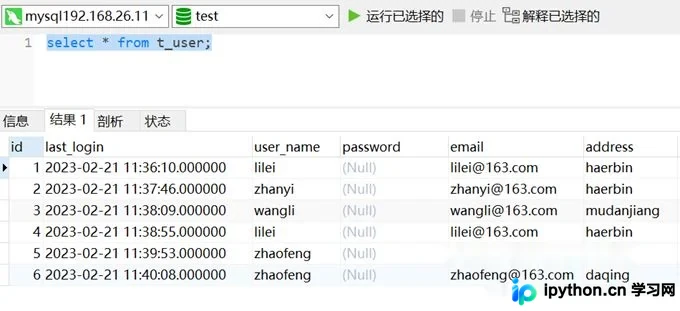
常用的三种去重方法
第1步:使用 distinct 快速去重
适用场景:当只需要获取唯一值列表,且不涉及其他字段的排序或聚合统计时,这是最简单直接的方法。
核心逻辑:强制返回指定列的不同组合,系统会自动过滤掉完全相同的行。
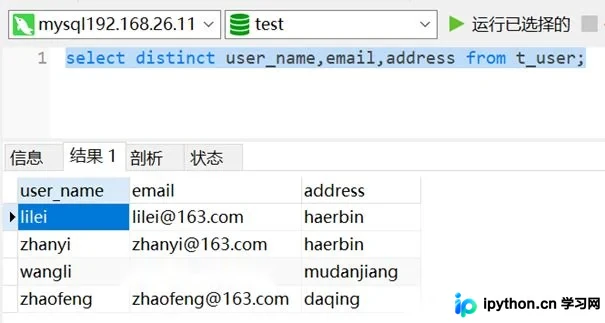
SELECT DISTINCT user_name, email, address FROM t_user;执行结果如下,重复的数据行已被自动精简,相同信息的记录仅保留一条:
第2步:使用 group by 分组去重
适用场景:除了去重外,还可能需要结合聚合函数(如 COUNT)来获取重复次数,或者对非分组字段进行特定处理时使用。
操作注意:在标准的 SQL 模式(ONLY_FULL_GROUP_BY)下,出现在 SELECT 中的非聚合字段通常需要出现在 GROUP BY 中。
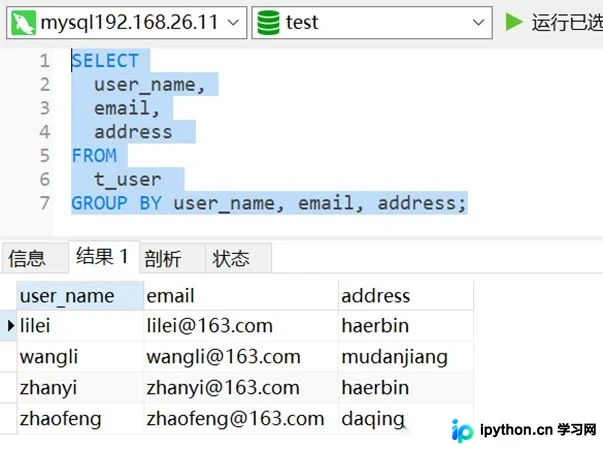
SELECT user_name, email, address
FROM t_user
GROUP BY user_name, email, address;
该方法的输出结果同样能实现数据去重,每行代表一个唯一的用户记录组合:
第3步:使用 window function (开窗函数)精准去重
适用场景:需要在不丢失原始数据的前提下,按特定规则(如“最近登录时间”)保留最新的一条记录,而不仅仅是简单地去重。
步骤说明:分为 MySQL 8.0 及以上版本与旧版本的两种实现方式。
情况一:MySQL 8.0+ 使用 ROW_NUMBER()
如果您的数据库升级到了 8.0 以上,推荐使用原生的窗口函数 ROW_NUMBER(),语法清晰且性能更优。此方法可按 user_name 分区,并根据 last_login(最后登录时间)倒序排列,标记为第1名的即为我们要保留的最新数据。
SELECT * FROM (
    SELECT t.*,
           ROW_NUMBER() OVER(
               PARTITION BY user_name
               ORDER BY last_login DESC
           ) rn
    FROM t_user AS t
) AS subquery
WHERE rn = 1;
情况二:MySQL 5.7 及以下兼容写法
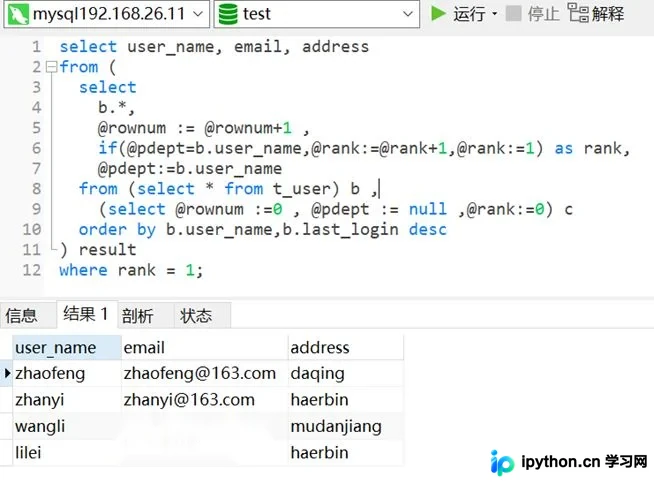
如果环境不支持窗口函数,可以通过定义用户变量来手动模拟行号逻辑,以此达到去重目的。虽然代码较为冗长,但逻辑严密。
SELECT user_name, email, address
FROM (
    SELECT b.*,
           @rownum := @rownum + 1, -- 全局行号
           @rank := IF(@pdept = b.user_name, @rank + 1, 1) AS rank, -- 组内行号
           @pdept := b.user_name   -- 记录上一行的用户名
    FROM (
        SELECT * FROM t_user
        ORDER BY user_name, last_login DESC  -- 必须先排序以确保分组连续性
    ) b,
    (SELECT @rownum := 0, @pdept := NULL, @rank := 0) c
) result
WHERE result.rank = 1;
上述两种子查询方法最终均能实现精准筛选,保留了每组中最新的一条记录:
总结
以上就是MySQL数据去重的详细内容。简单来说,简单的唯一性检查用 DISTINCT;配合统计需求选 GROUP BY;需要按条件保留最新/最早记录的“智能去重”,则优先使用新版 MySQL 的 ROW_NUMBER()。更多关于数据库优化的实用技巧,请关注本站后续更新!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









