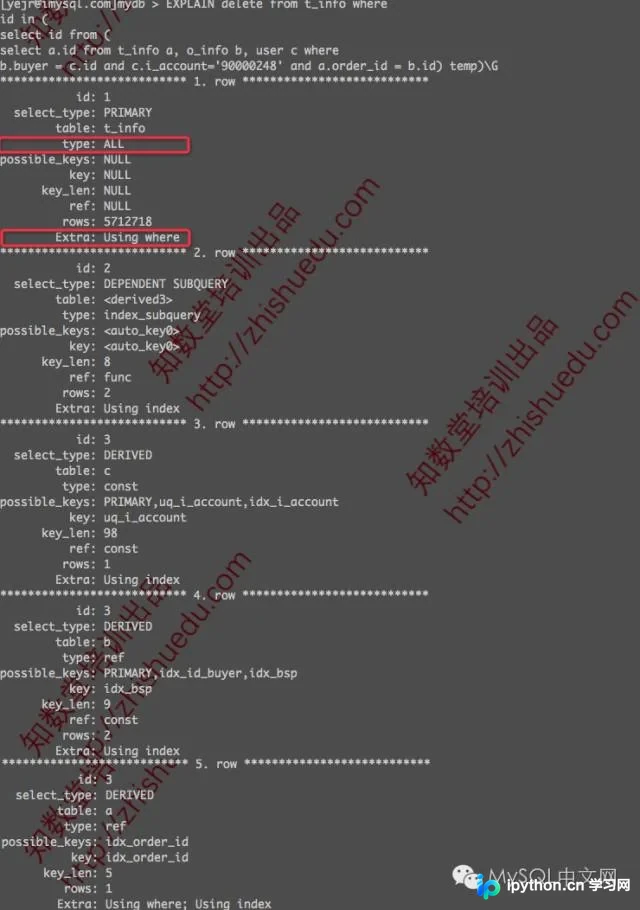
SQL Server批量插入数据:Bulk与TVP性能对比及实现
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
2026-10-16
11

针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
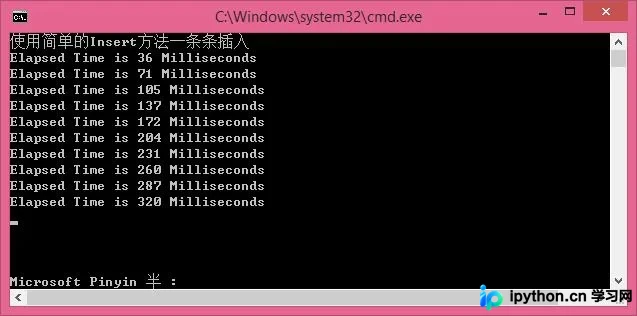
在 MySQL RC 隔离级别下,先删后增操作配合唯一联合索引极易引发死锁。本文通过复现死锁日志和源码分析,指出 RC 级别下唯一键冲突检查会触发间隙锁,导致相邻事务竞争排他锁而形成循环等待。解决方案是废弃先删后增逻辑,采用全量数据的更新与新增合并策略。
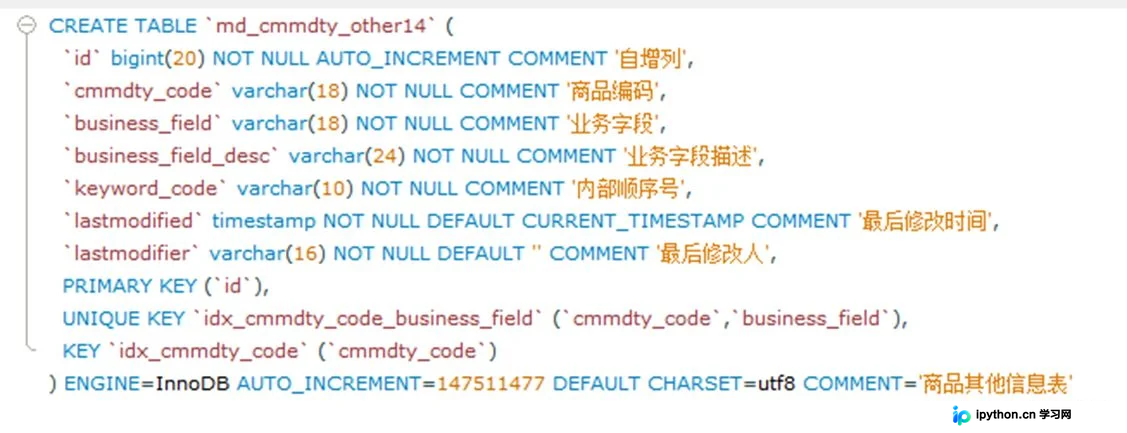
本文深入解析 MySQL 复合索引的核心机制,重点阐述最左匹配原则在 B+ 树索引中的应用。通过 EXPLAIN 分析执行计划,揭示字段顺序对查询性能的影响及覆盖索引的优势,并提供避免全表扫描的建表建议,帮助开发者优化复杂查询。
本文详细介绍MySQL中四种主要表分区类型(RANGE、HASH、KEY、LIST)的定义及适用场景,并通过具体代码演示如何创建分区表、插入测试数据以及查看分区状态。重点强调分区字段作为主键的约束条件,并解析如何通过EXPLAIN PARTITIONS验证查询是否命中分区以提升性能。
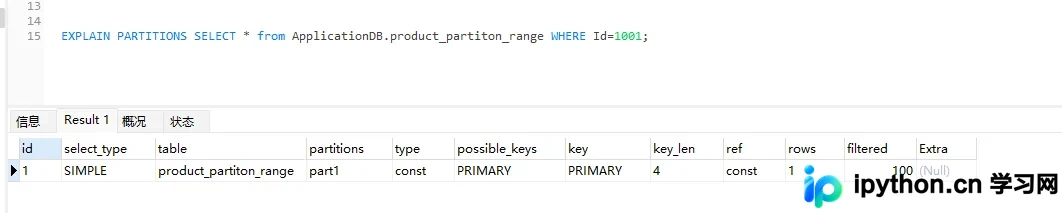
本文梳理MySQL中复杂的日期区间查询技巧,重点指出DATE_FORMAT导致索引失效的问题并提供优化方案。汇总now、curdate等时间获取函数,以及date_format、str_to_date转换方法,并结合date_add、datediff计算周期数据,提升SQL查询效率。
本文详解 PHP 中使用 Memcache 进行数据缓存的核心方法,涵盖 add、get、replace 和 delete 等操作。通过实际代码示例,演示如何结合 MySQL 查询结果构建缓存机制,以 md5 哈希作为键值标识,有效减轻数据库压力并提升应用响应速度。
针对C#处理MySQL千万级数据的性能瓶颈,本文提出基于MySqlDataReader的原生SQL读取方案和分批合并INSERT的写入策略。通过关闭ORM开销、调整超时参数、利用StringBuilder构建长SQL并控制max_allowed_packet阈值,实现高吞吐量的数据迁移与处理流程。
本文详解在MySQL中处理批量插入重复数据的三种核心策略:INSERT IGNORE、REPLACE INTO 以及 INSERT ... ON DUPLICATE KEY UPDATE。通过对比它们对主键和唯一键的响应机制,剖析执行逻辑差异及潜在风险(如自增ID不连续、数据丢失),并针对主从复制场景给出避坑建议,帮助开发者选择最适合的业务场景。
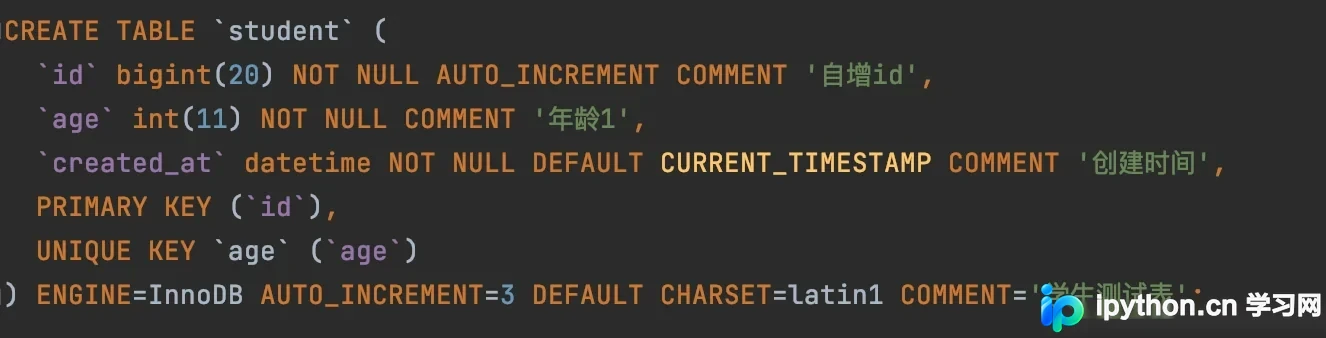
介绍利用MySQL临时表(内存表)结合存储过程批量插入数百万条测试数据的完整流程。涵盖创建内存表、编写随机函数与存储过程、调用批量导入及遇到‘Table is full’错误时的内存参数调整方法。最后演示了使用覆盖索引优化深度分页查询的性能提升效果。
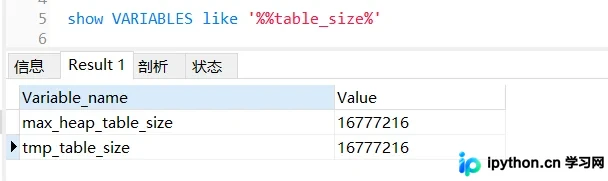
本文详细讲解如何在MySQL和Oracle中查询及删除数据库中的重复记录。针对单字段和多字段重复场景,提供了基于GROUP BY、ROWID临时表及子查询的高效SQL写法。重点对比了不同方法的优劣及适用环境,帮助用户快速清理冗余数据并预防重复发生。
本文详细介绍MySQL中ORDER BY语句的使用,涵盖单列默认升序排序、多列组合排序、ASC/DESC升降序指定以及结合LIMIT获取极值的方法。通过实例演示如何避免中文乱序陷阱并掌握正确的SQL语法顺序。
当MySQL的DELETE语句包含子查询导致执行极慢时,通常是因为查询优化器未能有效利用索引进行过滤。本文将通过具体案例对比分析,展示如何将低效的子查询改写为基于多表JOIN的DELETE语句。通过FROM子句关联临时结果集,可让优化器利用主键直接定位数据,避免全表扫描和回表,将耗时从30秒级降低至毫秒级。