

MySQL索引原理详解:从二叉树到B+树的进化与选型

MySQL索引是提升数据检索效率的核心机制。本文通过梳理从二叉树到B+树的演进过程,解析不同索引结构的优缺点,并重点说明InnoDB存储引擎选择B+Tree作为默认索引结构的原因,涵盖磁盘IO优化、范围查询能力及数据结构特性。
索引概述
基本概念
索引(Index)是帮助MySQL高效获取数据的有序数据结构。在数据之外,数据库系统维护着满足特定查找算法的数据结构,这些结构以某种方式引用(指向)实际数据,从而在结构本身即可实现高级查找。简单来说,索引类似于现实生活中的目录或字典的页码,是一种复杂但高效的辅助查找结构。
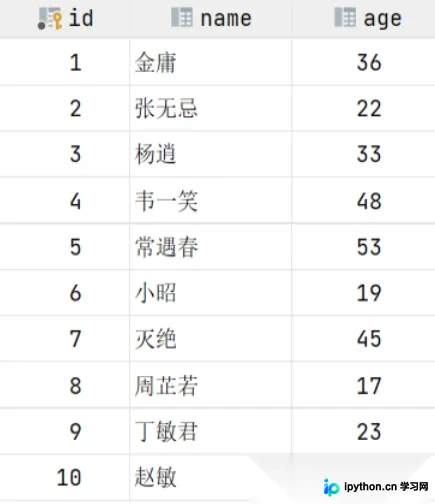
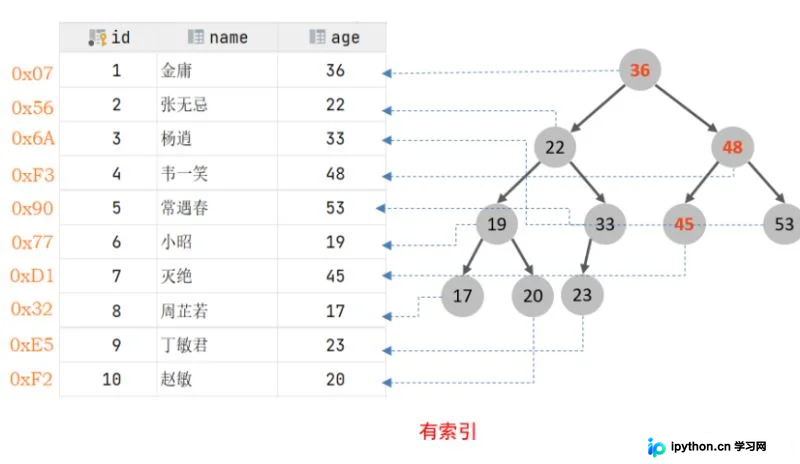
当执行如 select * from tb_user where age = 45; 这样的查询时,若无索引,MySQL需进行全表扫描,逐一比对每条数据的 age 字段。随着数据量增长,这种线性查找的效率极低。
引入索引的本质,是将关键字段(如 age)映射到特定的数据结构(如平衡树)中。例如,将年龄值构建为二叉搜索树,即可实现对数级别的快速定位。这一“建立数据结构并映射数据”的过程即为索引。需要注意的是,二叉搜索树仅是理论示例,实际数据库中的索引结构更为复杂。
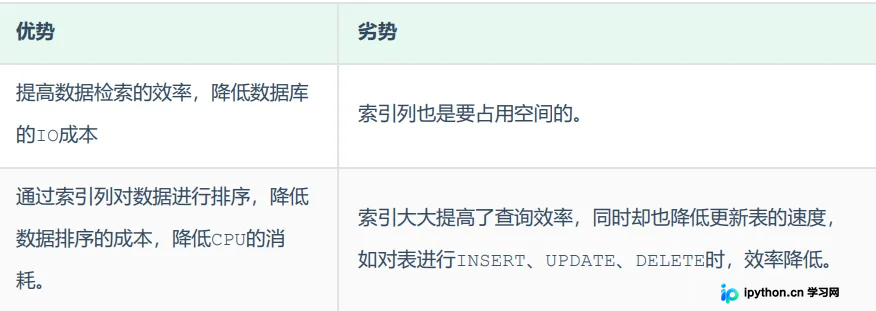
索引特点
索引结构与存储引擎支持
MySQL的索引实现在存储引擎层,不同引擎支持不同的索引类型。常见的索引结构包括哈希索引、B+Tree索引、全文索引等。
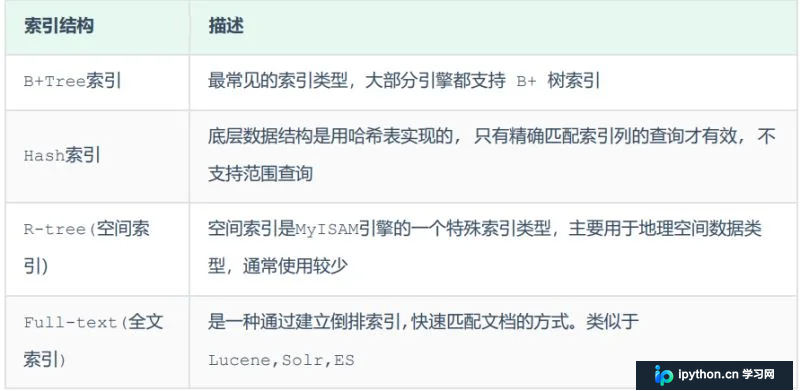
各存储引擎对索引结构的支持情况如下:
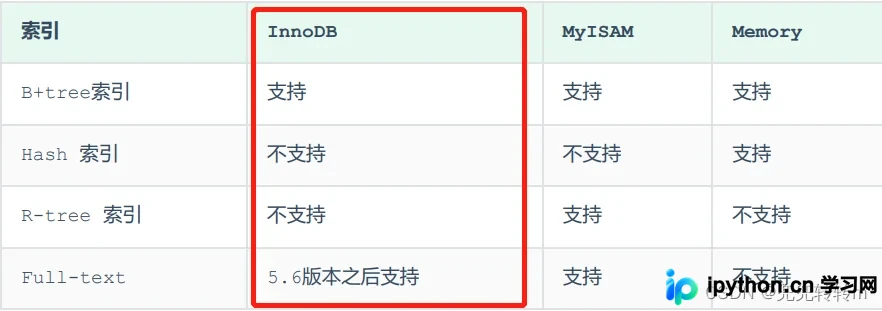
在实际应用中,InnoDB是MySQL默认的存储引擎,而MyISAM已逐渐被淘汰(常被MongoDB等替代),Memory引擎则多用于临时数据场景(常被Redis替代)。因此,本文主要聚焦于InnoDB所支持的B+Tree索引。
索引进化的过程
为了深入理解为何MySQL选择B+Tree,我们需要回顾索引数据结构的进化历程。
1. 二叉搜索树 (Binary Search Tree)
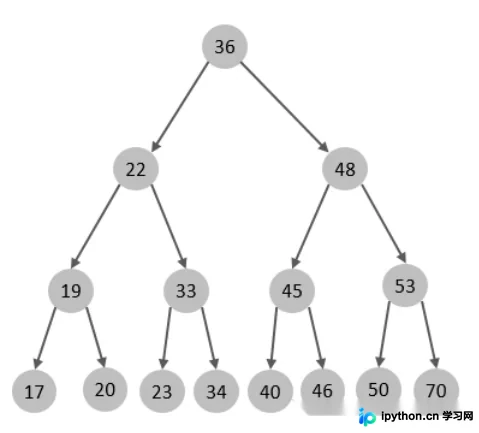
二叉搜索树利用左子树小于根节点、右子树大于根节点的特性进行排序和查找。
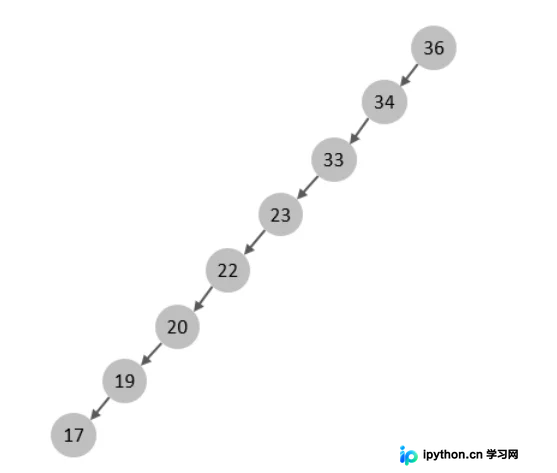
其缺点在于极端情况下会退化为链表(例如按顺序插入数据),导致查找时间复杂度退化至 O(n),等同于全表扫描。
2. 红黑树 (Red-Black Tree)
为避免退化,平衡二叉树(如红黑树)被提出。红黑树通过自我调节保持大致平衡,确保最坏情况下的查找复杂度仍为 O(logN)。
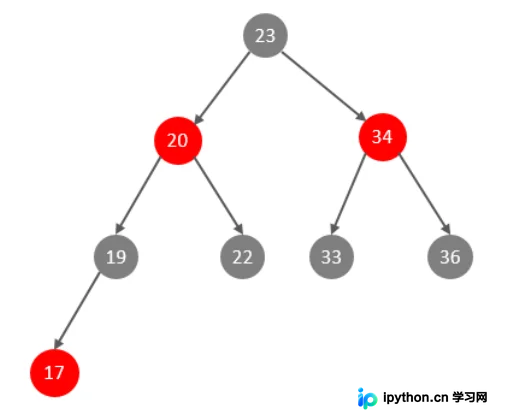
然而,红黑树并非数据库索引的最优解。原因如下:
1. 树高过深导致频繁IO: MySQL数据以页(Page)为单位存储在磁盘上,每次访问节点可能引发一次磁盘IO操作。红黑树是二叉树,若数据量大,树的高度依然较深,导致需要多次IO才能定位到数据。
2. 内存占用大: 每个节点只存两个指针,对于大量数据而言,非叶子节点占据大量内存空间。
3. B-Tree (多路平衡查找树)
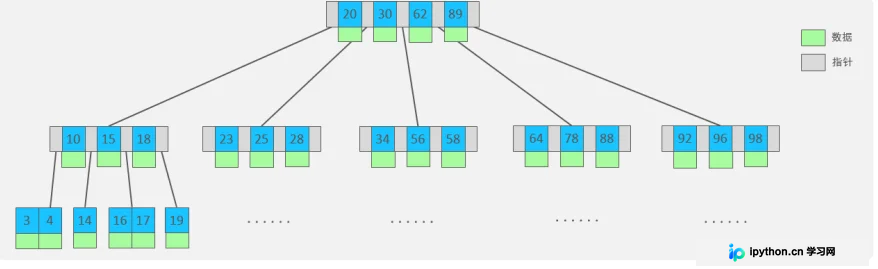
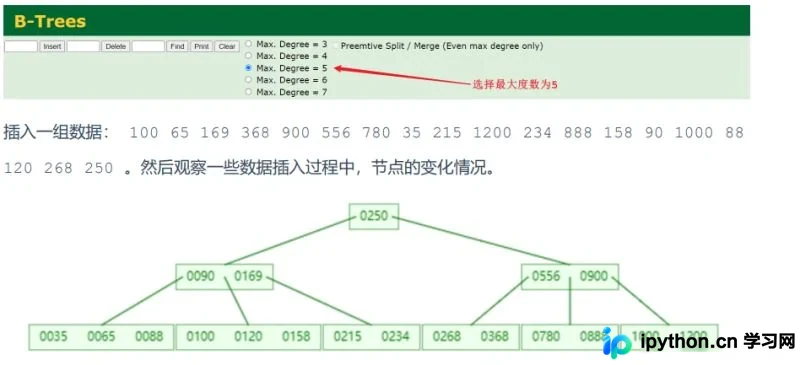
B-Tree(通常指B*Tree的前身,即多路平衡查找树)旨在降低树高。作为一种多叉树,B-Tree的每个节点可以包含多个Key和多个指针。以5阶B-Tree为例,每个节点最多存储4个Key和5个指针,从而显著减少了树的层级。
4. B+Tree (MySQL InnoDB的选择)
虽然B-Tree降低了树高,但InnoDB最终选择了B+Tree,因为其在数据库场景下具有更明显的优势:
- 更低的高度与更高的扇出: B+Tree的非叶子节点仅存储Key不存储Data,这意味着一个页(通常是16KB)可以容纳更多的Key,进一步降低树高,减少IO次数。
- 叶子节点包含全部数据: B+Tree的所有数据都存储在叶子节点中,且叶子节点通过双向链表连接。这使得范围查询(Range Query)只需遍历链表即可,无需像B-Tree那样进行中序遍历,效率极高。
- 查询稳定性好: B+Tree的查找路径固定,所有查询都必须走到叶子节点,性能稳定。
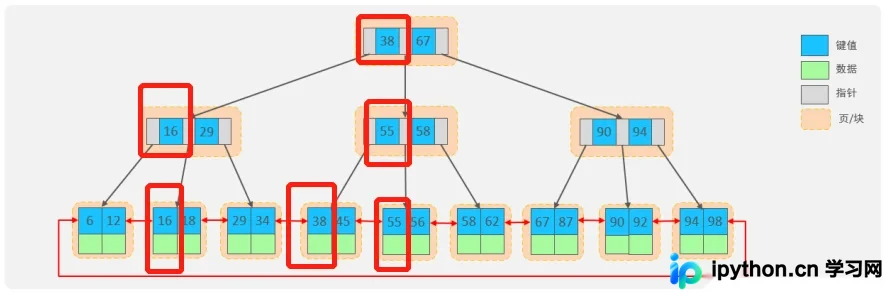
综上所述,B+Tree因其在磁盘IO效率、范围查询能力和存储空间利用率上的综合优势,成为MySQL InnoDB引擎的首选索引结构。
以上就是MySQL索引原理与B+Tree优势的详细内容,更多关于数据库结构优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









