

MySQL 处理重复数据并保留最新一条记录

在 MySQL 实际开发中,常遇到因代码缺陷或并发问题导致同一业务键产生多条重复记录的情况。特别是在采用逻辑删除(使用 deleted 字段标识状态)的场景下,简单的去重操作容易引发 SQL 语法错误或逻辑矛盾。本文详解如何在 MySQL 中精准定位重复数据,并通过正确的 SQL 写法安全地仅保留时间或 ID 最大的最新一条记录。
场景分析与问题定位
假设存在一张订单关联额外费用的表 order_cost_detail,业务规则要求一个订单号 (order_no) 只能关联同一个费用 (cost_id) 一次。由于系统 Bug,数据库中出现了同一订单号关联同一费用多次的“脏数据”。同时,该表采用逻辑删除机制,即不物理删除数据,而是通过修改 deleted 字段值(0 表示正常,1 表示删除)来标记状态。
在此约束下,常见的建表语句如下:
CREATE TABLE `order_cost_detail` (
  `id` int NOT NULL AUTO_INCREMENT COMMENT '主键',
  `order_no` varchar(32) NOT NULL COMMENT '订单号',
  `cost_id` int NOT NULL COMMENT '费用Id',
  `cost_name` varchar(50) NOT NULL DEFAULT '' COMMENT '费用名称',
  `money` decimal(10,2) NOT NULL COMMENT '金额',
  `create_time` datetime NOT NULL COMMENT '创建时间',
  `deleted` tinyint(1) NOT NULL COMMENT '是否删除(0 否,1 是)',
  PRIMARY KEY (`id`) USING BTREE
) ENGINE=InnoDB AUTO_INCREMENT=1 COMMENT='订单 - 费用表';
插入模拟数据后,表中可能包含如下结构的数据(示意):
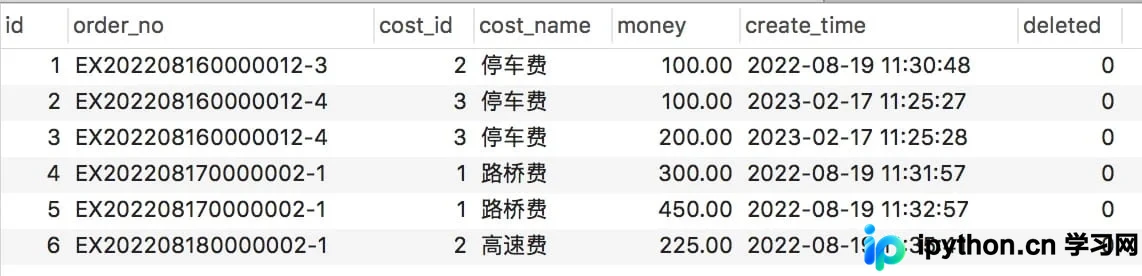
我们的目标是:在所有 deleted = 0 的记录中,找出 order_no 和 cost_id(或 cost_name,视具体业务唯一性定义而定,此处以示例中的 cost_name 组合为例)相同的重复组,并删除多余的记录,仅保留每组中 id 最大(即最新创建)的一条。
步骤一:识别重复数据
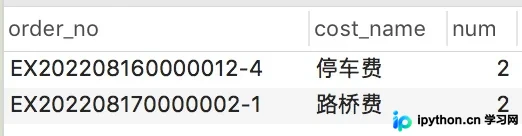
首先,我们需要确认哪些组合存在重复,以及重复的数量。可以通过以下 SQL 查询来获取重复项:
SELECT order_no, cost_name, count(*) AS num
FROM order_cost_detail
WHERE deleted = 0
GROUP BY order_no, cost_name
HAVING num > 1;
执行结果如下所示,可以看到具体的重复订单号和费用名:
步骤二:确定需要删除的记录
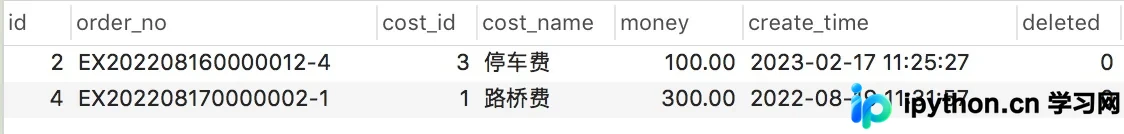
在明确有重复数据后,下一步是找出那些“非最新”的记录 ID。逻辑是:对于每一组重复数据,保留 MAX(id),其余的全部视为需要删除的对象。可以先用 SELECT 验证要删除的范围:
SELECT *
FROM order_cost_detail
WHERE id NOT IN (
    SELECT max(id) as num
    FROM order_cost_detail
    WHERE deleted = 0
    GROUP BY order_no, cost_name
);
查询结果将列出所有需要被逻辑删除的行,确认无误后如图:
步骤三:执行更新操作(解决 MySQL 限制)
直观的想法是直接执行 UPDATE 语句将这些记录的 deleted 字段设为 1。但在 MySQL 中直接运行以下语句会报错:
-- ❌ 错误写法:直接子查询引用目标表
UPDATE order_cost_detail
SET deleted = 1
WHERE id IN (
    SELECT id
    FROM order_cost_detail
    WHERE id NOT IN (
        SELECT max(id) FROM order_cost_detail WHERE deleted = 0 GROUP BY order_no, cost_name
    )
);
报错信息为:You can't specify target table 'table_name' for update in FROM clause。这是 MySQL 的限制:不能在同一 SQL 语句中,先从表中 SELECT 出某些值,再对该表进行 UPDATE 操作。
第 1 步:使用中间表绕过限制
解决方法是将子查询的结果包裹在一个额外的 SELECT 层中(通常命名为临时别名如 t),使 MySQL 认为这是一个独立的临时结果集,而非对原表的直接引用。
-- ✅ 正确写法:引入中间表别名
UPDATE order_cost_detail
SET deleted = 1
WHERE id IN (
    SELECT t.id
    FROM (
        SELECT id
        FROM order_cost_detail
        WHERE id NOT IN (
            SELECT max(id)
            FROM order_cost_detail
            WHERE deleted = 0
            GROUP BY order_no, cost_name
        )
    ) t
);
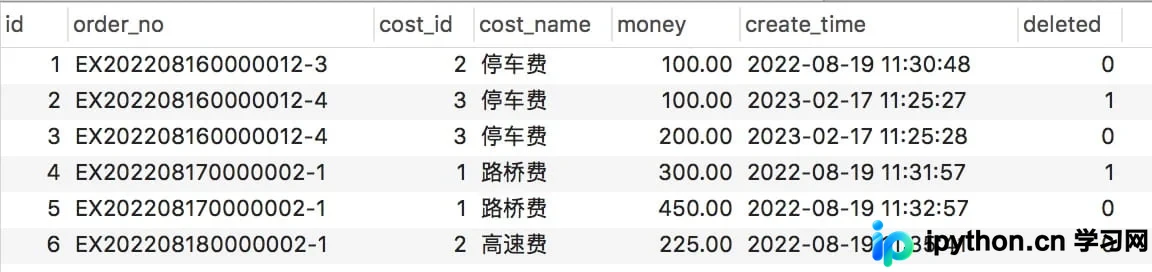
再次执行该 SQL,操作成功完成,多余的历史脏数据被标记为已删除,且只保留了每组最新的记录:
预防建议与总结
虽然 SQL 脚本能解决历史遗留问题,但预防胜于治疗。阿里巴巴 Java/后端开发手册中明确指出:
【强制】业务上具有唯一特性的字段,即使是组合字段,也必须建成唯一索引。
即使应用层做了校验,只要没有数据库层面的约束,根据墨菲定律必然产生脏数据。建议在 order_no + cost_id + deleted 上建立联合唯一索引,或者调整逻辑删除的策略(例如将已删除状态的 deleted 赋值为当前主键 ID,从而使得 deleted != 0 均视为删除,避免重复删除冲突),从根源上杜绝此类问题的发生。
以上就是 MySQL 处理大量脏数据并只保留最新一条记录的详细内容,更多关于 MySQL 数据清洗与优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









