


很多人第一次看 EXPLAIN,注意力会被一整排字段分散,最后只记住“有没有走索引”。但真正影响判断的,往往是扫描方式、预估行数和额外操作这几个关键信号。本文按实际排查顺序梳理 MySQL 中最值得看的字段、为什么要优先使用 FORMAT=JSON,以及哪些性能结论不能只靠执行计划下判断,帮助你把 SELECT 调优看得更准。
EXPLAIN 输出里先看哪些字段
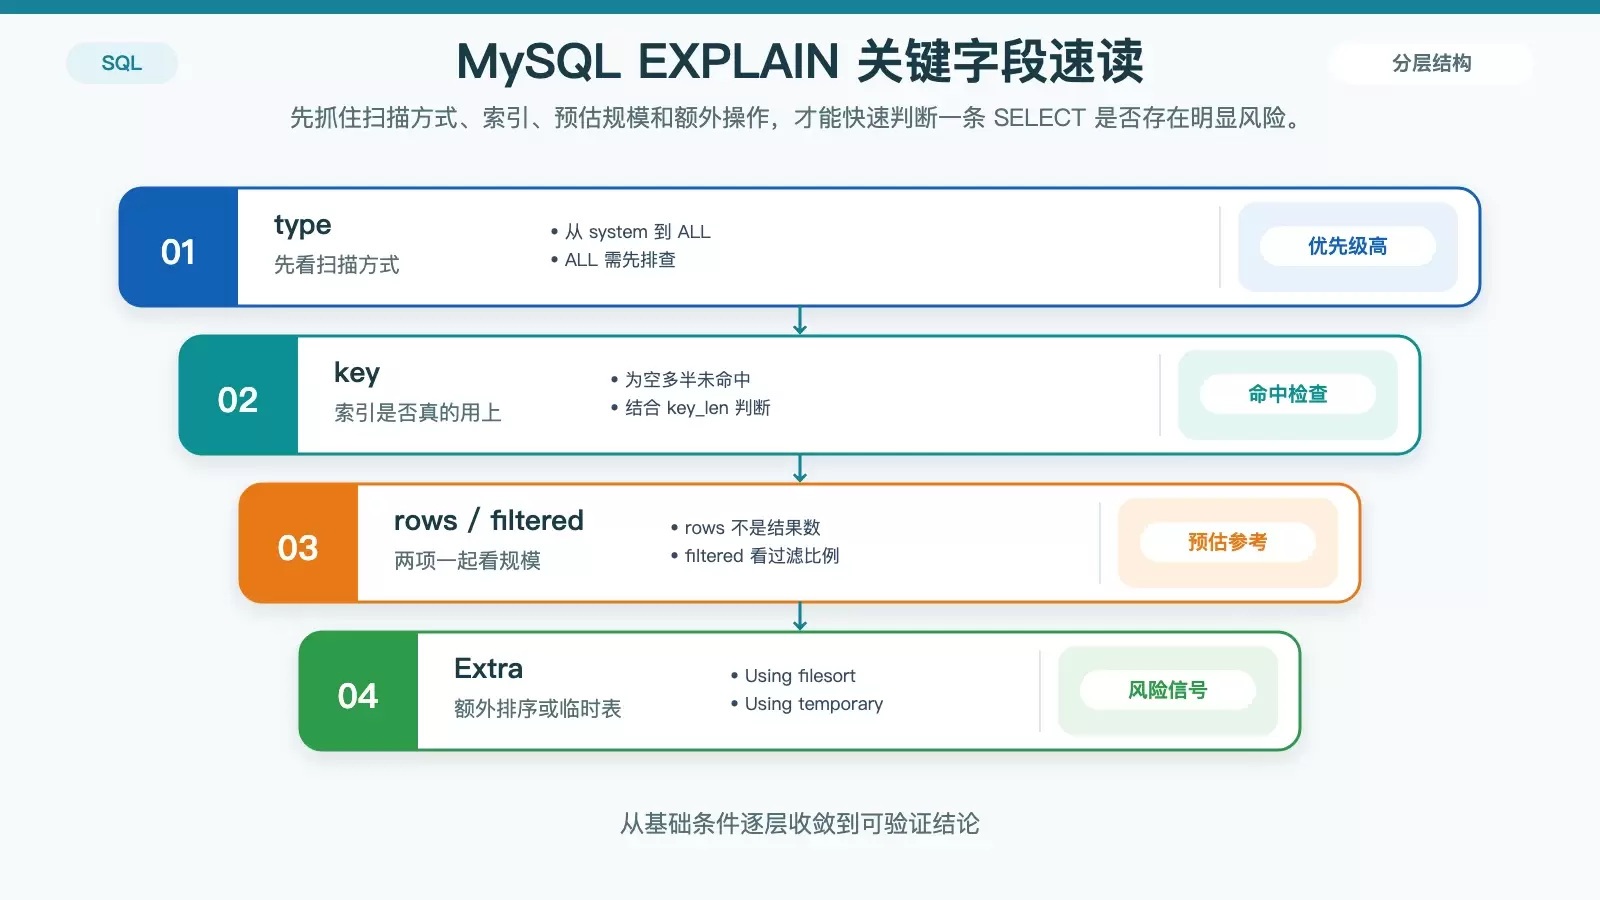
MySQL 8.0+ 默认给出的还是传统表格格式,但排查 SELECT 性能时,不需要把每一列都平均对待。通常最关键的是 type、key、rows、filtered 和 Extra。
type 决定扫描方式
type 反映的是访问表的方式,扫描效率差异很大。一般可以把它理解为从 system 这类高效访问,一路下降到 ALL 这样的全表扫描。看到 ALL 时要格外警惕,因为这通常意味着查询没有借助有效索引完成过滤。
key 看是否命中索引
key 表示优化器最终选择了哪个索引。如果这一列为空,通常说明没有真正走索引。不过这里也有一个常见误区:key 出现了索引名,不代表这个索引的所有列都被充分利用。要进一步确认,还得结合 key_len 看实际用了多少字节,也就是只命中了索引前缀,还是把复合索引利用得比较完整。
rows 和 filtered 反映预估规模
rows 是预估扫描行数,不是最终返回结果行数;filtered 反映的是经过条件过滤后,大概还能保留下多少比例的数据。这两个字段一起看,才能更接近优化器眼中的执行成本。
这里最容易被误读的是:rows 小不一定就快。如果 type 仍然是 ALL,哪怕显示 rows=100,也不能直接说明代价低。有时只是统计信息不够准确,实际执行依旧可能扫完整张表。
Extra 用来识别额外代价
Extra 往往最能直接暴露风险。如果出现 Using filesort 或 Using temporary,通常说明排序、分组没有走到合适索引,数据库不得不额外做文件排序或临时表处理。它不一定意味着查询一定很慢,但至少说明这里值得优先检查 ORDER BY、GROUP BY 和索引设计是否匹配。
为什么调试慢查询时最好直接用 FORMAT=JSON
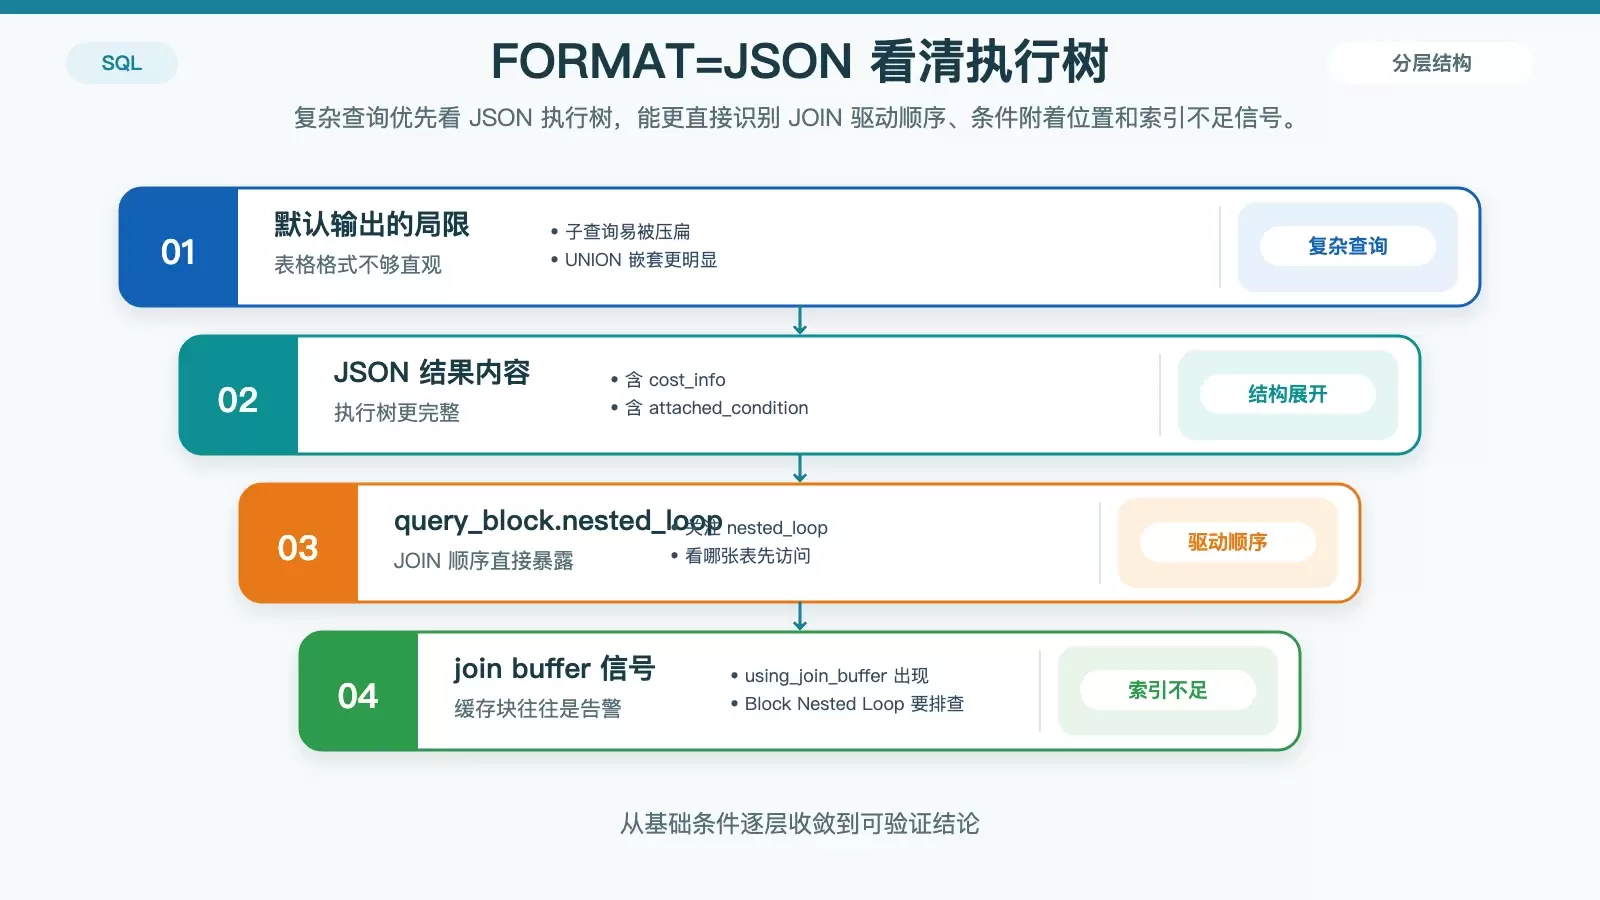
如果查询里只有单表和简单条件,传统表格格式还能勉强看懂。但一旦涉及子查询、UNION、LATERAL 或多表 JOIN,默认文本输出很容易把关键执行逻辑压扁成几行,让人看不到真正的嵌套关系。
这也是为什么排查慢查询时,更建议直接使用:
EXPLAIN FORMAT=JSON SELECT ...JSON 结果会把执行计划展开成一棵更完整的执行树,里面可以看到 cost_info、used_columns、attached_condition 等细节。相比表格格式,它不只是“字段更多”,而是能把执行顺序和代价结构更明确地展示出来。
重点看 nested_loop 识别 JOIN 驱动顺序
实操时可以重点关注 query_block.nested_loop。这一部分直接揭示了 JOIN 的实际驱动顺序,也就是哪张表先被访问、哪张表后被关联。很多 JOIN 性能问题,不是 SQL 写错,而是驱动表选得不理想,导致后续表被重复扫描。
join buffer 是索引不足的信号
如果在 JSON 结果里看到 "using_join_buffer": "Block Nested Loop",通常说明当前 JOIN 缺少合适索引,MySQL 只能借助缓存块做嵌套循环。这往往意味着需要重新检查 JOIN 条件,或者为关联列补上索引,否则数据量一上来,代价会明显放大。
EXPLAIN 不会告诉你,但必须补做的验证
EXPLAIN 的价值很高,但它本质上只是预估计划,而不是一次真实执行。它不会反映数据分布偏差、锁等待、缓冲池命中率,也不会把并发环境下的真实开销展示出来。所以执行计划只能作为第一层判断,后面必须补上验证。
先核对 rows 预估是否失真
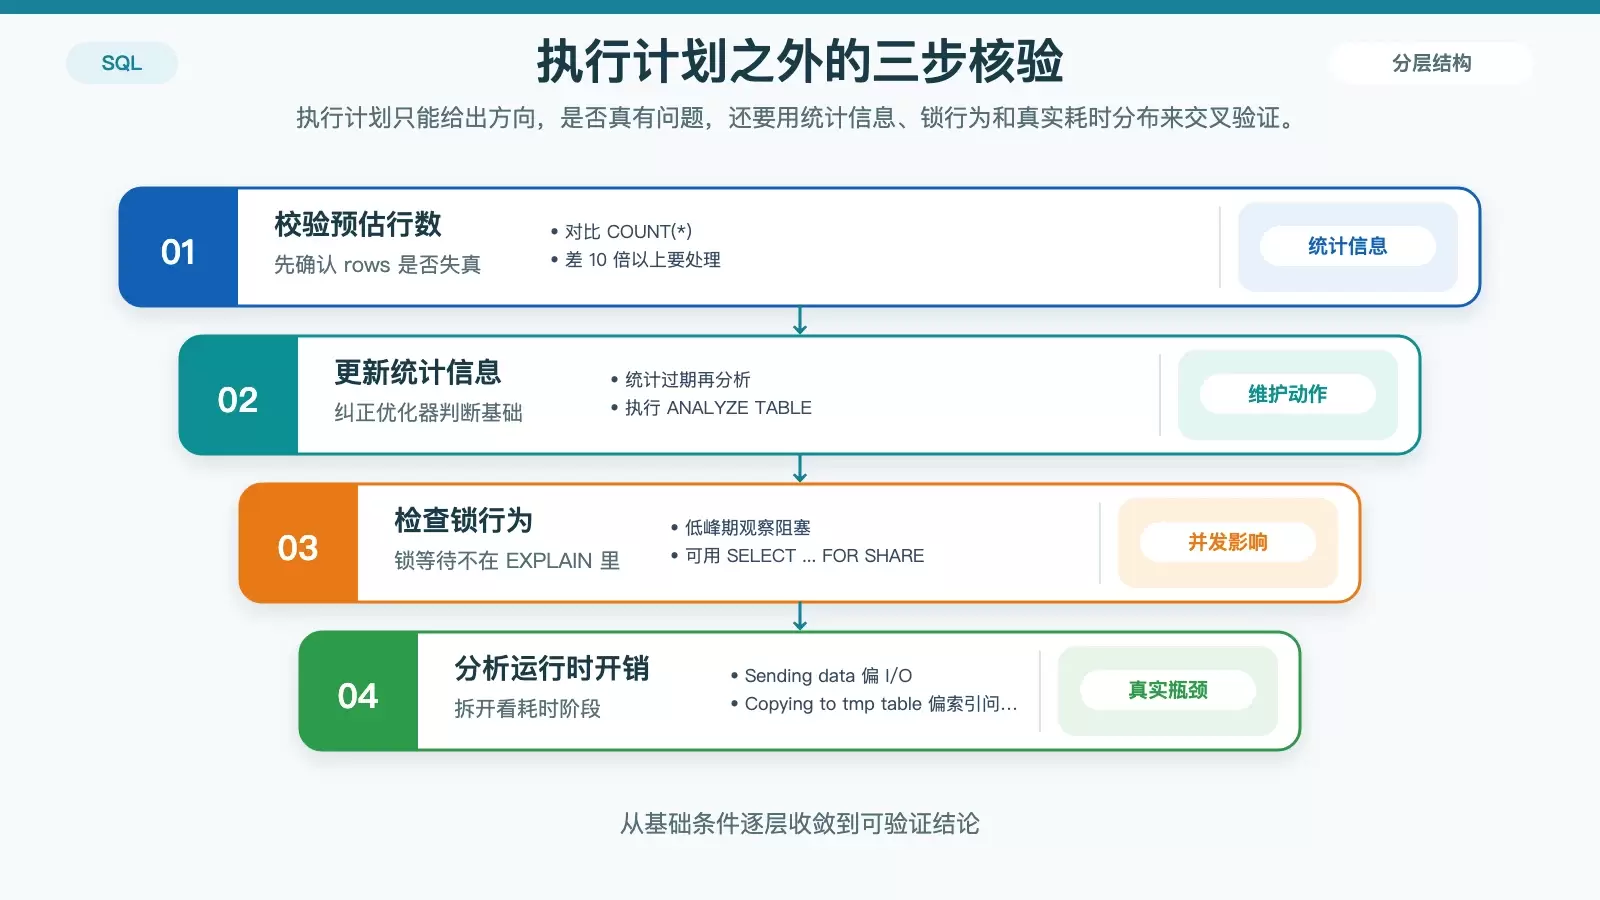
可以执行 SELECT COUNT(*),把真实数据规模与 EXPLAIN 中的 rows 做对比。如果两者相差 10 倍以上,通常说明统计信息已经过期,这时需要运行:
ANALYZE TABLE否则你看到的执行计划,可能从起点就建立在错误估算之上。
再检查锁等待是否影响结果
EXPLAIN 不体现锁行为,因此某条 SQL 看起来计划正常,实际执行却可能卡在事务阻塞上。比较稳妥的做法,是在生产库低峰期针对目标表执行带锁读取,例如:
SELECT ... FOR SHARE然后观察是否被其他事务阻塞。很多“偶发慢查询”问题,最后查出来并不是扫描方式差,而是锁竞争造成的等待。
最后确认耗时到底花在哪一段
要进一步拆解真实耗时,可以结合 SHOW PROFILE 或 performance_schema 观察执行阶段分布。重点是确认瓶颈出现在什么阶段。
- 如果主要耗时落在
Sending data,可能意味着大量数据读取,背后原因往往是磁盘 I/O 或过滤效率低。 - 如果主要耗时落在
Copying to tmp table,则更像是GROUP BY或ORDER BY没有利用好索引,导致临时表开销上升。
这一步的意义在于,把“看起来可能有问题”变成“真实瓶颈已经定位”。
MySQL、PostgreSQL 和 SQLite 的 EXPLAIN 有什么差别
虽然三者都叫 EXPLAIN,但语义并不一样。跨数据库调优时,如果按同一套经验去读,很容易得出错误结论。
PostgreSQL 会真实执行
在 PostgreSQL 里,更常用的是:
EXPLAIN (ANALYZE, BUFFERS)它会真正执行查询,并返回实际耗时以及缓存读写次数。所以在 PG 环境里,只看基础 EXPLAIN 往往不够,真正有诊断价值的是带 ANALYZE 和 BUFFERS 的结果。
MySQL 只给预估,不执行
MySQL 的 EXPLAIN 则始终不会执行查询。这也是前面反复强调要做交叉验证的原因:你看到的是优化器认为会怎么做,而不是数据库已经真实做了什么。
SQLite 更轻量,信息也更少
SQLite 通常使用的是:
EXPLAIN QUERY PLAN它输出的是较为轻量的执行策略,例如“SCAN TABLE users”或“SEARCH TABLE orders USING INDEX idx_user_id”。这足够用来判断有没有使用索引,但不会像 MySQL 那样给出 rows、key_len 之类的估算细节。
因此在 SQLite 里,最直接的判断方式就是看输出中有没有 USING INDEX。如果没有,通常就意味着发生了全表扫描。
执行计划能帮你定位方向,但结论要靠交叉验证
真正让人卡住的,通常不是不认识 EXPLAIN 的字段名,而是把它当成了完整事实。无论是 MySQL 里的 type、key、rows 和 Extra,还是 JSON 结果中的执行树,它们本质上都只是帮助你判断数据库“准备怎么做”。
要把执行计划用对,比较稳妥的顺序是:先从关键字段判断扫描方式和索引命中,再用 FORMAT=JSON 看清 JOIN 与嵌套结构,最后拿真实执行、锁等待和阶段耗时去做交叉验证。这样读 EXPLAIN,才更接近可落地的调优结论。









