


做 Go 后端时,技术栈往往不是“有没有更强的工具”,而是“这套组合能不能让项目稳定往前走”。如果你正准备搭一个从命令行工具到 Web 服务都能复用的基础栈,下面这份清单可以作为一套实战参考:我会按配置、命令行、服务框架、数据库、测试、日志和代码质量几个环节拆开讲清楚它们各自解决什么问题,以及在什么场景下可以换成别的方案。
配置管理:为什么很多项目会先选 Viper
配置管理是 Go 项目的起点。原文里给出的首选是 Viper,核心原因不是“功能多”这么简单,而是它能把项目里常见的几类配置来源统一起来:JSON、YAML、TOML 等文件格式可以读,环境变量和命令行参数也能接进来。
这类能力在实际项目里很重要。开发环境可能依赖本地配置文件,测试环境可能走环境变量,线上又常常要把部分参数交给部署系统注入。如果每种来源都单独处理,配置代码很快就会分散;Viper 的价值在于把这些入口收拢到一套使用方式里。
它在生产环境中更实用的一点,是支持配置热加载。像日志级别、限流阈值这类参数,很多时候都希望在线调整,而不是每改一次就重启服务。Viper 提供的 WatchConfig,正适合这种动态配置场景。
此外,Viper 还支持配置嵌套和默认值设置。对于字段较多、模块较多的项目,这能让配置结构保持清晰,也能减少因为漏配参数导致的启动失败。
适合场景:配置来源较多、环境切换频繁、线上需要动态调整部分参数的服务。
其他选择:envconfig 更专注于环境变量配置,比较适合容器化部署;koanf 可以看作 Viper 的轻量替代品,API 更简洁,性能也更好。
CLI 工具:Cobra 怎么把命令行做得更像正式产品
如果项目里有运维脚本、管理命令、迁移工具,或者服务本身就需要丰富的启动参数,Cobra 通常是非常稳妥的选择。它已经被 Kubernetes、Docker 等知名项目采用,成熟度和生态都比较可靠。
Cobra 最重要的能力,是把命令行工具组织成清晰的多级子命令结构。对用户来说,这比把所有功能都堆在一条长命令里更容易理解;对开发者来说,也更方便按功能拆分实现。
原文举的例子就是一个典型场景:数据迁移工具可以拆成 migrate up、migrate down、migrate status 等子命令。这样设计以后,命令的职责边界更清楚,帮助信息也更好维护。
var rootCmd = &cobra.Command{Use: "myapp"}
var upCmd = &cobra.Command{
    Use:   "up",
    Short: "执行数据库迁移",
    Run:   runMigration,
}
rootCmd.AddCommand(upCmd)
除了子命令层级,Cobra 还有两个很实用的点:一是能自动生成帮助文档,二是能生成 Shell 补全脚本。前者可以减少“命令怎么用”这类重复沟通,后者则能明显提升工具的交互体验,尤其适合内部平台工具或长期维护的 CLI 程序。
适合场景:功能较多的命令行工具、需要多级命令的运维程序、需要标准化帮助信息和补全能力的项目。
其他选择:urfave/cli 的 API 更简洁,适合快速开发小型 CLI;pflag 是标准库 flag 的增强版,支持 POSIX/GNU 风格参数。
Web 服务入口:Gin 适合解决哪些后端问题
在 Web 服务层,原文选择的是 Gin。它之所以常年出现在 Go 后端项目里,关键还是因为性能和开发效率比较平衡。原文提到 Gin 的路由匹配速度较快,这来自它基于前缀树的路由实现。
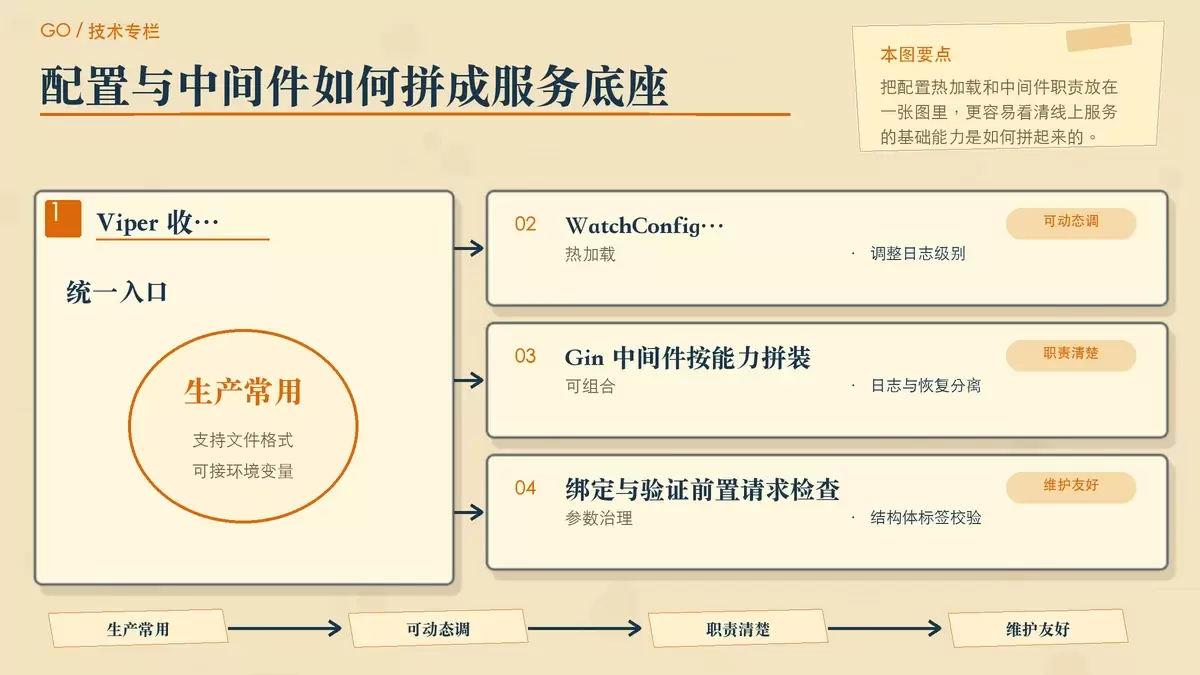
不过对大多数业务项目来说,真正决定是否好用的,往往不是理论性能,而是中间件体系是否顺手。Gin 在这方面的表现比较成熟:请求日志、错误恢复、JWT 认证、请求限流,都可以作为独立中间件接入,再按服务需求组合起来。
这种模式的好处是职责清晰。日志负责观测,请求恢复负责兜底,认证只关心身份校验,限流只处理流量控制。每个中间件都保持单一职责,但串起来之后,服务的基础能力会完整很多。
另一个常被频繁使用的功能是参数绑定和验证。通过结构体标签定义验证规则,可以把“请求参数是否合法”这件事尽量前置,减少控制器里手写判断逻辑的数量,后续维护也更直观。
适合场景:需要较高性能、又希望中间件和参数处理机制成熟的 HTTP 服务。
其他选择:Echo 性能与 Gin 接近,API 设计更现代;Fiber 基于 Fasthttp,追求更极致的性能;Chi 更轻量,且兼容 net/http。
数据库操作:GORM 提升效率的边界在哪里
数据库层如果优先考虑开发效率,GORM 依然是 Go 里最常见的一档选择。原文强调的点包括链式调用、自动迁移、关联查询和事务支持,这些能力确实能覆盖大量常见业务开发需求。
对日常 CRUD 和中等复杂度业务来说,GORM 的优势很直接:不用从零组织大量样板 SQL,模型、查询、事务能放在一套统一抽象里,开发和阅读成本都更低。
原文特别提到了两个在项目里比较实用的机制。第一个是 Scopes。它适合把可复用的查询条件封装起来,比如分页、按状态过滤、按时间范围筛选等逻辑,避免在多个查询函数里复制粘贴。
func Paginate(page, pageSize int) func(db *gorm.DB) *gorm.DB {
    return func(db *gorm.DB) *gorm.DB {
        return db.Offset((page - 1) * pageSize).Limit(pageSize)
    }
}
第二个是 Hook 机制。像创建时间、更新时间这类字段自动填充,或者写入前做一些统一校验,都可以通过 Hook 实现。这样能把一部分横切逻辑从业务代码里抽离出来。
当然,GORM 也不是所有场景都最合适。如果项目非常依赖复杂 SQL、执行计划优化或者数据库特性本身,那更贴近 SQL 的方案往往更容易掌控。
适合场景:以开发效率和统一抽象为优先的大多数业务服务。
其他选择:sqlx 是轻量级扩展,适合需要精细控制 SQL 的场景;ent 是 Facebook 开源的 ORM,强调类型安全,更适合大型项目;sqlc 则根据 SQL 生成类型安全的 Go 代码。
测试体系:单元、集成、端到端分别怎么配工具
测试部分是这篇文章里非常值得保留的一段,因为它没有把“测试”泛泛而谈,而是明确拆成了单元测试、集成测试和端到端测试三层。对 Go 项目来说,这种分层思路通常比只强调某一个测试框架更重要。
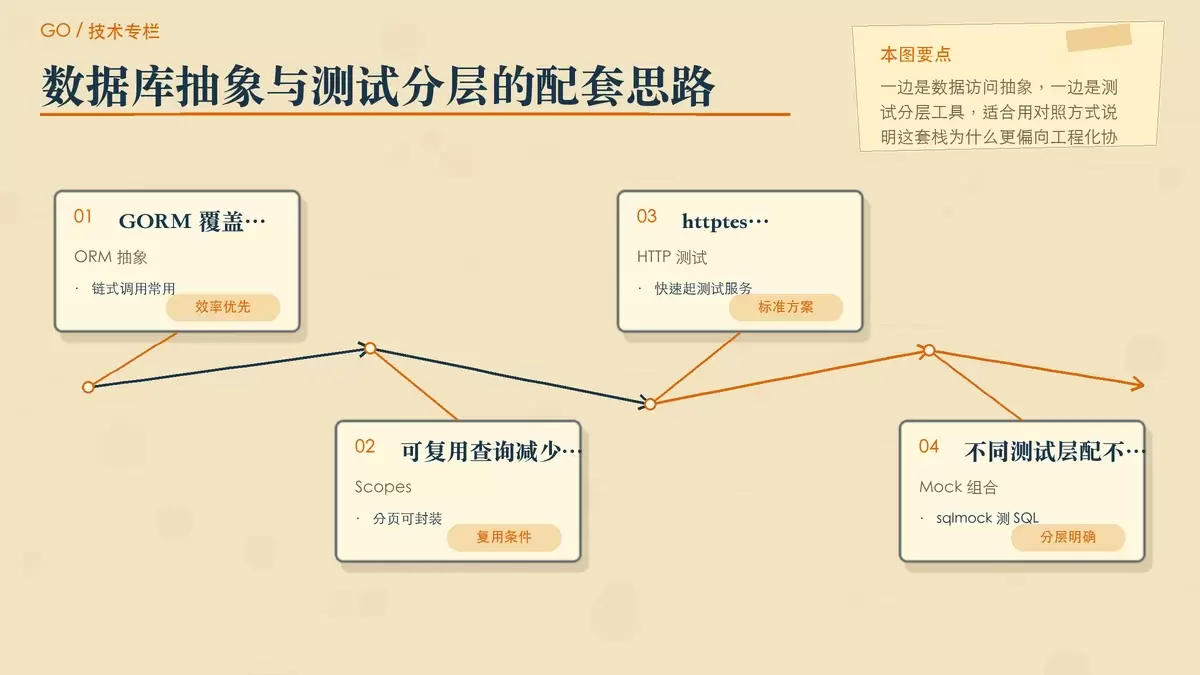
HTTP 服务测试里,httptest 依然是标准选择。它来自标准库,足够轻量,也足够实用,可以快速起一个测试服务器来覆盖接口行为。
数据库测试场景中,sqlmock 的价值在于:不连接真实数据库,也能验证 SQL 相关逻辑是否符合预期。对于需要高频执行、希望保持快速反馈的测试集来说,这一点很有帮助。
在依赖注入和接口替身方面,原文给了两个常见组合:gomock 和 testify/mock。前者更适合接口复杂、约束严格的场景,后者的 API 相对更友好,上手成本更低。
至于断言库,testify/assert 基本已经是很多团队的默认选项。像 assert.Equal、assert.NotNil 这种断言方式,可读性会比手写一串判断逻辑更好,失败时给出的错误信息也更具体。
这套组合的核心思路可以概括为:不同层次的测试解决不同问题,而不是试图用一种工具覆盖全部质量保障工作。单元测试追求反馈快,集成测试关注组件协作,端到端测试负责兜底关键业务流程。
其他选择:Ginkgo 是 BDD 风格测试框架,适合行为驱动测试;GoConvey 提供 Web 界面,可以实时展示测试结果。
日志系统:为什么高并发服务会偏向 Zerolog
日志并不只是“把信息打出来”,更关键的是在真实故障里能不能快速定位问题。原文选择 Zerolog,主要看中它的零分配和高性能特点。在日志量较大的服务里,这种性能优势会更明显。
除了性能,结构化日志才是它真正的使用重点。日志如果只是自由文本,后续检索和分析会非常困难;而把请求 ID、用户 ID、接口名、错误码这类上下文都结构化写出去,排查链路会顺畅很多。
log.Info().
    Str("request_id", requestID).
    Int("user_id", userID).
    Msg("用户登录成功")
这段写法已经很能说明 Zerolog 的特点:字段和消息是分开的,业务上下文可以自然附着在每条日志上。对于集中式日志系统来说,这种格式也更容易被采集、过滤和聚合。
原文还提到日志级别动态调整,这在生产环境里尤其有用。平时保持较低日志级别控制成本,遇到问题再临时提高详细程度,既能减少噪音,也能避免长期输出过多无效日志。
适合场景:日志量大、关注性能、需要结构化字段做排查和分析的后端服务。
其他选择:zap 是 Uber 开源的高性能日志库,功能全面;logrus API 友好、扩展性强;slog 是 Go 1.21 新增的标准库结构化日志方案。
代码质量:把规范、静态分析和安全检查接进流水线
如果前面的工具解决的是“怎么开发”,那代码质量工具解决的就是“怎么长期维护”。这一部分原文给出的思路比较完整:格式化、Lint、静态分析和安全扫描分别承担不同职责,而且最好全部自动化。
golangci-lint 是这里的主力。它集成了数十个 linter,能同时覆盖静态分析、代码规范检查和一部分性能建议。把它接入 CI/CD 之后,每次提交自动执行,能尽早拦住不符合规范的代码进入主分支。
格式化层面,gofmt 和 goimports 依然是标准搭配。gofmt 统一代码风格,减少团队在格式问题上的沟通成本;goimports 则顺手把 import 管理掉,自动补全缺失包、删除未使用包。
staticcheck 更偏向深入的静态分析,擅长发现潜在 bug、性能问题和代码异味;gosec 则把重点放在安全扫描上,例如 SQL 注入风险、硬编码密钥等问题。
把这些工具拆开看,各自只是一个检查器;但把它们放进同一条研发流程里,效果会明显不同。格式统一保证可读性,Lint 保证基础规范,静态分析提前暴露风险,安全扫描降低上线隐患。
其他选择:revive 是 golint 的替代品,性能更好;ineffassign 专门检测未使用赋值;errcheck 则专注于错误处理检查。
怎么把这套栈用到自己的项目里
从原文给出的组合来看,这是一套偏“生产可用”的 Go 技术栈:它既能覆盖 CLI 工具,也能支撑 Web 服务,还兼顾了测试、日志和代码质量这些容易被后置的问题。
原文最后也提醒了一点,这很关键:完整项目当然不只这些工具。Redis 缓存、Kafka 消息队列、Prometheus 监控、Docker 容器化、Kubernetes 编排、gRPC 微服务通信、JWT 认证授权,都会随着项目规模继续加入。
真正的选型重点,不是追求“最流行”的组合,而是看它是否适合团队和项目阶段。小型项目可以优先选更轻量的方案,把复杂度留到后面;大型项目则更看重能力完整、边界清晰和协作效率。把基础设施、开发效率和长期维护一起考虑,这套 Go 技术栈的价值才会真正体现出来。









