

数据库分库分表:ShardingSphere与Vitess对比

先搞懂分库分表:为什么分、怎么分
分库分表的核心在于突破单机数据库的存储与性能瓶颈。垂直拆分按业务模块将不同表拆分至独立数据库,如将用户表与订单表分离;水平分片则是将同一张大表按规则切分到多个物理节点。以电商订单系统为例,初期单库单表可支撑万级QPS,但随着数据量突破千万,需引入分片键(如user_id)进行水平拆分。路由层根据分片键计算目标库表,将请求精准投递。若分片键选择不当(如按创建时间分片),会导致近期数据集中写入单一节点形成热点,且跨分片查询(如按订单号查非分片键数据)将退化为全库广播扫描,严重拖慢性能。此外,错误的路由策略会使后续扩容面临数据重分布难题,因此在架构初期必须结合业务查询模式与数据增长趋势审慎设计分片策略。
架构对比:ShardingSphere与Vitess到底差在哪
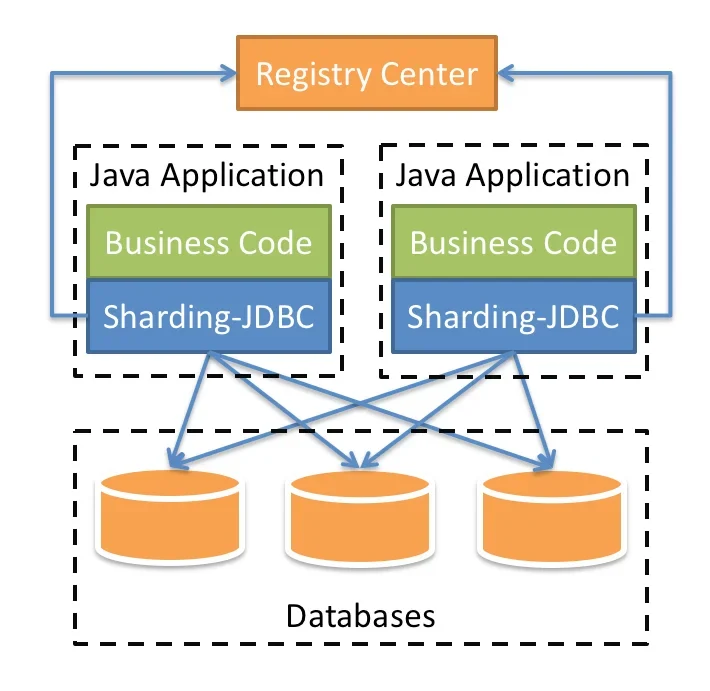
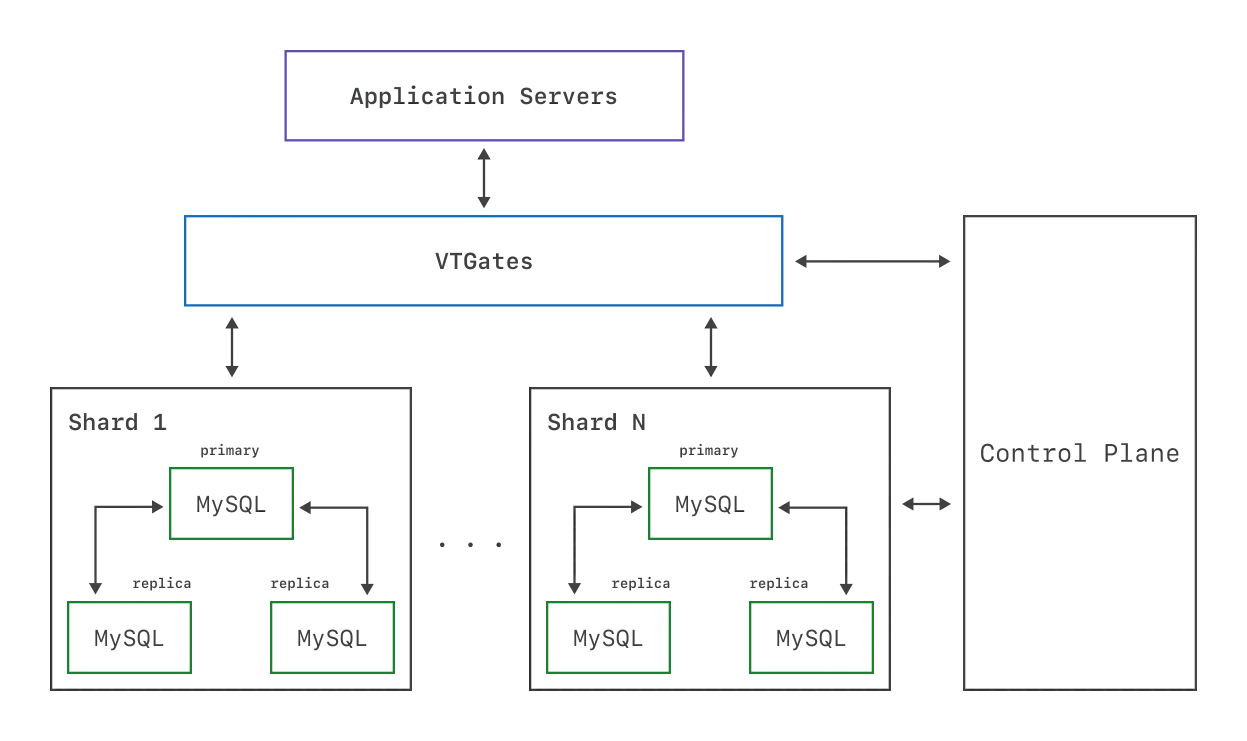
ShardingSphere与Vitess在架构定位与请求链路上存在本质差异。ShardingSphere定位为轻量级数据库中间件,以接入层形式部署在应用与数据库之间。其核心链路包含SQL解析、路由计算、SQL改写、执行引擎与结果归并,对应用透明,开发者无需修改业务代码即可实现分片逻辑。Vitess则是由YouTube开源的云原生数据库编排系统,采用VTGate作为无状态代理层,通过VSchema定义逻辑表与物理Shard的映射关系,结合Vindex实现高效路由。Vitess将MySQL集群抽象为Keyspace与Shard,由VTTablet管理底层MySQL实例,具备更强的集群自治与拓扑管理能力。简言之,ShardingSphere偏向“SQL网关+分片逻辑”,而Vitess是“数据库代理+集群管控平台”,两者在控制面与数据面的职责划分截然不同。
核心能力实战:分片配置、路由与扩容迁移
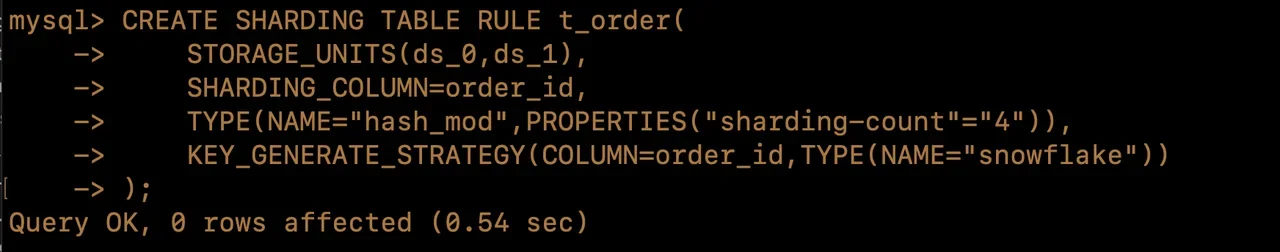
在实际配置中,ShardingSphere通过YAML或Java API定义逻辑表、分片键与分片算法(如inline、hash_mod),路由时自动将SELECT * FROM t_order WHERE user_id = 1改写为针对特定物理表的查询。若查询未携带分片键,则触发全分片广播。Vitess则依赖VSchema文件声明Keyspace结构,通过配置Vindex(如lookup、hash)建立分片键到Shard的映射。查询命中单分片时延迟极低,跨分片查询则由VTGate协调多个Shard并行执行并归并结果。扩容方面,ShardingSphere需借助数据迁移工具(如ShardingSphere-Scaling)进行双写与增量同步,手动触发数据重分布;Vitess提供原生的Resharding工作流,通过VReplication实现平滑数据迁移与流量切换,支持在线调整Shard数量,大幅降低运维中断风险。
怎么选:性能、运维、兼容性与适用场景对照
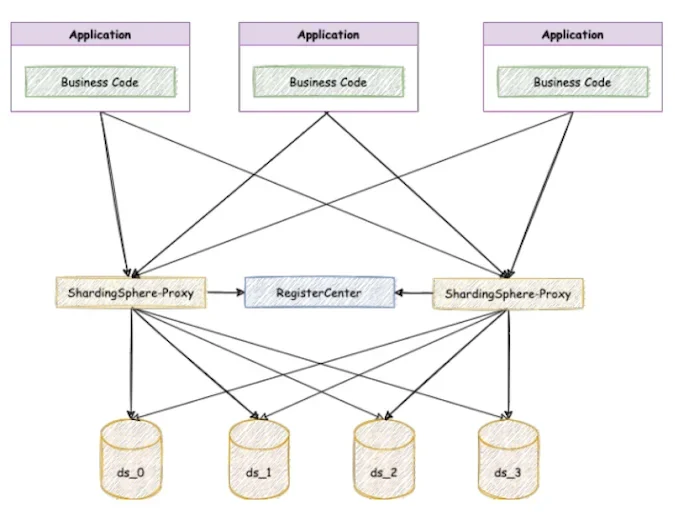
选型需从多维度综合评估。接入方式上,ShardingSphere支持JDBC/Proxy双模式,应用改造成本极低;Vitess需通过VTGate代理,对部分ORM框架需适配。MySQL兼容性方面,两者均高度兼容MySQL协议,但ShardingSphere对复杂SQL(如多表JOIN、子查询)支持更完善,Vitess在跨分片JOIN与聚合函数上存在限制。事务层面,ShardingSphere提供柔性事务(Seata集成)与XA,Vitess依赖分布式事务协议(2PC)与VStream。读写分离两者均原生支持,但Vitess在弹性扩缩容与故障自愈上更胜一筹,适合云原生环境。若团队以Java为主、追求快速落地且SQL复杂度高,ShardingSphere是优选;若运行在Kubernetes、需大规模集群自治与平滑扩容,Vitess更具优势。切忌脱离业务规模与运维能力盲目选型。
验证与避坑:上线前必须检查什么
上线前必须执行严格的验证清单。首先校验分片键数据分布,通过抽样统计确认无倾斜与热点;其次压测单分片与跨分片SQL,重点验证JOIN、ORDER BY、GROUP BY及深度分页的性能衰减。事务一致性需通过模拟网络分区验证最终一致性或强一致性表现。主键生成策略(如雪花算法)必须全局唯一且单调递增,避免分片冲突。扩容迁移阶段需进行全量与增量数据校验,比对源端与目标端记录数及关键字段哈希值。监控体系需覆盖QPS、P99延迟、连接池水位、分片负载及数据同步延迟,并配置分级告警。最后务必开展故障演练(如节点宕机、网络抖动),验证自动切换与降级策略。特别注意:单库压测指标无法代表分片集群真实性能,跨分片路由开销与网络延迟会显著放大响应时间,必须在全链路压测环境下评估。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









