


请求统计看起来只是“写一条日志、把计数加一”,但一到并发场景,问题往往马上出现:要么插入时报唯一键冲突,要么统计值在高峰期不准。ThinkPHP 默认的 Db::insert()、模型 save() 并不会自动帮你处理幂等和竞态,所以这类报错通常不是框架故障,而是写入策略本身不适合并发。
要把这件事处理稳,关键是先明确两点:一是统计记录的“重复”到底由哪些业务字段定义,二是你的计数是否要求逐次精确。下面就按这两个判断依据,拆开看 MySQL 直写和 Redis 缓冲两条常见方案分别该怎么落地。
并发写入为什么会报唯一键冲突
ThinkPHP 中如果直接用 Db::insert() 或模型 save() 写请求统计,而没有做幂等控制,多个请求几乎同时到达时,就很容易进入同一条竞争路径:都先判断“记录不存在”,随后都执行插入。这样一来,最终就会撞上业务唯一键,或者把主键策略用乱。
典型报错一般是:
SQLSTATE[23000]: Integrity constraint violation: 1062 Duplicate entry
这类问题的根源,不在于“插入太快”,而在于插入前后的判断不是原子操作。只要采用“先 select,再 insert/update”的两步法,中间就一定存在竞态窗口,并发一高就会暴露出来。
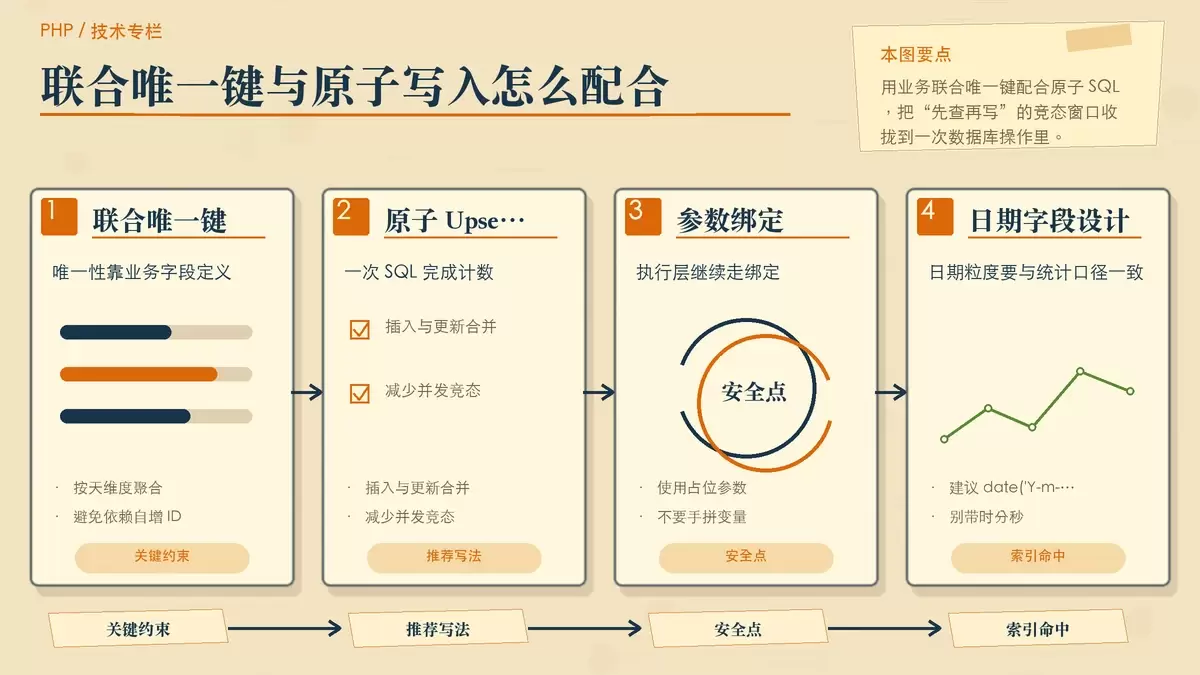
更稳妥的做法是先把统计表的唯一性定义清楚。请求统计通常不应该依赖自增 ID 判断重复,而应该直接把业务维度设成联合唯一键,例如:
UNIQUE KEY `uk_date_module_action` (`date`, `module`, `action`)这意味着同一天、同模块、同动作只允许存在一条聚合记录。只有把这个约束落在表结构上,后面的幂等写入才有基础。反过来说,如果表里没有唯一索引,那么单纯的 INSERT 本身就不具备幂等能力,因为数据库根本不知道哪两条记录在业务上算重复。
ThinkPHP 里怎样正确写原子更新 SQL
在 ThinkPHP 里,save() 和 insert() 并不直接提供 ON DUPLICATE KEY UPDATE 这种足够可控的写法。要处理统计计数,通常还是建议用 Db::execute() 手写 SQL,把插入和更新压成一次原子操作。
示例可以直接写成:
$sql = "INSERT INTO `log_request_count` (`date`, `module`, `action`, `count`)
VALUES (?, ?, ?, 1)
ON DUPLICATE KEY UPDATE `count` = `count` + 1";
Db::execute($sql, [$date, $module, $action]);
这段写法的重点有三个。
先有唯一键,再谈重复更新
如果表里没有 UNIQUE KEY(date, module, action),那么 ON DUPLICATE KEY UPDATE 根本不会触发,SQL 只会继续插入新行。也就是说,幂等不是靠 PHP 代码“猜”出来的,而是靠数据库唯一约束“挡”出来的。
参数必须绑定,不能手拼变量
像 "'{$date}'" 这种直接拼 SQL 的方式不要用,统计接口同样有注入风险。这里应该继续走参数绑定:
Db::execute($sql, [$date, $module, $action]);这样既安全,也能避免不同类型字段在拼接时出现隐性格式问题。
date 字段要保持可索引
$date 更适合使用 date('Y-m-d') 这种按天聚合的格式,而不是时间戳或带时分秒的完整时间。因为你的唯一键是按天统计,字段值如果粒度过细,等于主动把本来应该命中的唯一索引拆散了,最终既影响命中率,也让统计语义变得混乱。
用了 ON DUPLICATE KEY UPDATE,计数为什么还可能不准
很多人处理完唯一键冲突后,会以为问题已经结束。但在线上高并发下,另一个更隐蔽的问题是:count 字段可能看似正常更新,最后总数却偏小。
这里需要区分“写法正确”和“结果精确”不是一回事。原文场景里提到,在 MySQL 默认的 REPEATABLE READ 隔离级别下,多个事务同时执行 count = count + 1,可能因为行锁与事务快照的影响,最终结果没有达到预期累计次数。无论是否把这个现象归结为框架层,至少可以确定一点:统计计数在高并发下不能只看 SQL 能不能执行成功,还要看它是否符合你的精度要求。
常见处理方向主要有三种:
方案一:强制串行
可以对目标记录使用 SELECT ... FOR UPDATE 加锁,再执行更新。这样做的优点是逻辑直观,缺点也很明显:吞吐量会下降,锁等待会放大,统计类场景通常不值得为了这一类写操作把数据库拖慢。
方案二:保持增量表达为原子操作
更适合统计场景的写法,是把每次请求的增量明确写进插入值,再在重复键更新时引用这个增量。例如:
INSERT ... ON DUPLICATE KEY UPDATE count = count + VALUES(count)这里的关键不是把数字写死,而是通过 VALUES(count) 引用本次插入的增量。这样做的好处是,SQL 语义上更明确:每次冲突时,都按当前这次请求携带的增量去累加。如果每次请求只加 1,那么前面的示例里直接写 VALUES (?, ?, ?, 1) 也是成立的,本质上表达的是同一件事。
方案三:承认实时精确的成本很高
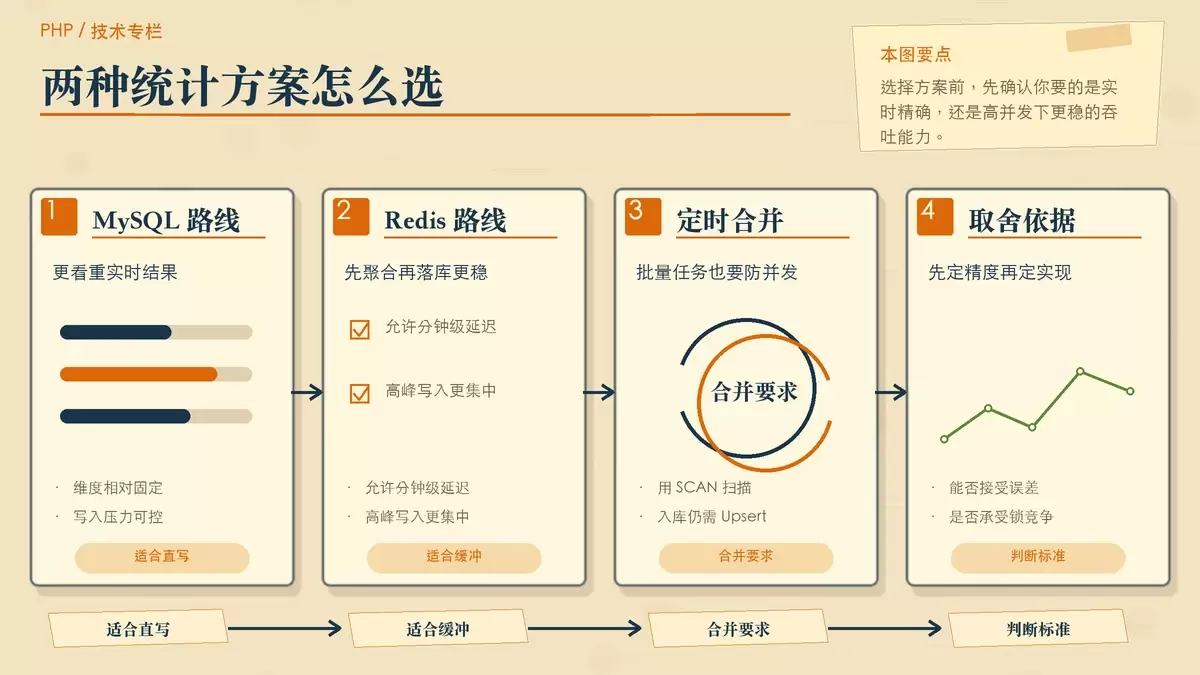
如果业务真的要求“每个请求都不能丢、计数必须实时且绝对精确”,那就要接受数据库行锁、重试逻辑甚至热点行竞争带来的复杂度。很多场景里,真正需要先确定的不是代码细节,而是统计精度标准:到底是必须逐次精确,还是允许一个很小的误差范围,比如 ±0.1%。这个判断会直接决定你是否应该继续坚持 MySQL 直写。
Redis 预聚合再入库,适合什么场景
如果你的业务允许分钟级延迟,例如运营看板刷新周期大于 1 分钟,那么把请求计数先写入 Redis,再由定时任务批量合并进 MySQL,通常会比每次请求都直写数据库更稳。
这种方式的核心思路是:把高频、分散的小写入先变成内存中的原子累加,再定时集中落库,减少 MySQL 热点更新压力。原文给出的 key 设计示例是:
req:count:20240520:api:user:login
同时建议设置 2 天过期时间,避免无效 key 长期堆积。
Redis 层做什么
请求到来时,直接使用 INCRBY 对对应 key 累加。Redis 天然适合这种高并发计数场景,接口处理链路也会更轻。
定时任务怎么合并
可以每 5 分钟执行一次任务,用 SCAN 扫描匹配的 key,然后通过 GETDEL 或 DEL + GET 取值并清空,最后批量写回 MySQL。这里有几个细节不能省:
- 不要使用
KEYS,否则会阻塞 Redis - 合并入库时,仍然要使用
INSERT ... ON DUPLICATE KEY UPDATE,因为定时任务自身也可能并发 - 需要记录最后合并时间戳,避免漏掉刚写入但尚未被本轮扫描处理的 key
这说明 Redis 方案并不是“把数据库问题转移掉”这么简单,它本质上是用更高吞吐换取一定延迟,再通过合并任务补齐最终一致性。
该选 MySQL 直写还是 Redis 缓冲
如果你的统计数据必须尽量实时、且维度不多、写入压力也可控,那么直接在 MySQL 中建立联合唯一键,并配合 INSERT ... ON DUPLICATE KEY UPDATE,通常就已经足够。这条路线的重点是结构要先定对,避免“先查再写”的竞态设计。
如果你的接口调用量大、热点集中,而且业务接受分钟级延迟,那么 Redis 的 INCRBY + 定时合并会更适合。它的优势不是绝对精确,而是更能扛并发、更容易把数据库压力控制在稳定范围内。
归根结底,这道题没有脱离业务要求的标准答案。你需要先判断的是:系统更怕计数偶发误差,还是更怕数据库在高并发下被持续写爆。把这个优先级排清楚,再选实现方式,后续代码反而不会太复杂。









