AI Agent工作原理:工具调用、记忆与任务规划
从一次用户指令出发,拆解AI Agent如何理解目标、规划任务、调用工具、管理记忆并验证结果,帮助读者建立可落地的Agent工作模型,同时识别常见失控与失败原因。
2026-09-15
6

从一次用户指令出发,拆解AI Agent如何理解目标、规划任务、调用工具、管理记忆并验证结果,帮助读者建立可落地的Agent工作模型,同时识别常见失控与失败原因。
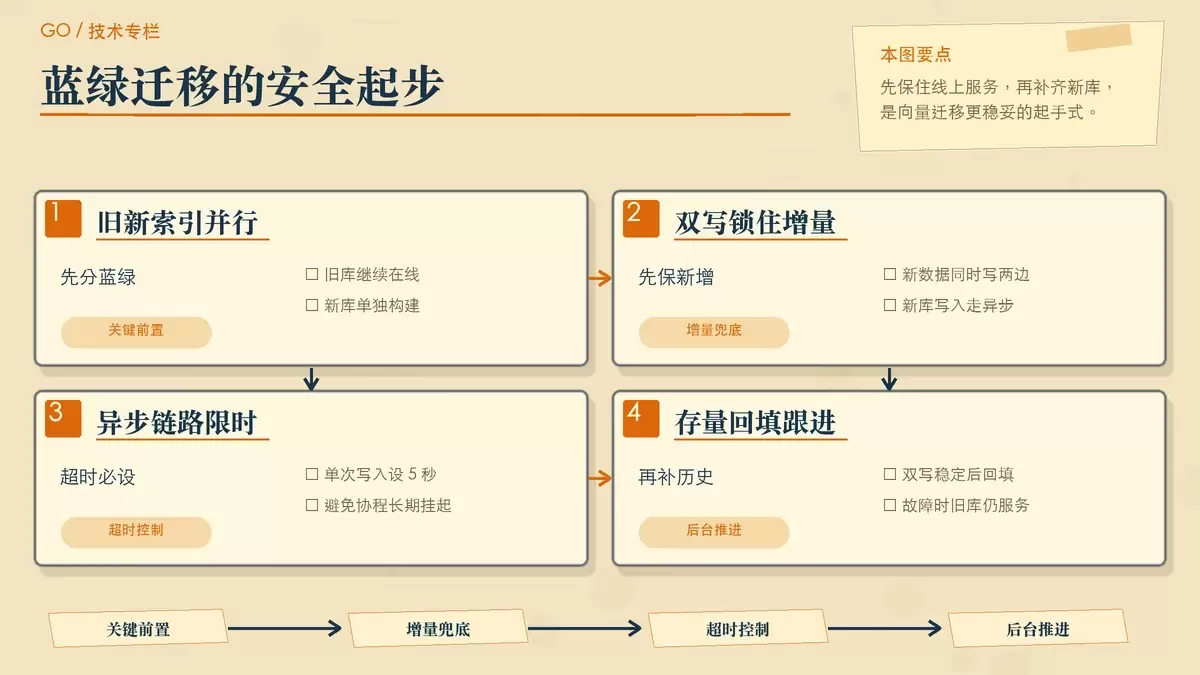
Embedding 模型一旦更换,旧向量就不再处于同一坐标系,直接迁移库文件并不能解决问题。本文结合 Go 实战,拆解向量数据平滑重构的关键做法:双写兜底、流式回填、并发限速、向量库写入优化,以及切换前的效果校验。
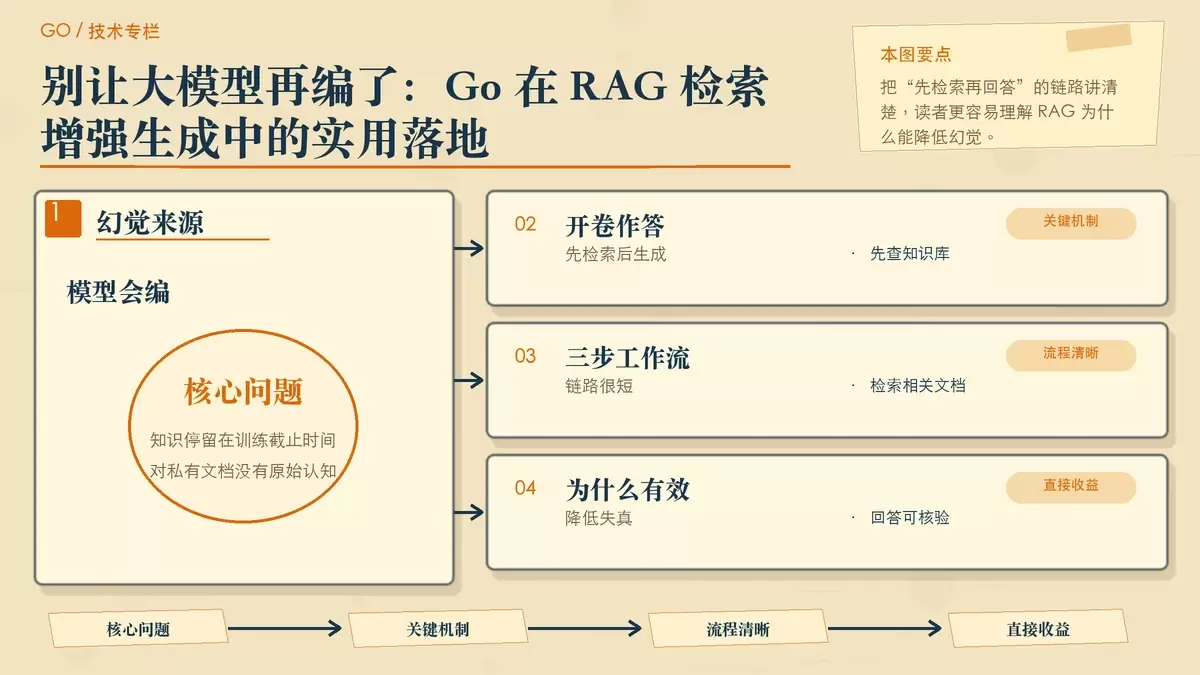
RAG 的价值不在于让大模型“更聪明”,而在于先把可验证的资料找出来,再让模型基于上下文作答。本文从幻觉问题出发,解释 Naive RAG 的常见短板、生产级优化思路,以及如何用 Go 配合 LangChainGo 快速搭出一条可运行的检索问答链。
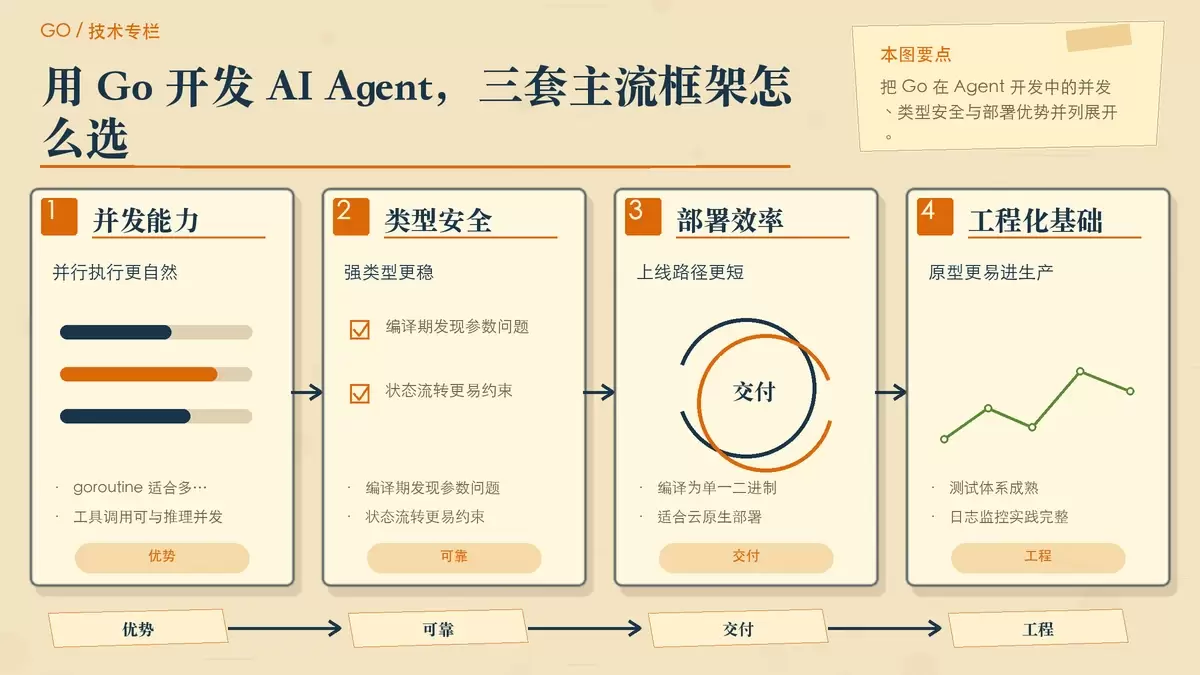
Go 不只是高并发后端语言,也开始成为构建 AI Agent 的现实选择。本文从并发、类型安全和部署效率切入,对比 LangChainGo、Google ADK-Go、Eino 三个代表性框架,并给出按团队栈、项目复杂度和生态诉求做判断的选型思路。
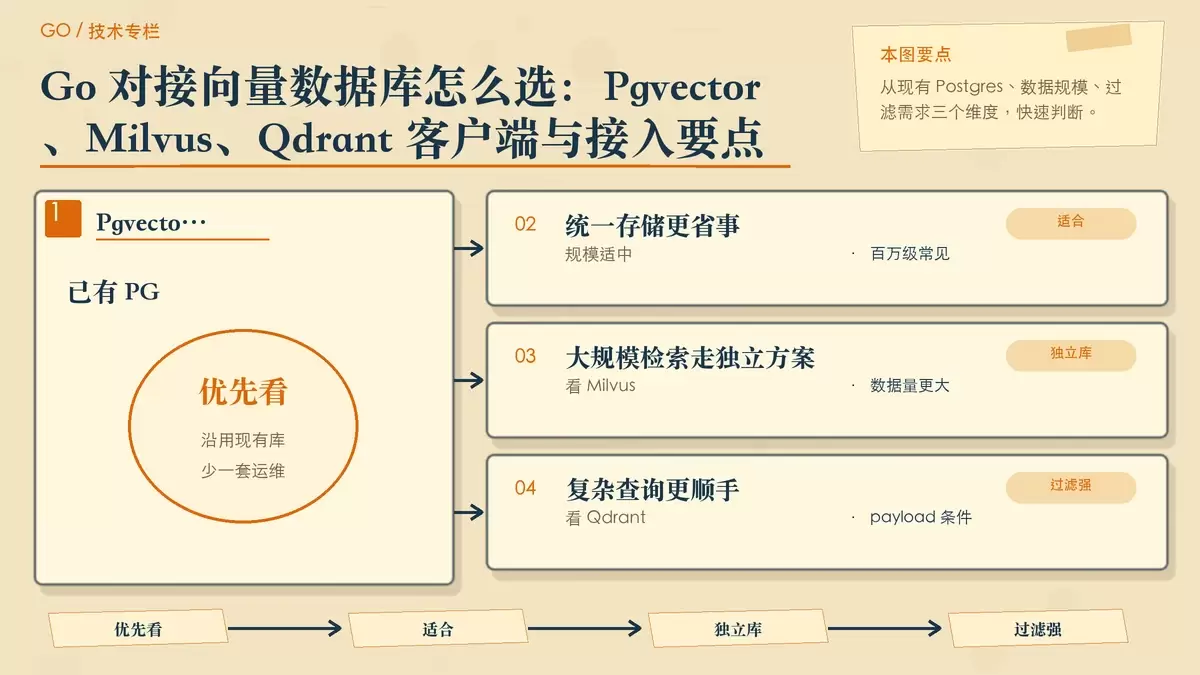
在 Go 项目里接入向量检索,常见路线通常落在 Pgvector、Milvus 和 Qdrant 三种方案。它们分别对应“沿用 Postgres”“独立扩展大规模向量库”“更重视过滤与多向量能力”三类需求,客户端使用方式和接入成本也差异明显。
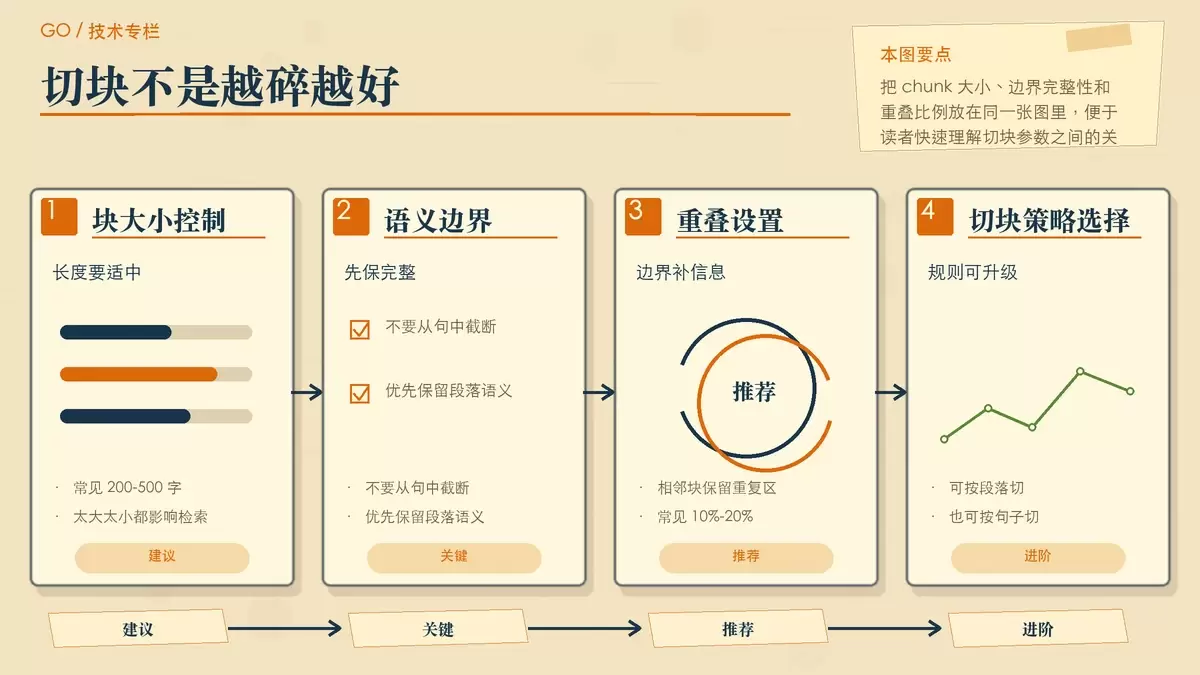
这篇文章用 Go 把 RAG 的核心链路拆成三步:文档切块、Embedding 向量化和相似度检索。你可以直接看懂最小实现,也能据此判断 chunk 大小、重叠比例、Top-K、向量库选型这些参数该怎么取。 想让大模型真正读懂企业知识库,关键不在于把文档一股脑塞进提示词,而在于先把内容拆成可检索的片段,再按问题取回最相关的上。
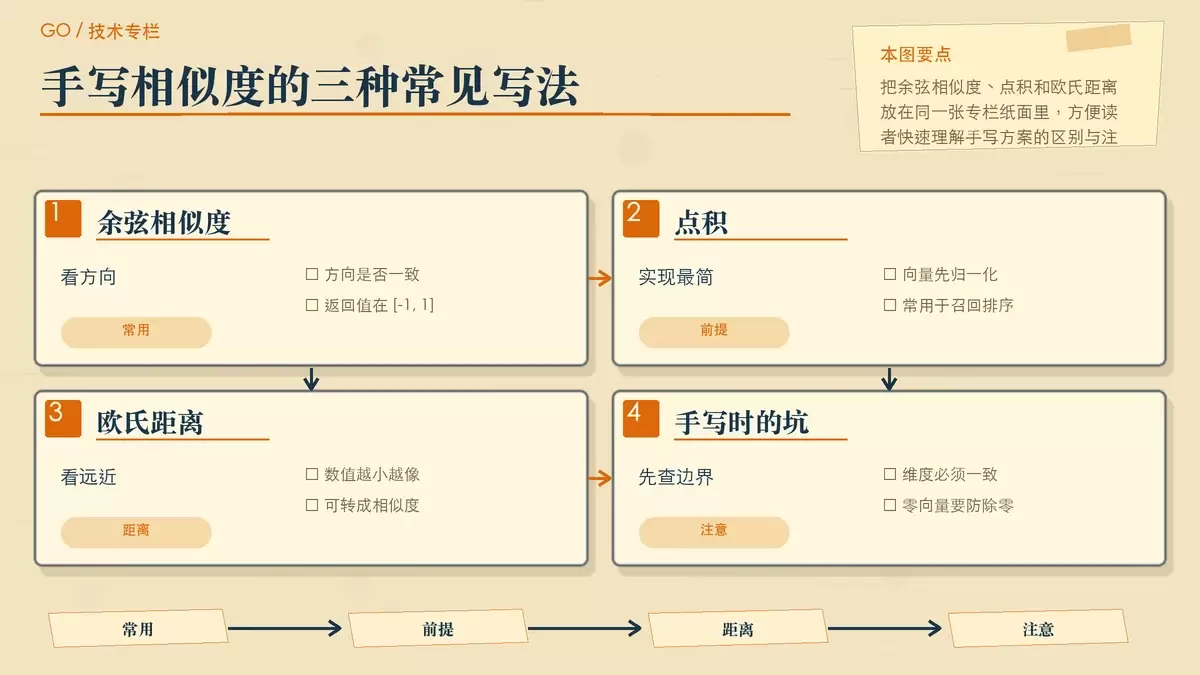
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。