如何避免 SQL 存储过程出现死循环?
SQL 存储过程里的死循环,往往不是语法不会写,而是退出机制、计数保护和调试手段没统一。本文结合 MySQL 与 PostgreSQL 的典型场景,梳理合法退出方式、硬性上限写法,以及排查挂起过程时更有效的检查路径。
2026-08-25
148

SQL 存储过程里的死循环,往往不是语法不会写,而是退出机制、计数保护和调试手段没统一。本文结合 MySQL 与 PostgreSQL 的典型场景,梳理合法退出方式、硬性上限写法,以及排查挂起过程时更有效的检查路径。
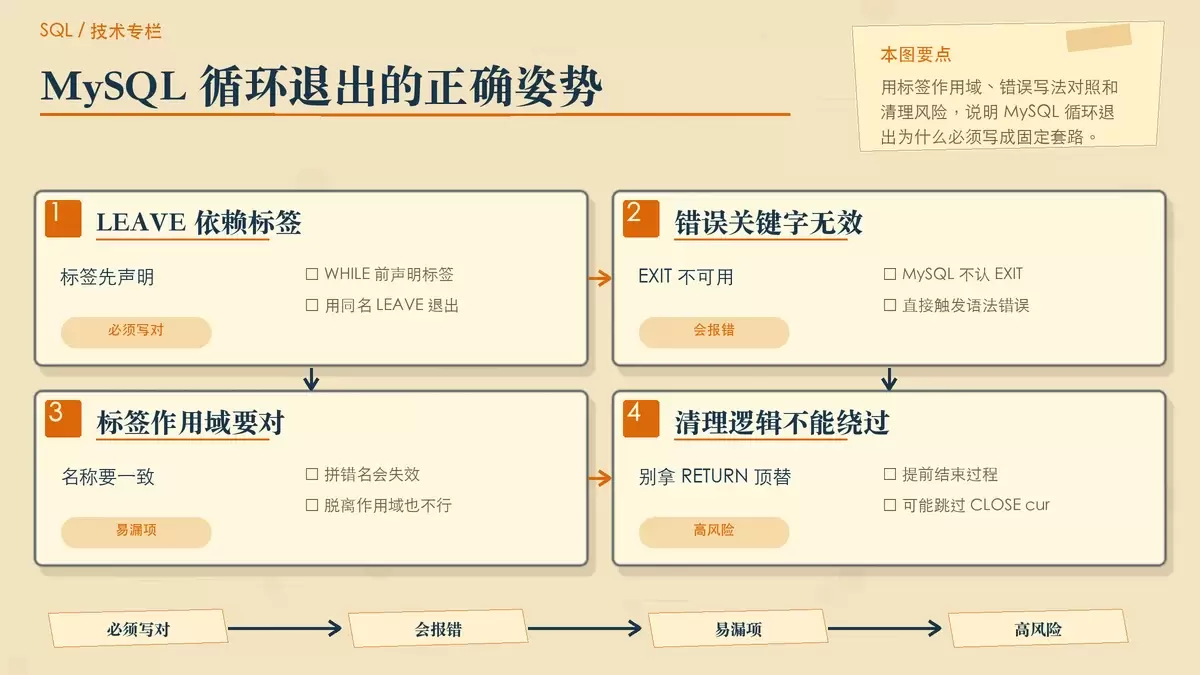
在高并发系统里,缓存一旦失效,热点请求会同时打到数据库,典型后果就是缓存击穿。本文围绕 Go 的 singleflight 展开,说明它如何用“同 key 请求合并”减少重复查询,并结合示例、方法说明与使用边界,帮助你判断它适不适合放进现有缓存链路。
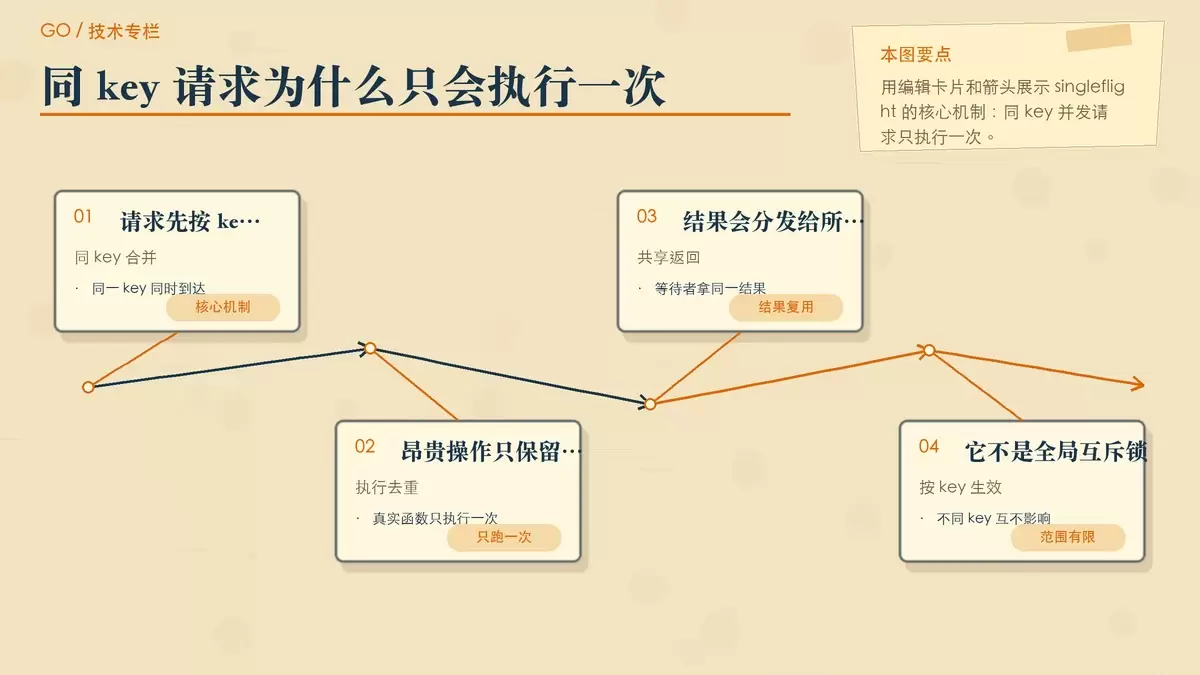
在 SQL 视图里直接格式化日期时间字段,技术上可行,但多数场景并不划算。因为一旦把日期转成字符串,索引利用、排序语义和跨数据库兼容性都会受影响。只有下游明确只接收字符串、且不再做日期计算时,才适合把格式化逻辑固定在视图中。
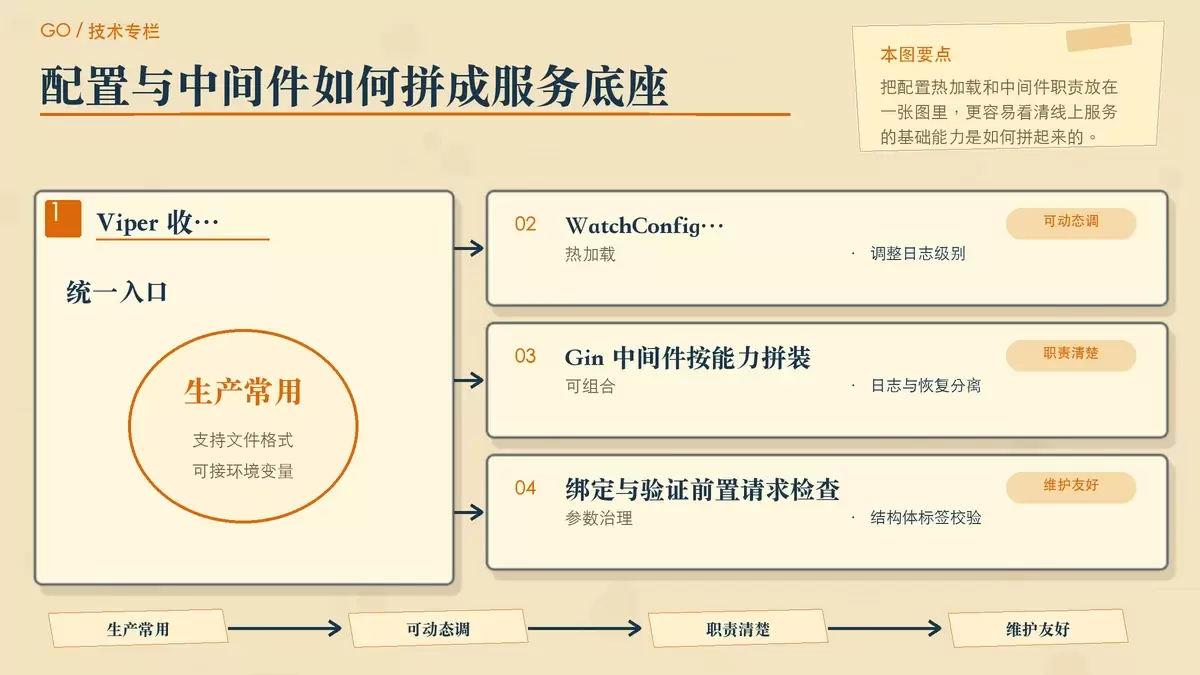
这篇文章把一套常见的 Go 后端技术栈按“项目里到底要解决什么问题”重新拆开,覆盖配置、CLI、Web、数据库、测试、日志和代码质量七个环节。每一部分都保留原文提到的工具特性、替代方案与关键代码,方便你按项目规模、部署方式和团队习惯判断该怎么组合。
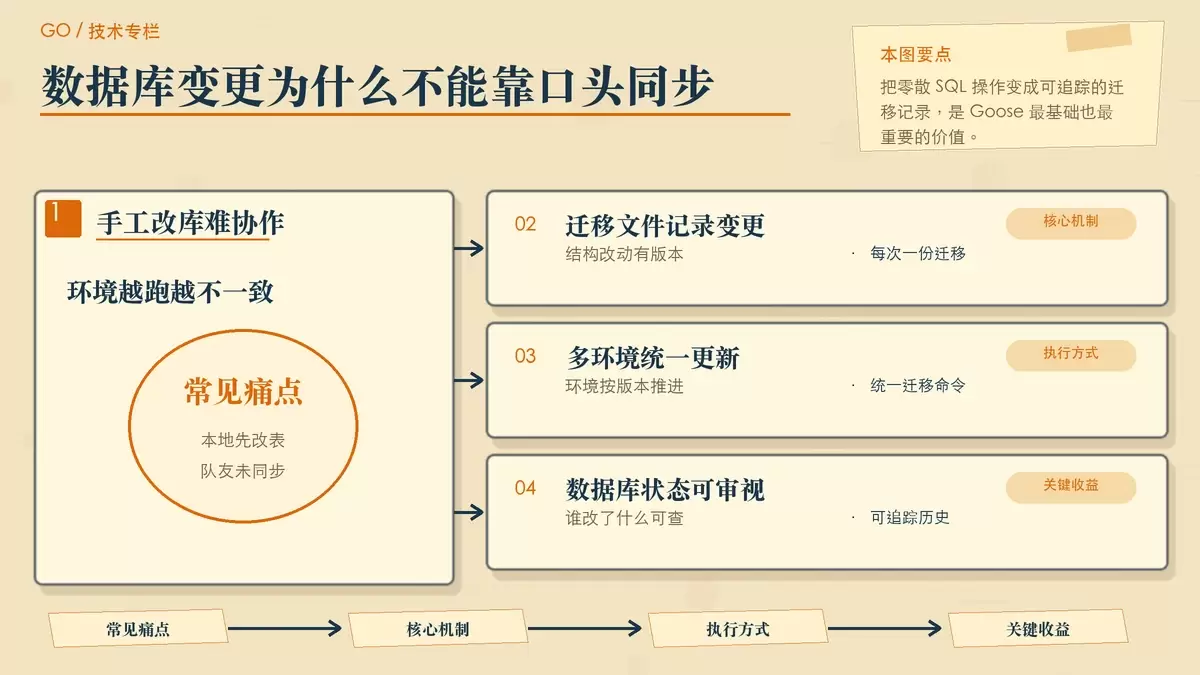
Go 团队在没有专职 DBA 的情况下,最容易把数据库结构改动做成“口头同步”:本地改了、测试漏了、线上再出错。Goose 的价值就在于把每次表结构调整写成可执行、可回滚、可追踪的迁移文件,让数据库变更和代码版本一起管理。
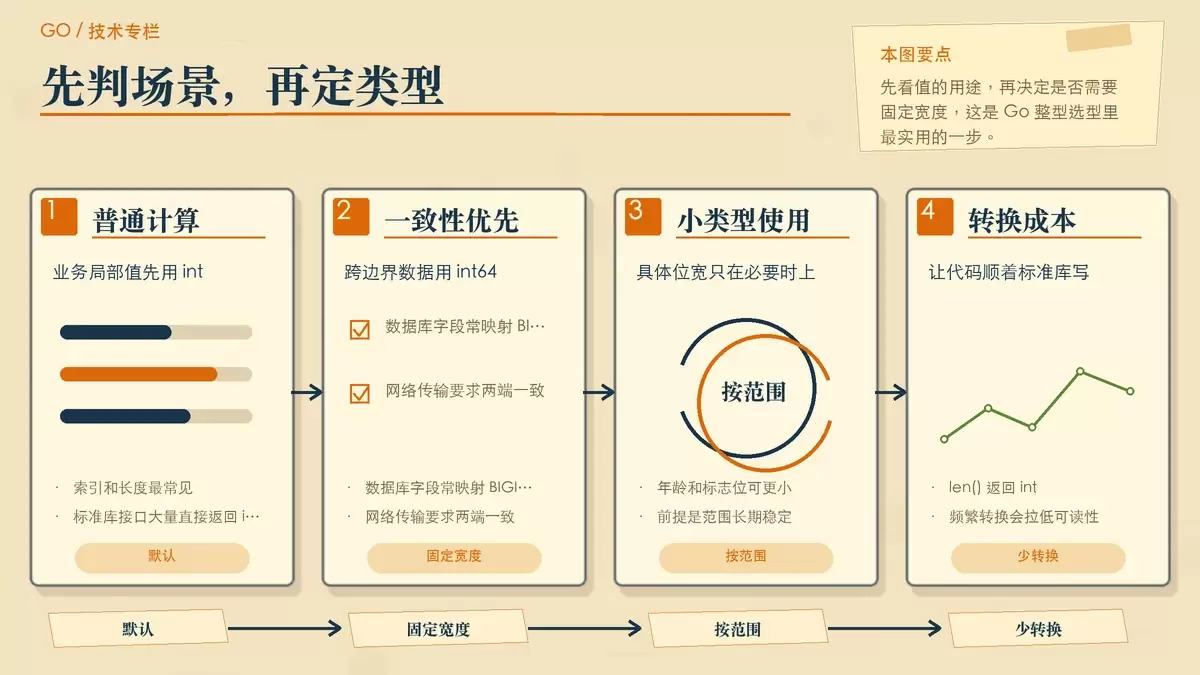
Go 里整型很多,但真正高频纠结的往往是 int 和 int64。本文把平台差异、标准库习惯、跨平台数据一致性以及常见溢出与 JSON 精度问题拆开说明,帮助你在业务代码、数据库字段和高数据量场景里做出更稳妥的选择。
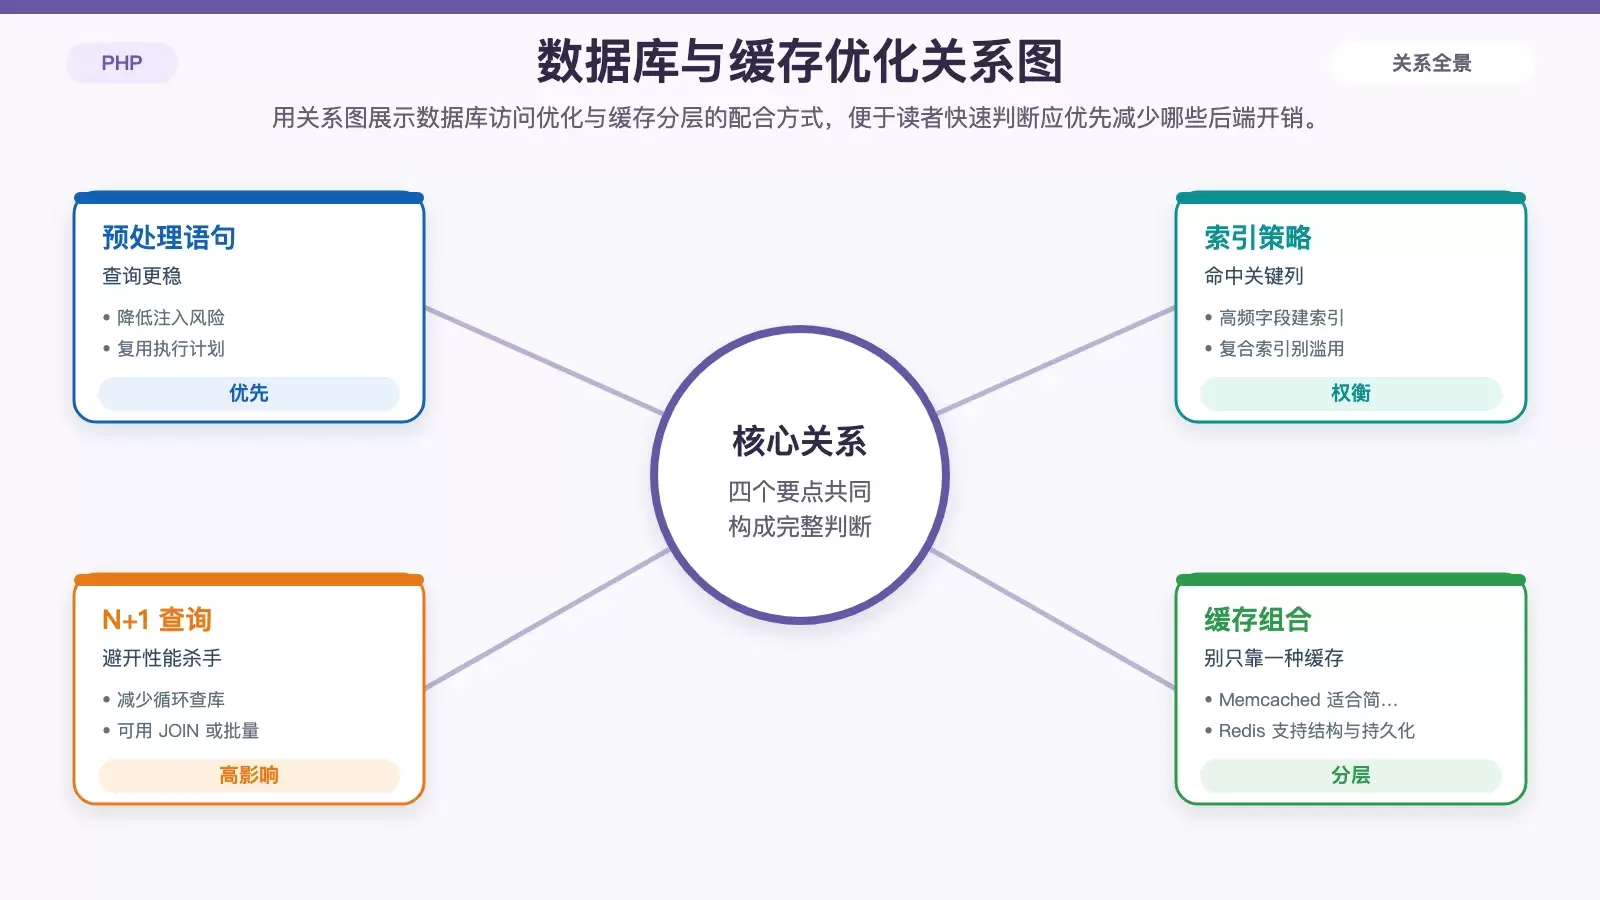
在 LNMP 架构里,PHP 性能问题往往不只出在语法本身,而是版本、数据库访问、缓存、资源管理和异步处理共同叠加的结果。本文按实际优化链路重组要点,帮助你快速判断哪些做法最值得优先落地,哪些习惯最容易拖慢线上服务。
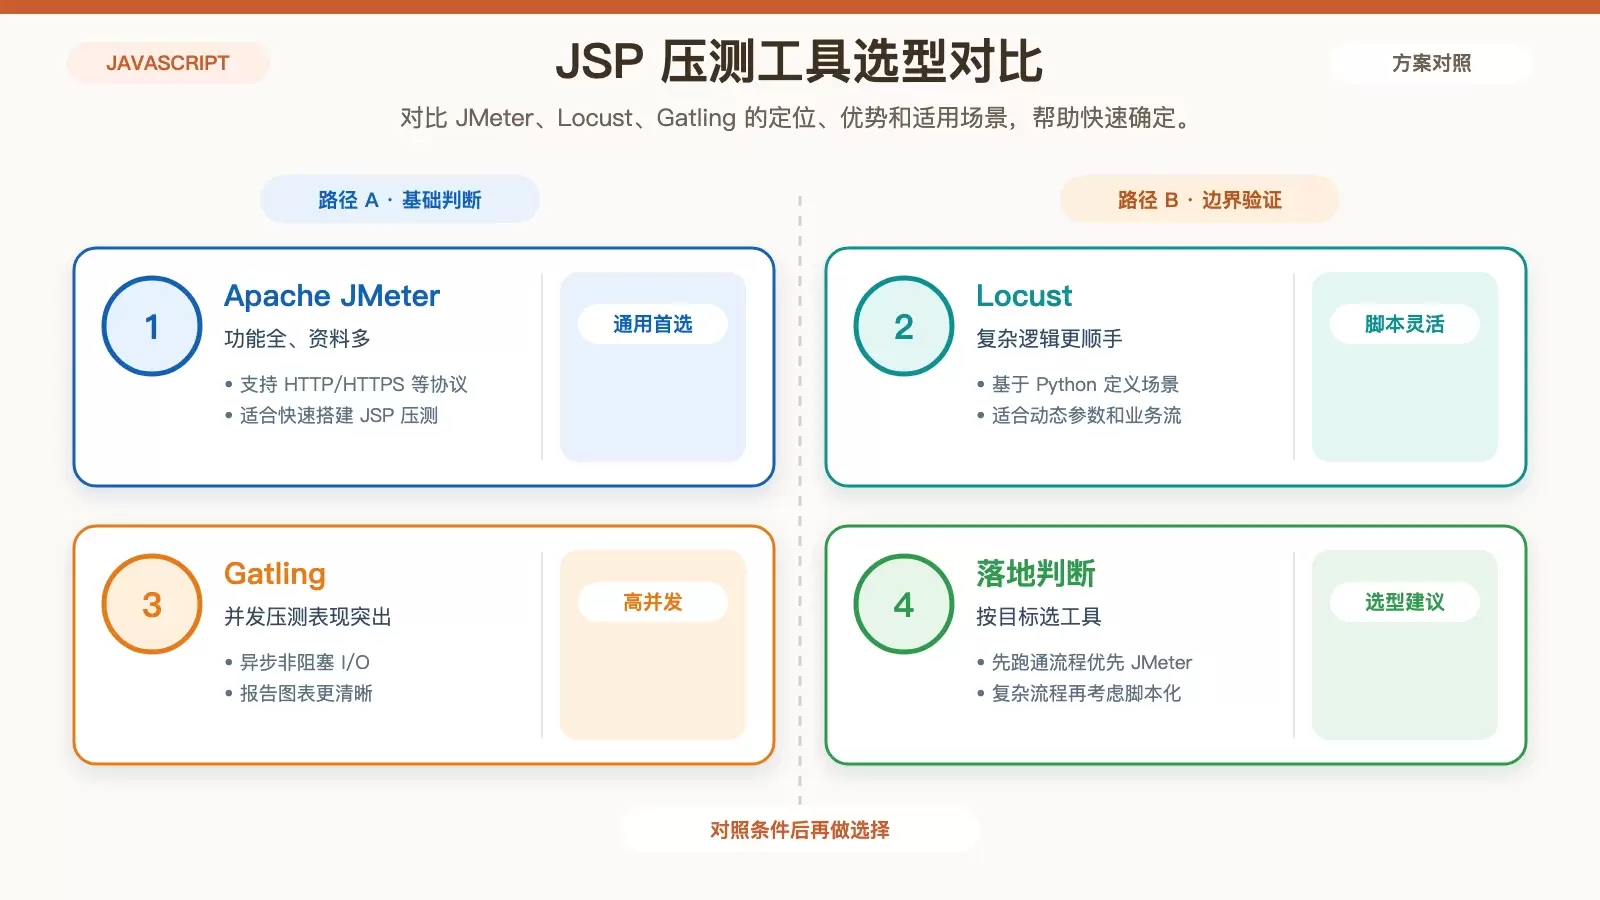
这篇文章围绕 Ubuntu 环境下的 JSP 应用性能测试展开,先梳理 JMeter、Locust、Gatling 的适用场景,再用 Apache JMeter 给出可直接落地的安装、建压与结果分析流程,最后补上 JSP、Tomcat、数据库和基础设施层的优化方向,方便你把测试结果转成实际改进动作。
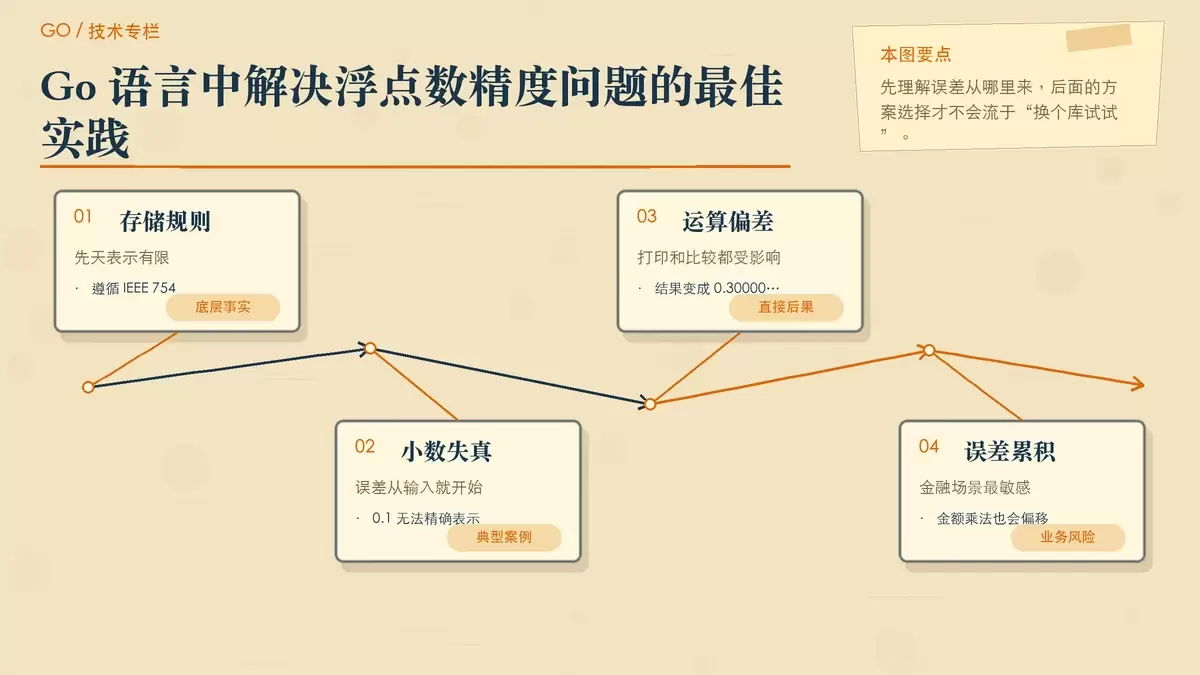
Go 里的浮点数精度问题并不是语言缺陷,而是 IEEE 754 二进制表示的天然结果。本文从 0.1 + 0.2 为什么失真讲起,再结合金额计算、精确比较和数据库设计,梳理整数、decimal、math/big 与误差比较四种常见方案的适用边界。
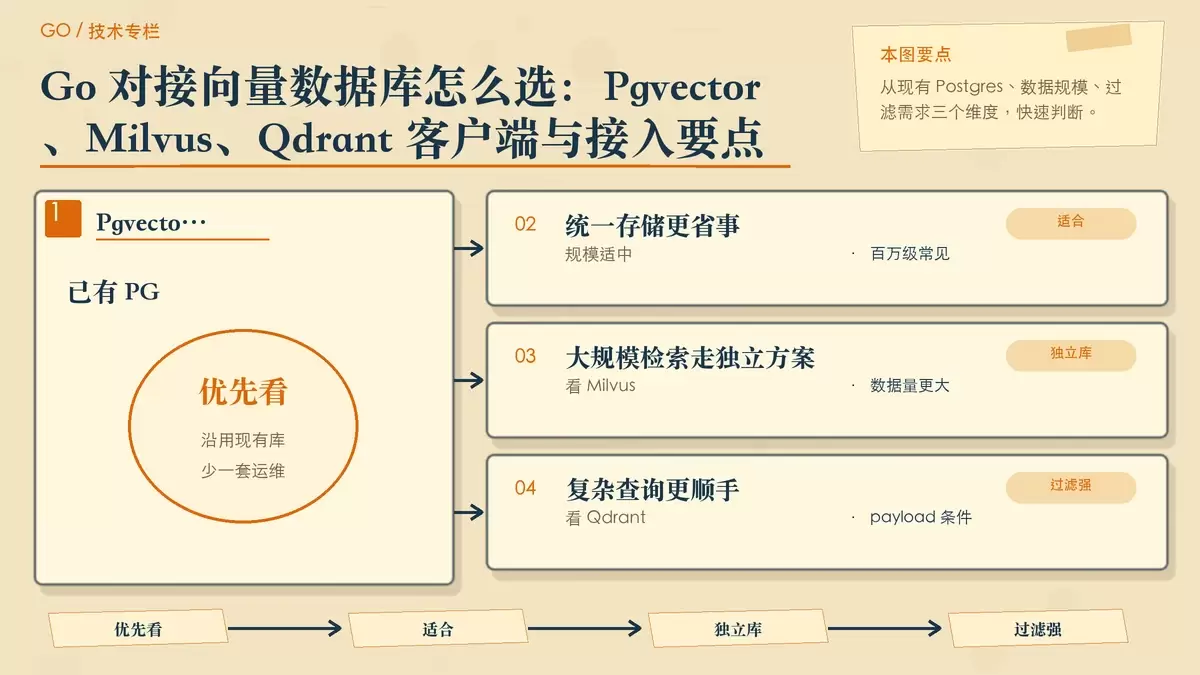
在 Go 项目里接入向量检索,常见路线通常落在 Pgvector、Milvus 和 Qdrant 三种方案。它们分别对应“沿用 Postgres”“独立扩展大规模向量库”“更重视过滤与多向量能力”三类需求,客户端使用方式和接入成本也差异明显。
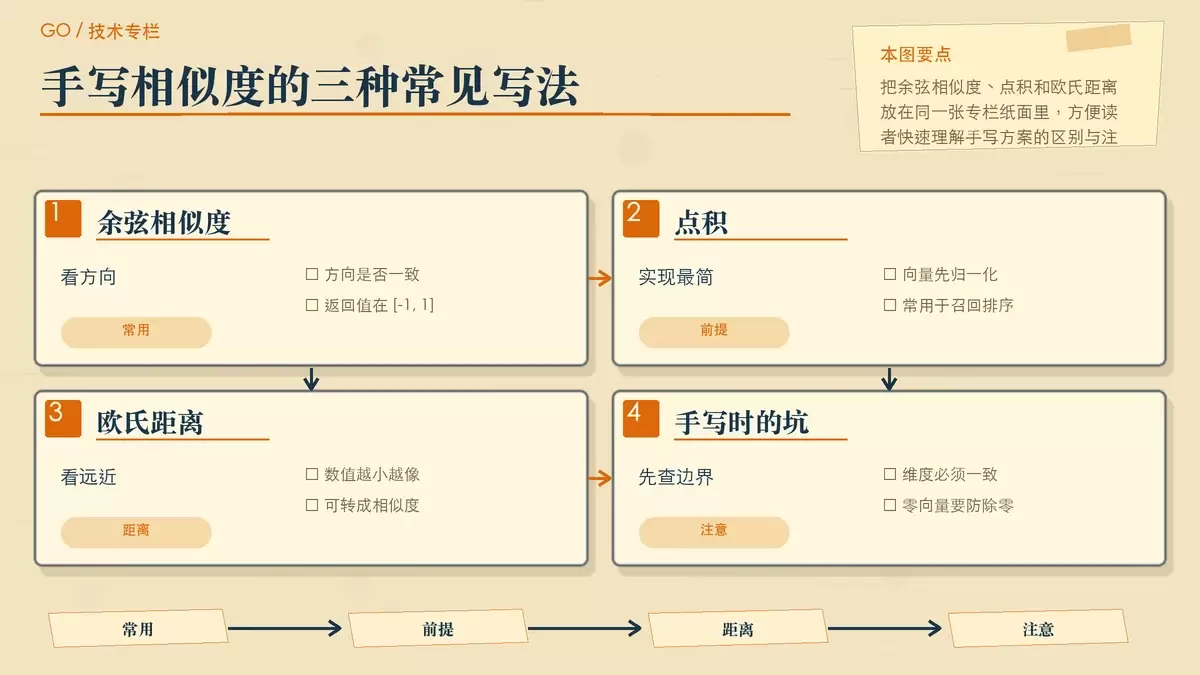
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
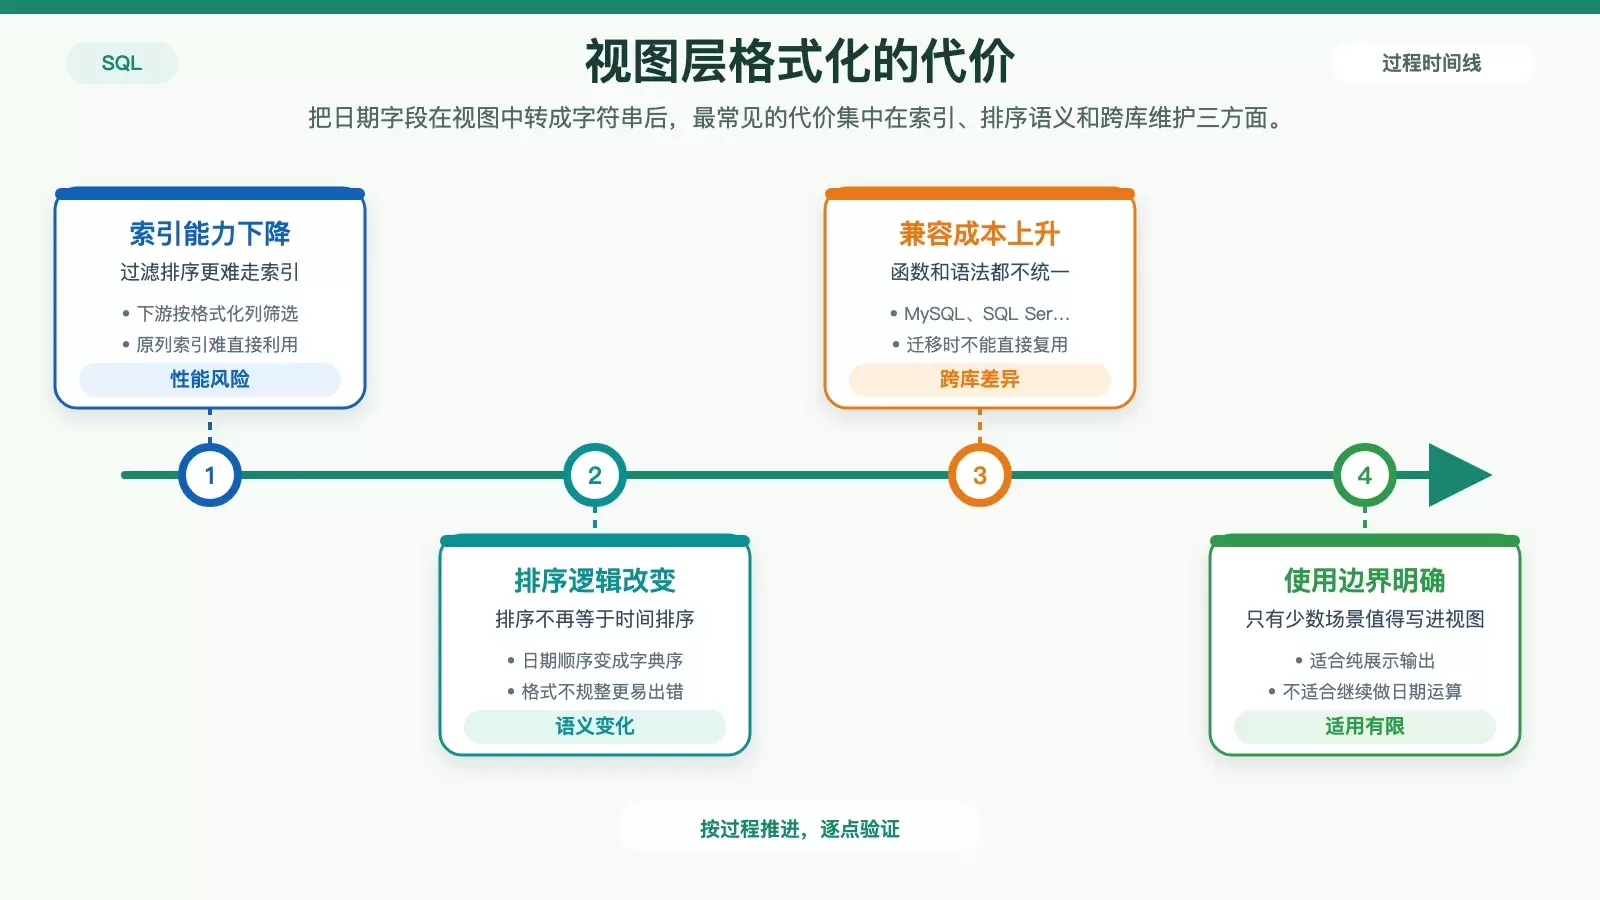
这篇文章以 Gin 与 GORM 组合为例,拆解 Go Web 项目里“函数式写法”到底适合落到哪些层:仓库层、服务层、控制层和中间件都能受益,但数据库连接、配置管理与测试替身问题也会暴露出边界。读完可以快速判断,函数式思想在 Go Web 架构中该用到什么程度。