


存储过程里的死循环很少一开始就暴露出来,更多时候是在高并发、异常数据或锁等待下才突然出现。要避免这类问题,关键不只是“让循环能停”,而是同时把退出语义、计数器上限和运行时排查方法写成固定套路;看完本文,你可以据此判断自己的 MySQL 或 PostgreSQL 过程代码还缺哪一道保险。
MySQL 里退出 WHILE,必须用 LEAVE 加显式标签
在 MySQL 存储过程中,LEAVE 不是可有可无的写法,而是退出循环时需要明确使用的合法方式。把别的语言里的 EXIT 习惯直接搬过来,会立即报错:
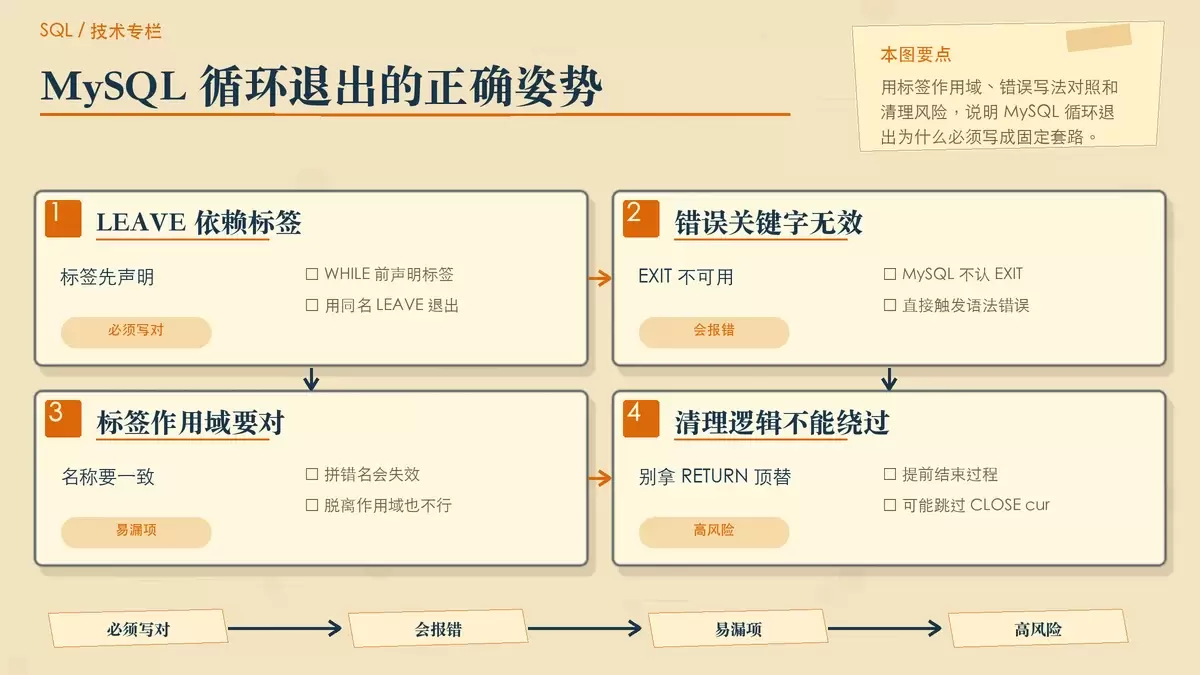
EXIT statement not within loop or begin end block with label原因很直接:MySQL 不认这种写法,循环退出必须依赖标签作用域。
更稳妥的写法,是在 WHILE 前先声明标签,再在循环内部用同名 LEAVE 退出:
my_loop: WHILE condition DO
    IF some_condition THEN
        LEAVE my_loop;
    END IF;
END WHILE;
这里有几个容易踩中的点:
- 标签必须显式写在
WHILE前,例如my_loop: WHILE condition DO,退出时对应写LEAVE my_loop;。 - 如果漏写标签,或者把名字拼错成诸如
LEAVE my_loopx;,循环控制就会失效。 - 还有一种常见误用,是把
LEAVE放在IF结构的尾部,但实际已经脱离循环标签的作用域,这种情况下也可能表现为没有按预期退出。
另外,不要用 RETURN 代替 LEAVE。两者作用完全不同。RETURN 会直接结束整个存储过程,后面的清理逻辑也会一起被跳过,比如:
CLOSE cur一旦这样写,游标、临时状态或后续收尾代码都可能被绕开,风险不只是“提前结束”,而是把问题留到下一次调用时才爆出来。
业务条件不够,所有 WHILE 都要加计数器硬限
很多过程代码只依赖业务条件退出,比如变量变成某个值、查询结果为空、某个分支成立后离开循环。问题在于,这些条件只要有一个环节没有变化,循环就会一直转下去。
典型情况包括:
SELECT INTO没查到数据,结果控制变量没有被更新;IF分支根本没走到,赋值语句被跳过;- 外部表被锁住,导致你预期会推进的状态实际上停在原地。
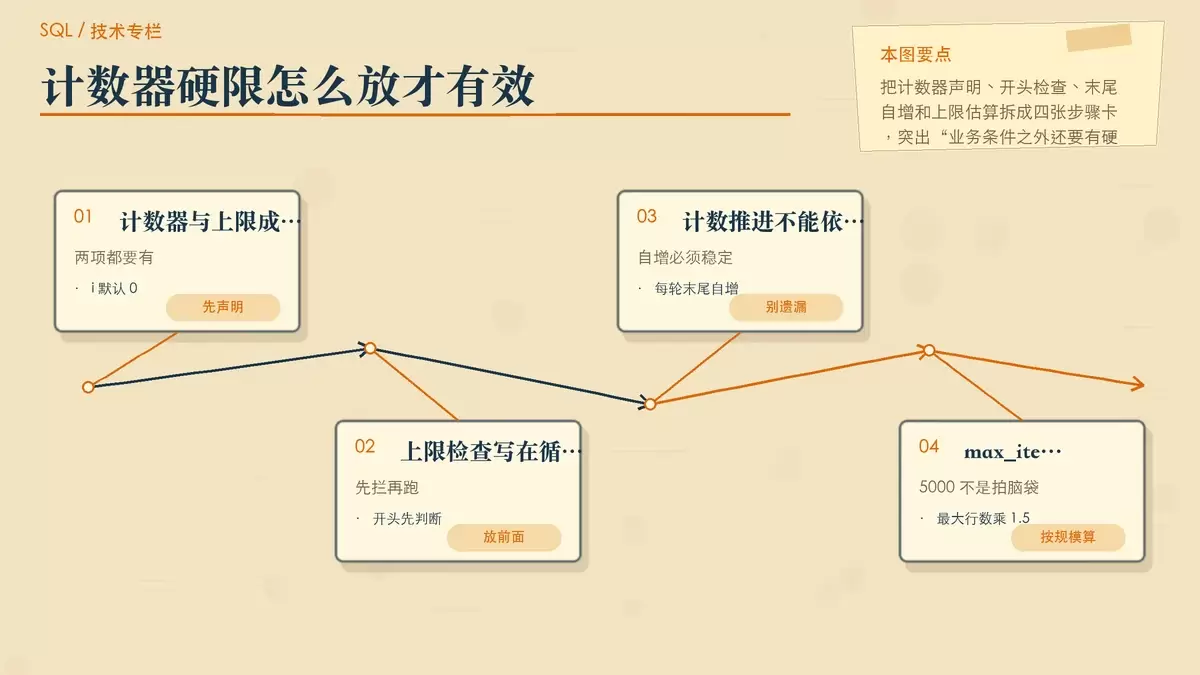
这也是为什么仅靠业务判断并不保险。更稳的办法,是所有 WHILE 都额外配一个强制上限,哪怕业务逻辑失效,也能在有限次数内停下来。
基础写法可以固定成这样:
DECLARE i INT DEFAULT 0;
DECLARE max_iter INT DEFAULT 5000;
循环开始时先检查上限:
IF i >= max_iter THEN
    LEAVE my_loop;
END IF;
每轮循环结束前再无条件自增:
SET i = i + 1;这里最重要的不是语法,而是位置。SET i = i + 1; 不要塞进 IF 里,否则某个分支一旦没执行,自增也会一起被跳过,所谓“硬限”就失去意义。
max_iter 也不能随手拍一个数字。更可执行的经验值是:按单次调用最大处理行数的 1.5 倍估算,再向上取整到千位。比如预估一轮调用最多处理 3200 行,就直接设成 5000。这样既能给正常波动留出余量,又不会把异常循环放任太久。
如果某次调用最终是跑满 max_iter 才停,那它并不算“安全结束”,而只是被硬性拦住了。这通常说明业务逻辑本身存在缺口,还需要继续追查为什么判断变量没有按预期推进。
PostgreSQL 中,statement_timeout 挡不住纯计算死循环
不少人会把 PostgreSQL 的 statement_timeout 当作最后一道保险,但它并不能覆盖所有死循环场景。尤其是纯 PL/pgSQL 的计算型循环,例如:
WHILE true LOOP
    ...
END LOOP
这类代码如果没有真正执行到 SELECT、INSERT 之类的 SQL 语句阶段,statement_timeout 就不会起作用。因为它针对的是 SQL 执行时间,而不是每一种过程语言内部的控制流消耗。
所以在 PostgreSQL 里,面对这类问题要有更现实的判断:
statement_timeout不能替你发现“条件恒真”的循环。- 它也拦不住“判断变量根本没被修改”的逻辑错误。
真正可靠的干预手段并不多。常见的几个点是:
pg_terminate_backend(pid)是最可靠的中断方式,但前提是后端进程没有卡死在某些没有正确处理中断的 C 函数里,例如缺少CHECK_FOR_INTERRUPTS()的场景。- 递归 CTE 要显式加
CYCLE子句,或者在 PostgreSQL 15+ 中利用MAX_RECURSION_DEPTH做额外保护。 - 显式游标遍历时,必须写上
EXIT WHEN NOT FOUND,否则游标耗尽后流程依旧可能继续空转。
换句话说,PostgreSQL 的超时机制能处理一部分“跑太久”的语句,却不能替你修复“根本停不下来”的过程逻辑。只要循环条件恒真,或者循环体没有真正推动状态变化,超时参数就不是解法。
排查挂起过程时,优先看运行状态,不要只等它自己结束
一旦怀疑存储过程挂起,最差的做法就是继续等。MySQL 虽然没有断点调试,但可以通过运行状态和过程内打点,快速缩小卡住的位置。
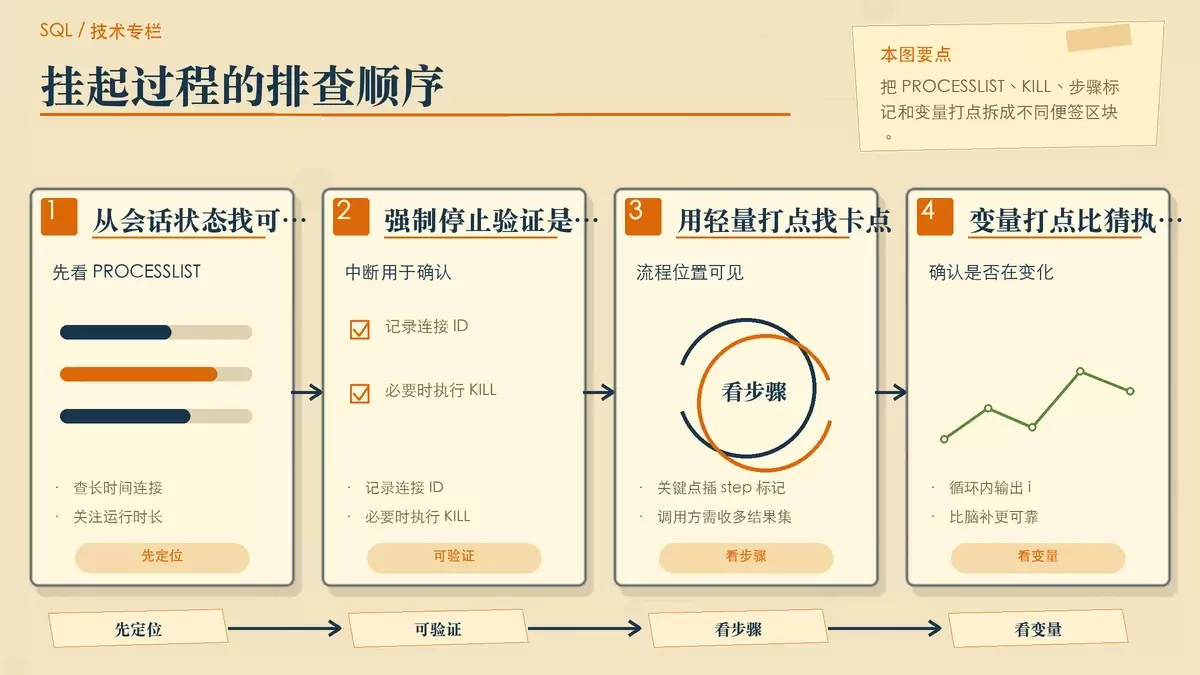
先开一个新会话,直接检查长时间运行的连接:
SELECT * FROM information_schema.PROCESSLIST WHERE COMMAND = 'Sleep' AND TIME > 60;找到可疑连接后,记下 ID,再执行:
KILL [ID];这一步的意义不是简单“强退”,而是验证问题是不是确实发生在循环内部。如果中断后现象稳定复现,就说明你排查方向对了。
接下来可以在过程的关键节点插入轻量标记,例如:
SELECT 'step 1';前提是调用方能够接收多结果集。这样做虽然原始,但对于判断流程究竟卡在进入循环前、分支判断中,还是某个清理步骤前,非常直接。
如果怀疑问题出在变量没有变化,那么循环内部的打点会更有效:
SELECT CONCAT('i=', i);比起靠阅读代码脑补执行路径,这种方式更容易确认计数器是否在增长、判断变量是否真的被更新、某个分支是否从未命中。
最终要解决的,不只是单次死循环,而是把团队的写法固定下来:标签命名统一、计数器位置统一、退出检查节奏统一。因为这类问题最麻烦的地方就在于,平时看不出异常,只有当并发上来、数据边界出现、某个分支恰好失效时,它才会重新出现。









