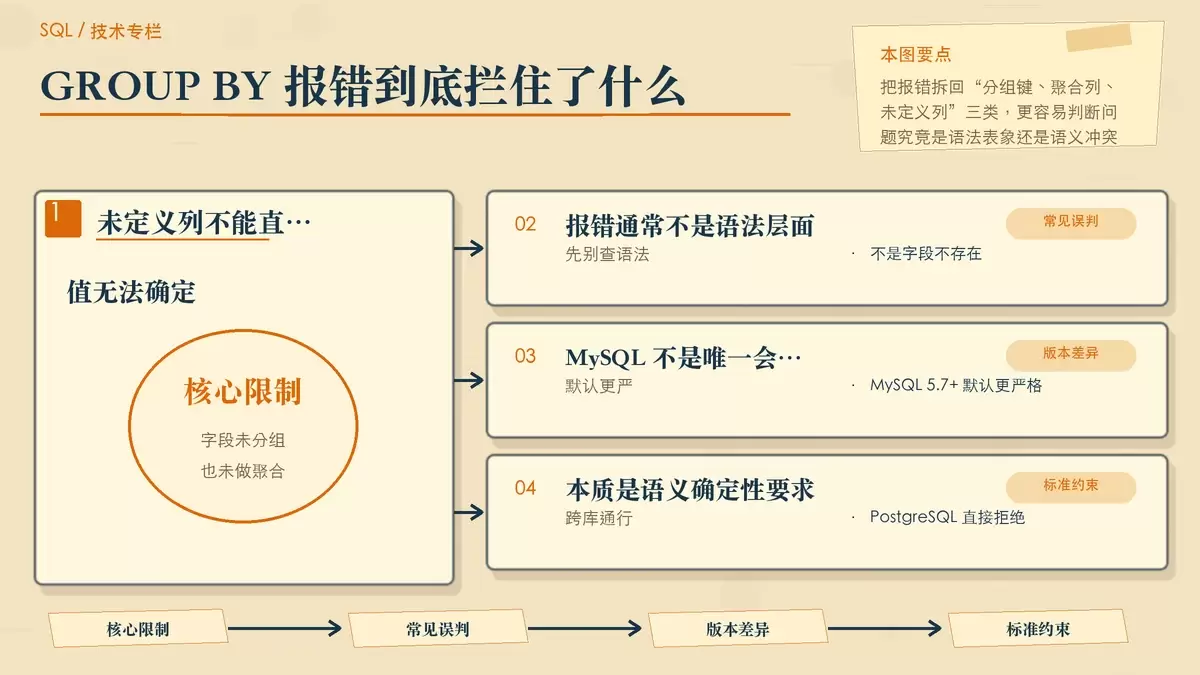
SQL 中 GROUP BY 语法正确却报错,通常卡在哪一步?
`GROUP BY` 语法看起来没问题却报错,通常不是拼写失误,而是数据库在拦截“结果不确定”的查询。本文从报错含义、常见误判、分组键设计、`ORDER BY` 别名可见性,到 `ANY_VALUE()` 的适用边界,梳理出更稳妥的排查与改写方式。
2026-08-25
190

`GROUP BY` 语法看起来没问题却报错,通常不是拼写失误,而是数据库在拦截“结果不确定”的查询。本文从报错含义、常见误判、分组键设计、`ORDER BY` 别名可见性,到 `ANY_VALUE()` 的适用边界,梳理出更稳妥的排查与改写方式。
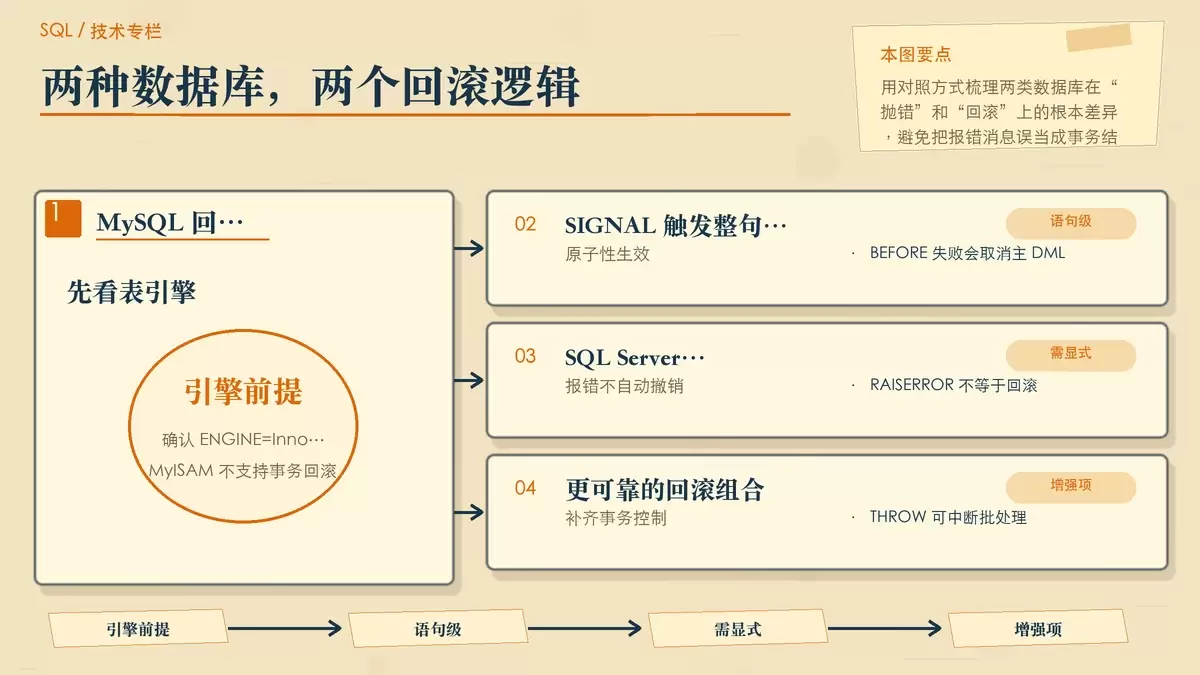
触发器里一旦抛错,为什么有的库会自动回滚,有的却只是报错后继续保留数据?关键不在“触发器会不会回滚”,而在数据库引擎、事务设置和异常传播链路。本文用 MySQL 与 SQL Server 对照拆开讲清常见误判与排查方法。
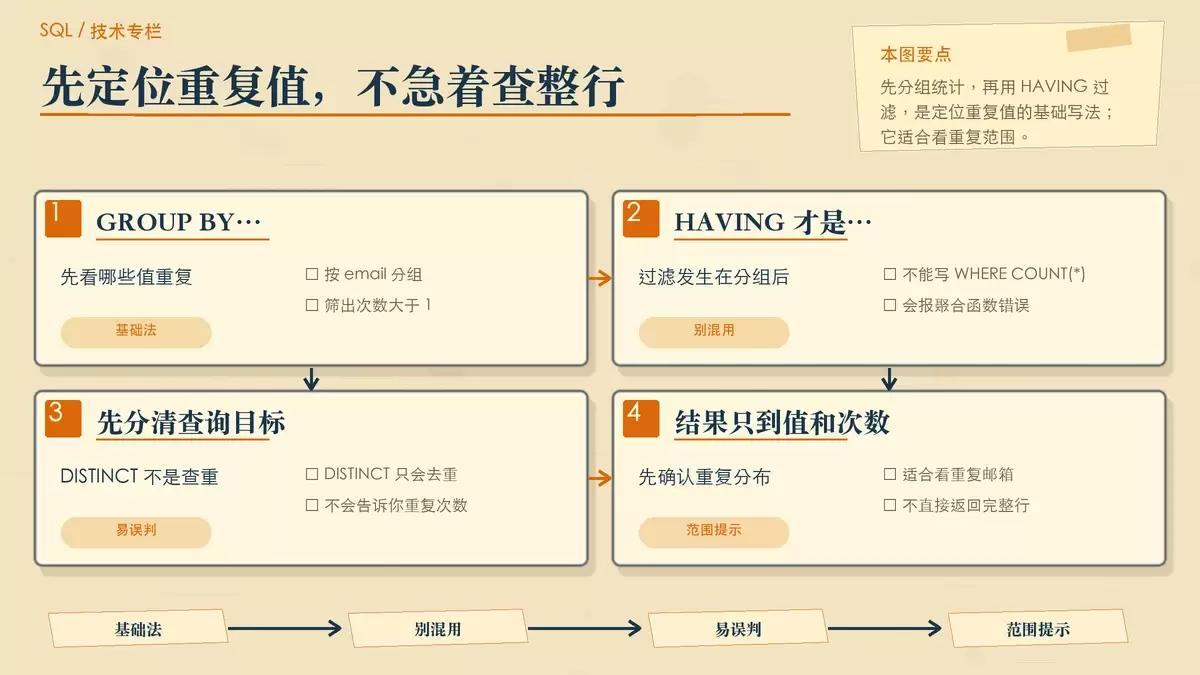
SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
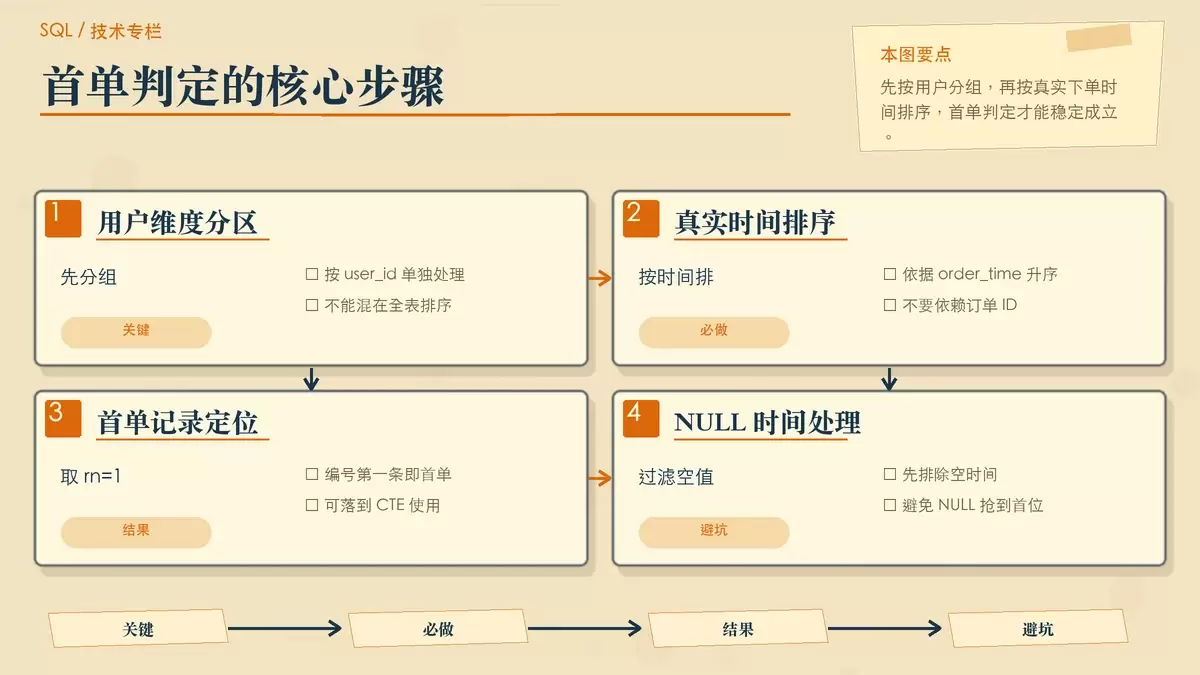
查询“首次购买后的复购记录”,关键不在于先写哪种 SQL,而在于先把“首次购买”的业务口径定清楚。本文用窗口函数为主线,拆解如何用 `ROW_NUMBER()` 锁定每个用户首单、再筛出后续订单,并说明 MySQL、PostgreSQL、SQL Server 的写法差异与常见误区。
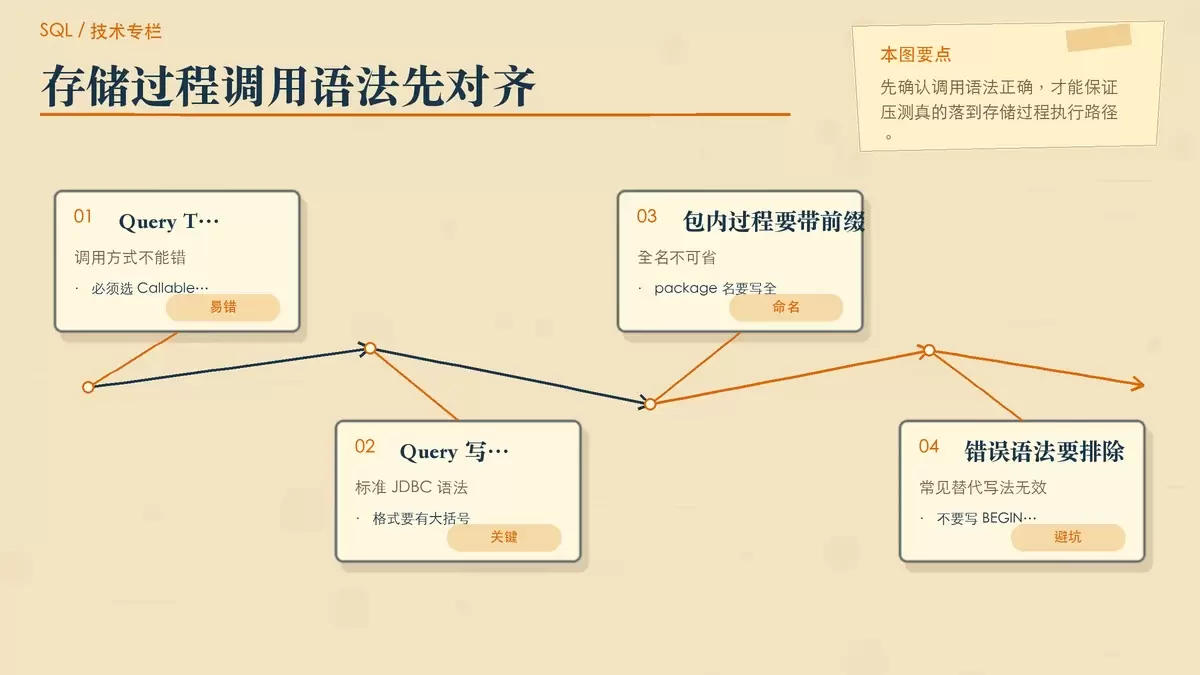
用 JMeter 压测 Oracle 存储过程时,结果失真往往不是数据库性能问题,而是调用方式和参数配置出了偏差。本文按“能否真实打到存储过程”“参数是否绑定正确”“并发是否被环境限制”三条线梳理常见误区,帮助你快速判断压测结果到底能不能信。
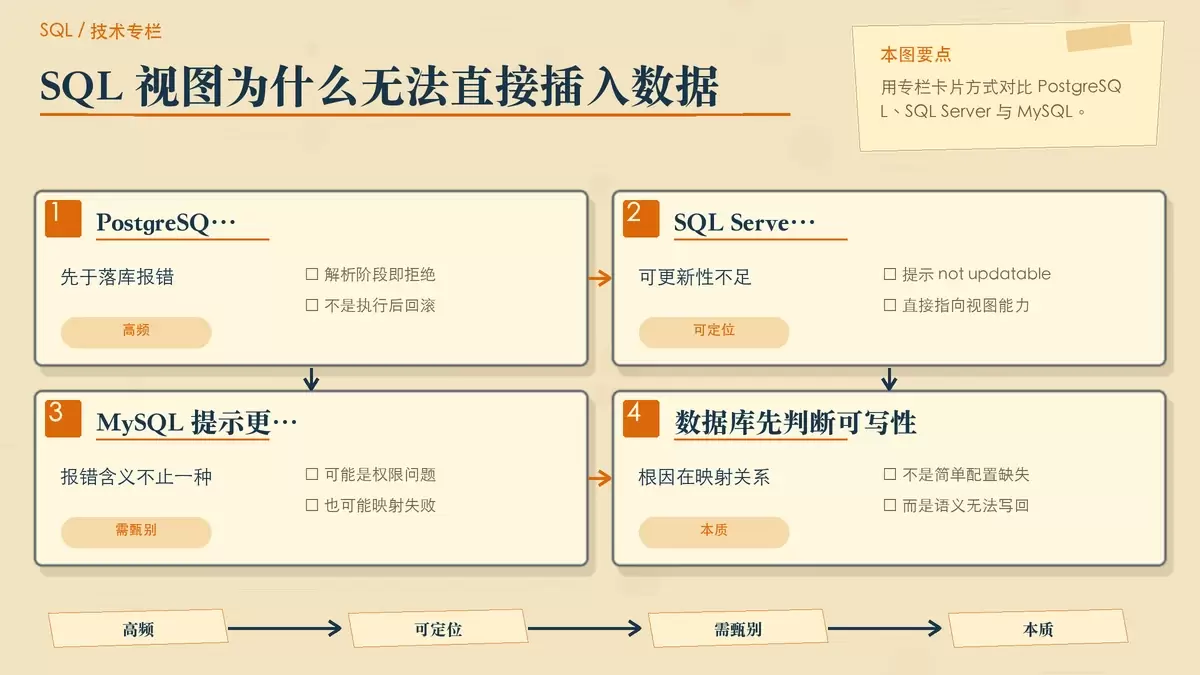
向 SQL 视图执行 INSERT 时,报错通常不是权限配置偶发失误,而是数据库在语义层面认定该视图不可更新。本文梳理常见报错、哪些定义会让视图失去可插入能力,以及单表视图仍失败的几个细节,最后说明 INSTEAD OF 触发器能做什么、又不能替代什么。
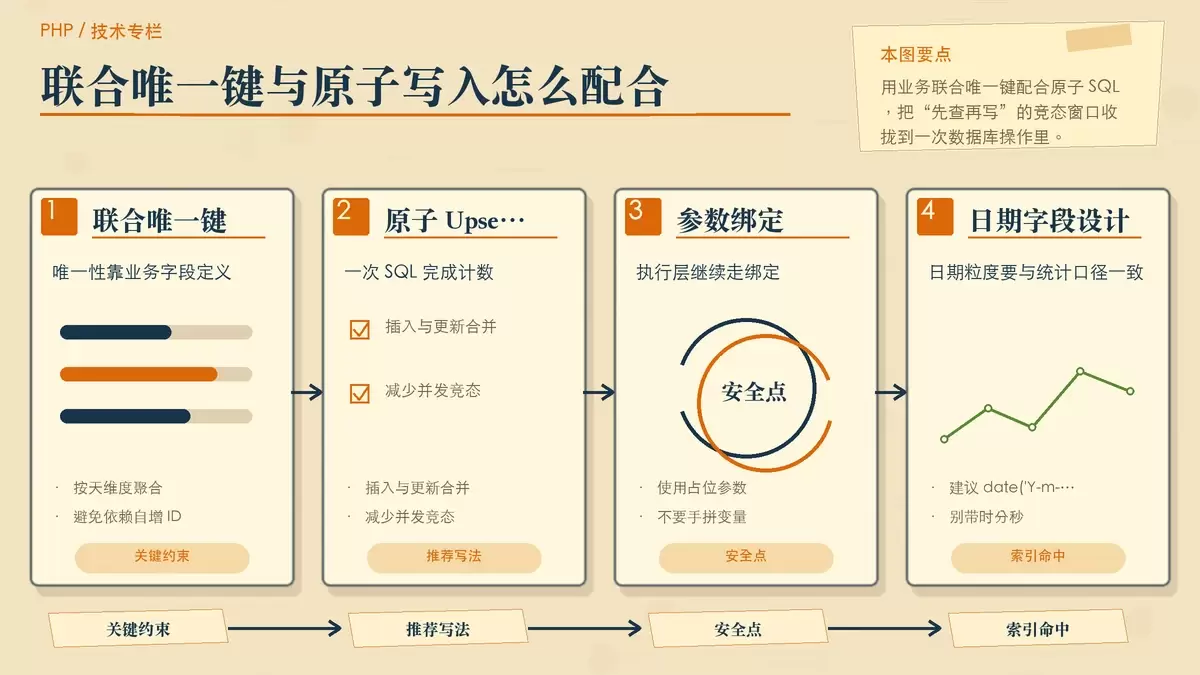
ThinkPHP 做请求统计时,最常见的问题不是语法,而是并发下的幂等和计数准确性。本文围绕唯一键冲突、`ON DUPLICATE KEY UPDATE` 的正确写法,以及 Redis 预聚合是否值得引入,梳理一套更适合线上场景的处理思路。
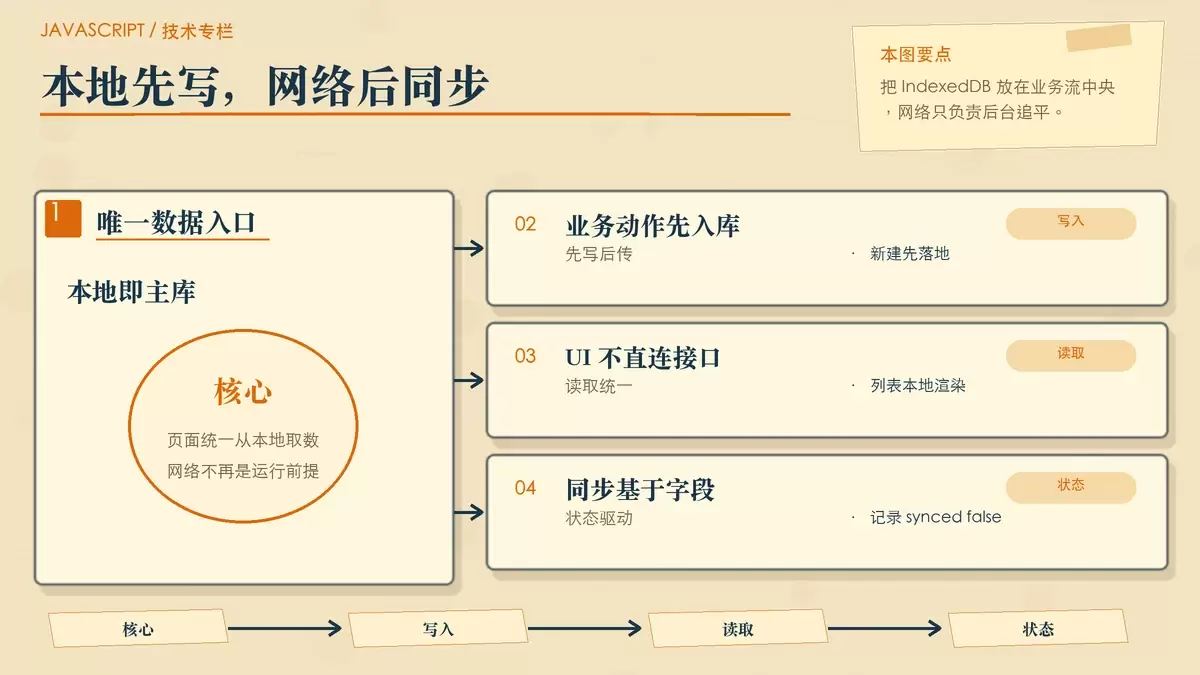
在离线优先架构里,IndexedDB 不只是缓存层,而是前端真正的本地主数据库。文章从数据入口、查询建模、同步闭环和降级策略四个方面,梳理它为什么能承担核心存储角色,以及落地时该怎么设计。
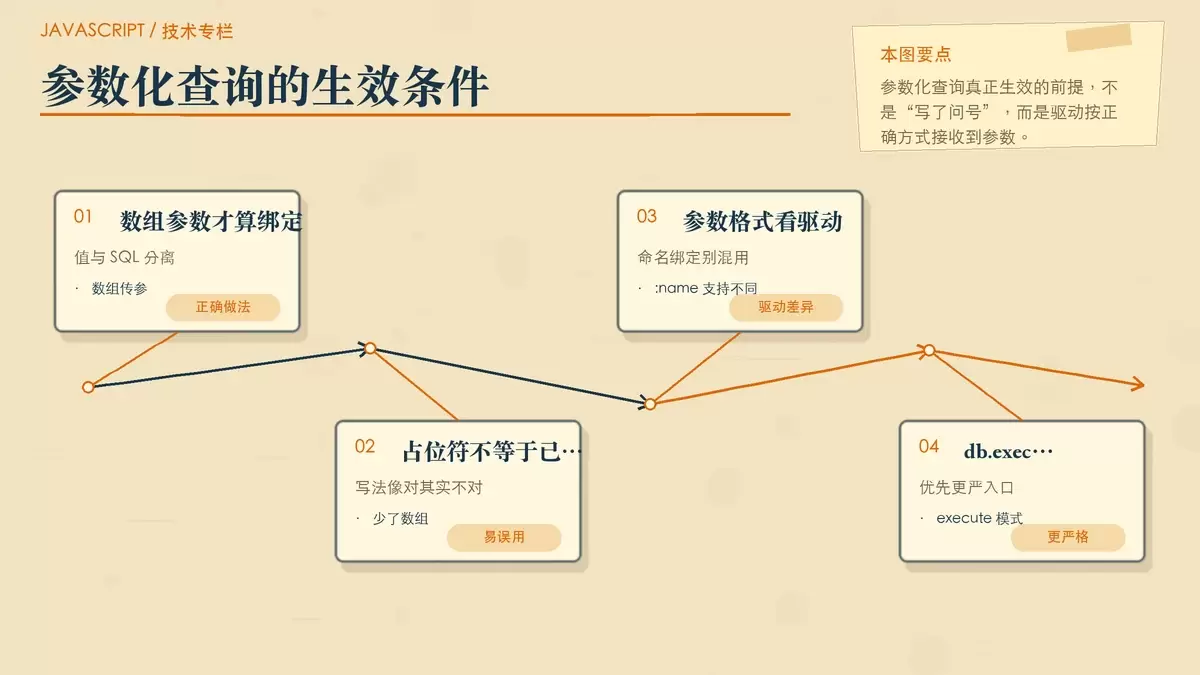
Node.js 22 并不会自带 SQL 注入防护,真正决定安全性的仍是数据库驱动、ORM 和代码写法。本文围绕 mysql2、pg、Sequelize 与 Joi 这几类常见组合,拆开说明哪些写法真正触发参数化,哪些地方看似校验完善却仍可能被拼接注入。
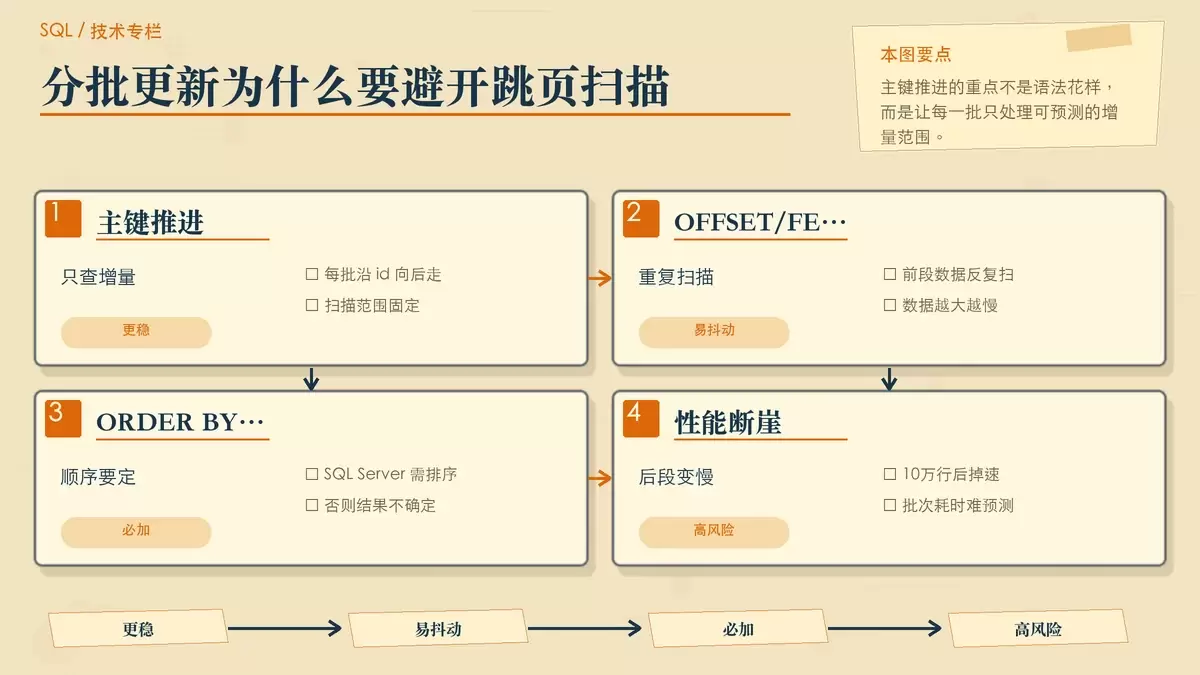
批量更新本身不可怕,真正拖垮业务的往往是事务过大、条件不走索引,以及分页策略选错。本文按“分批推进、索引命中、事务收口”三条主线,整理出更稳的存储过程写法,并点出 SQL Server、MySQL、PostgreSQL 各自容易踩的坑。
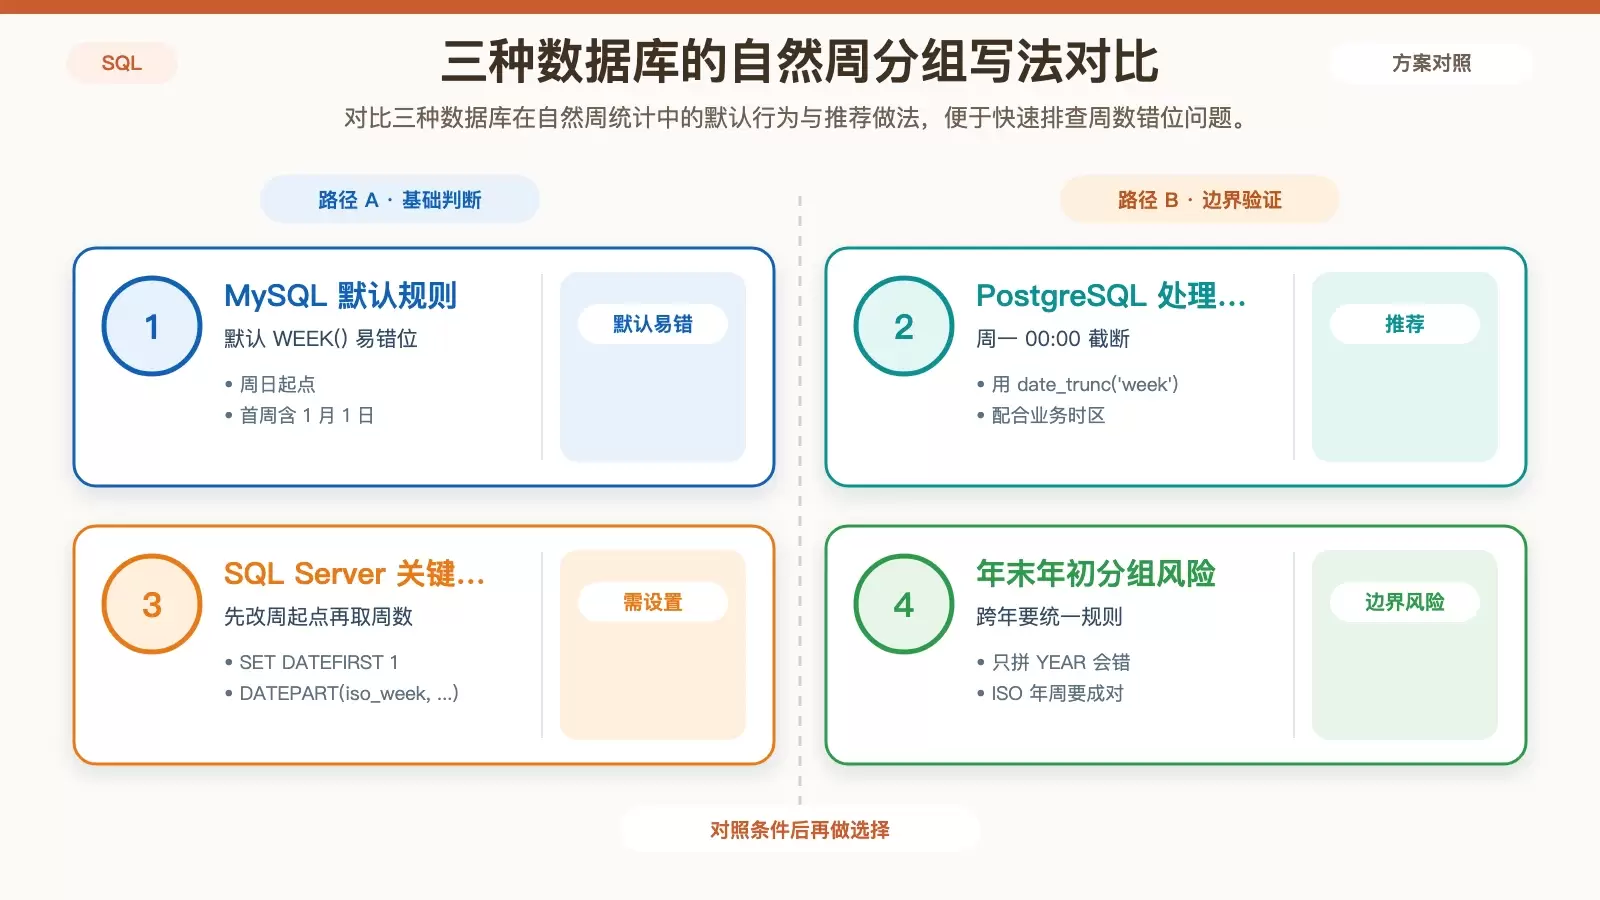
按自然周统计订单数量时,很多 SQL 写法会在周起点、首周定义和跨年边界上出错,导致出现“第0周”或周数错位。本文按 MySQL、PostgreSQL、SQL Server 分别说明正确分组方式,并给出跨年场景下更稳妥的 ISO 周处理思路。
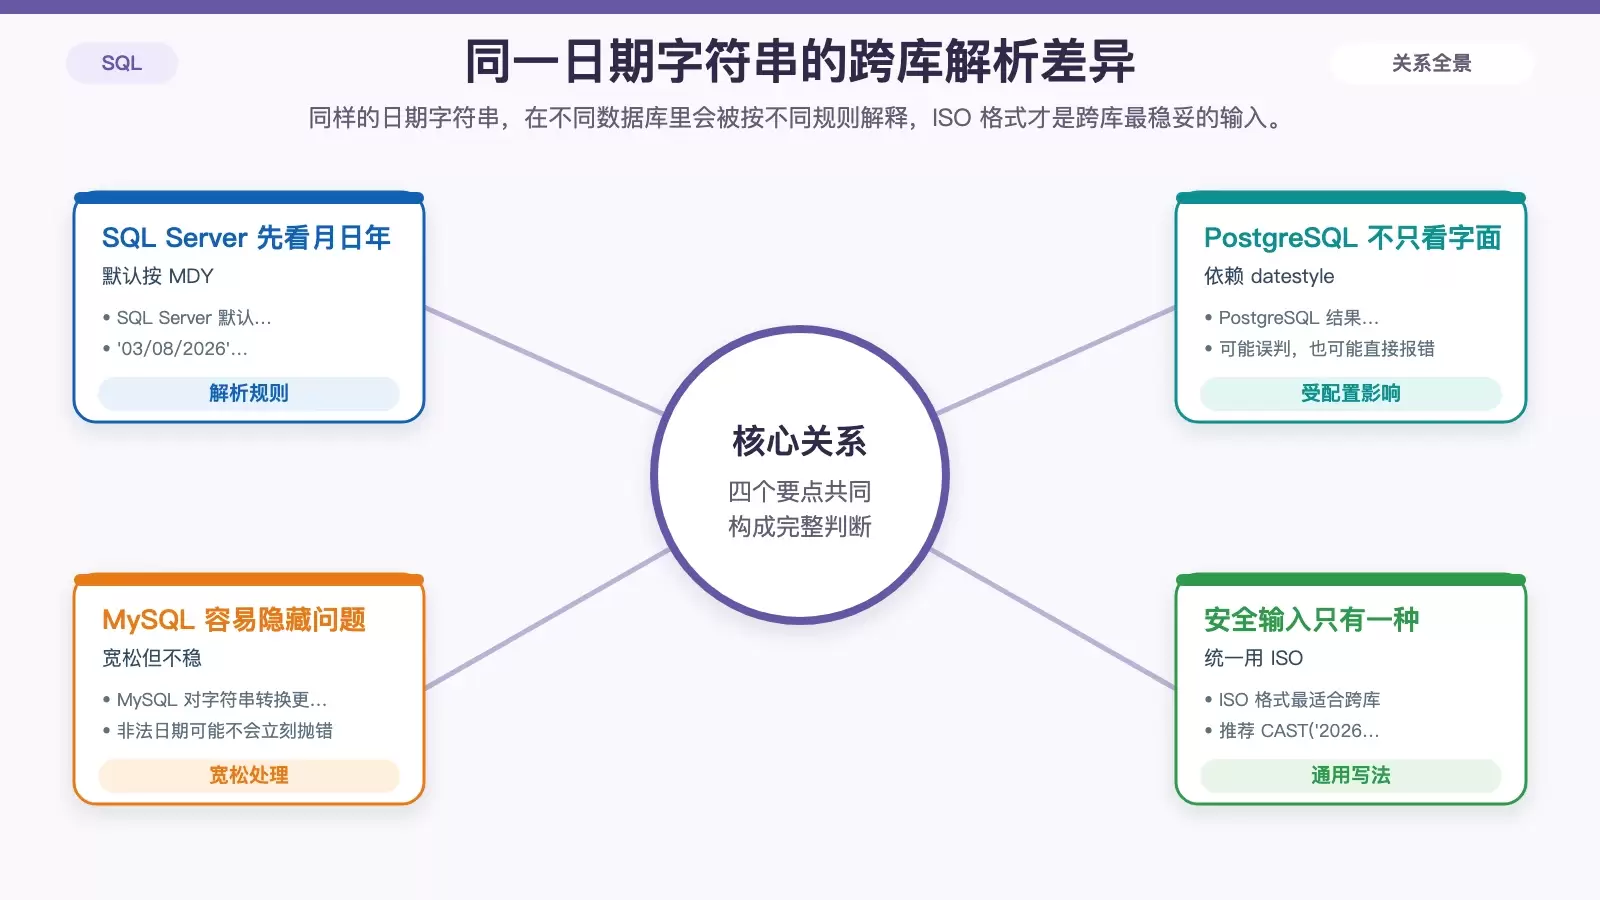
SQL 里把字符串直接 `CAST` 成日期,看起来简单,实际最容易踩到数据库默认解析规则、非法日期静默失败和索引失效这三类坑。本文按常见查询场景拆开说明 SQL Server、PostgreSQL、MySQL 的差异,并给出更稳妥的写法。