Python扩展库numpy入门:数组创建、运算与广播机制详解
本文详细介绍Python科学计算库numpy的核心概念。内容涵盖ndarray与list的区别、多种数组创建方法(如empty、arange、zeros、ones、diag),演示数组间的加减乘除运算规则,并深入解析广播机制在多维数组计算中的应用,帮助读者掌握numpy基础操作。
2026-10-12
8

本文详细介绍Python科学计算库numpy的核心概念。内容涵盖ndarray与list的区别、多种数组创建方法(如empty、arange、zeros、ones、diag),演示数组间的加减乘除运算规则,并深入解析广播机制在多维数组计算中的应用,帮助读者掌握numpy基础操作。
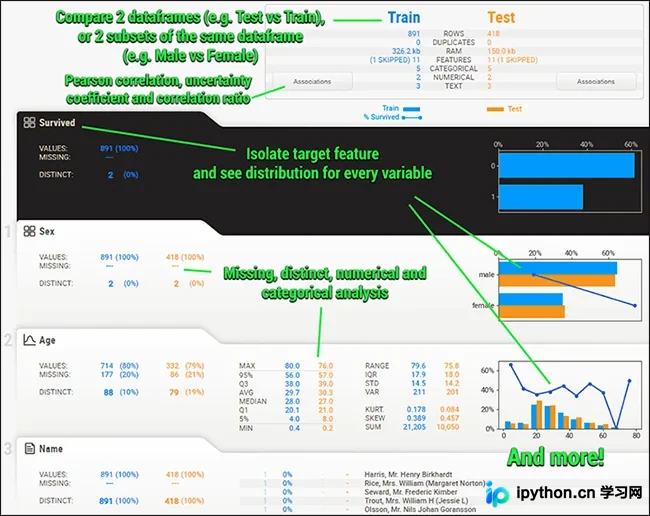
Sweetviz 是 Python 中用于快速生成高精度可视化报告的开源库。通过简单的三行代码,即可对 Pandas DataFrame 进行自动检测、分析与对比,生成包含众数、极值及相关性分析的 HTML 报告。本文详解 analyze、compare 及 compare_intra 函数的用法,并介绍 show_html 与 show_notebook 的参数配置,帮助开发者高效完成探索性数据分析。
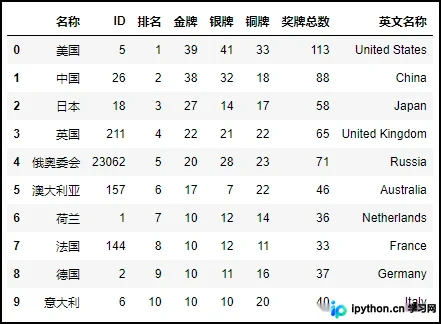
本文详解如何利用Python库Pyecharts制作可视化大屏。内容涵盖使用requests和pandas获取并清洗2020东京奥运会数据,通过Map、Bar、Pie绘制各类图表,并利用Page组件结合chart_config.json实现拖拽式自定义布局,最终生成静态HTML大屏文件。
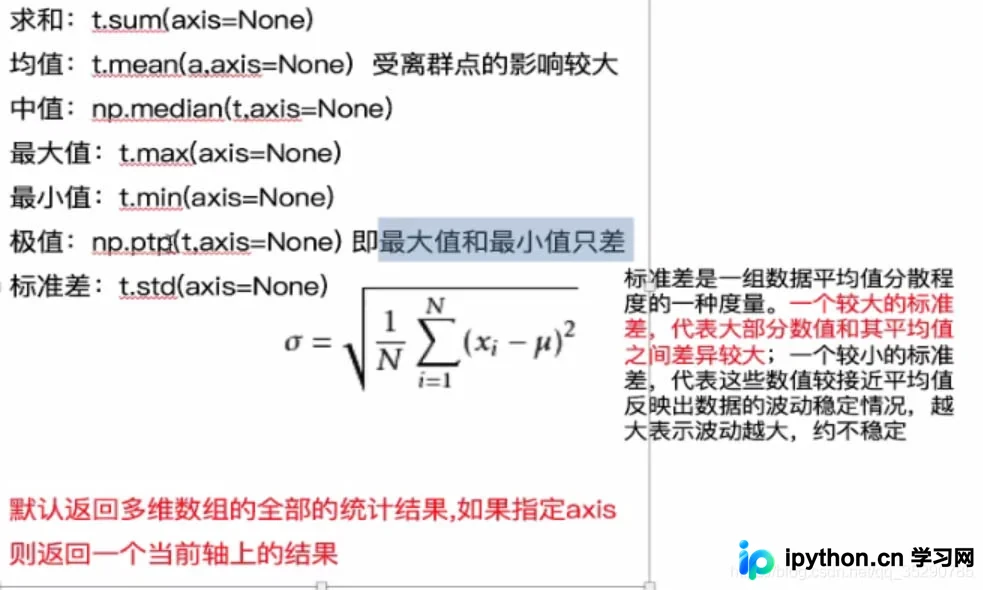
在数据分析与科学计算中,处理包含缺失值(NaN)的数值数组时,直接调用最大值或均值函数极易返回意外结果。本文深度对比np.nanmax与数组.max()的底层差异,解析自动过滤NaN的计算逻辑,提供多场景执行效率参考,并系统梳理常见统计函数的正确调用方式,帮助开发者规避数据处理陷阱。
在Python数据分析中,pandas库提供了apply()、map()和applymap()三个核心函数,分别用于DataFrame的行列级操作、Series的逐元素处理以及DataFrame的逐元素清洗。本文通过实际代码示例与运行结果对比,明确三者的作用范围、参数配置及典型应用场景,帮助开发者快速掌握批量数据处理技巧。
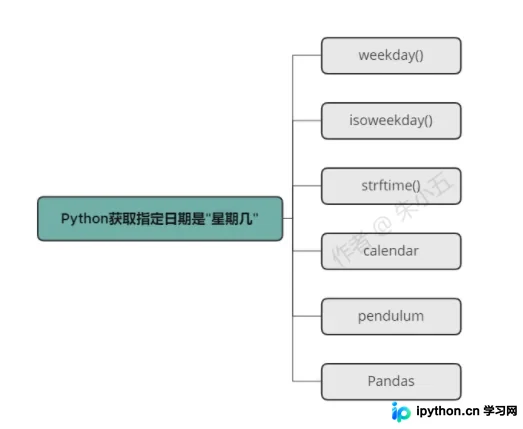
本文详细演示了在Python中获取指定日期对应星期几的6种常用方法,涵盖内置的datetime与calendar模块、第三方库pendulum以及数据分析工具pandas。通过返回数值索引、中英文字符串及批量列计算,帮助开发者快速解决日期分组汇总与周期分析中的格式化问题。
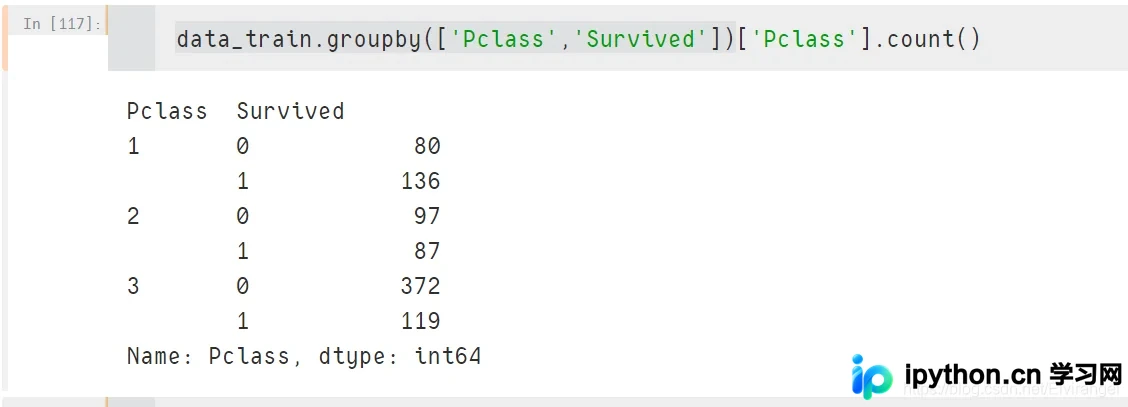
Pandas中count()与value_counts()常用于数据统计,但前者返回非空值总数,后者返回各唯一值的出现频次并默认降序排列。本文详解两者的参数配置、代码示例及核心区别,帮助开发者快速匹配数据清洗与分析场景。
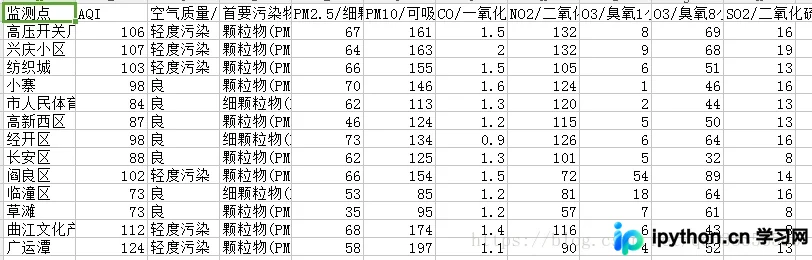
在无法提前知晓CSV文件结构或存取规则的情况下,按需提取特定行或列的数据是常见的数据处理需求。本文演示了两种Python实现方式:通过内置文件操作逐行分割获取原始行与首列内容,以及借助pandas库结合索引位置与列名精准定位数值。掌握这两种方法可快速应对各类CSV数据的结构化提取场景。
本文详解pandas库中用于时间序列解析的核心函数pd.to_datetime()。通过具体案例展示如何灵活处理字符串、字典及混合类型数据,深入解析format格式化参数、errors容错机制、unit单位转换及origin基准点设置,帮助开发者高效完成各类复杂时间数据的标准化转换。
在处理结构化数据时,常需将pandas的datetime64格式或Timestamp对象与Unix时间戳互换。本文演示如何通过pd.to_datetime与整型转换完成单条及整列数据的秒级互转,包含UTC时区处理、纳秒剥离及年月日时分秒的独立提取,附带标准库辅助方案。
Pandas 提供的 df.query() 方法是一种基于字符串表达式的优雅数据筛选工具。相比传统布尔索引,它能自动解析列名、完整支持数学与逻辑运算符,并可借助 @ 符号灵活调用外部变量。本文详细演示了该方法的配置流程、多条件组合、跨列计算技巧及使用边界。
在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。