

Pandas DataFrame 与 Series 排序核心操作指南
本文详细讲解 Pandas 中 DataFrame 与 Series 的数据排序方法,涵盖基于元素值的 sort_values() 与基于索引标签的 sort_index()。通过 ascending、na_position、inplace 及 axis 等核心参数配置,实现单列/多列升降序排列、缺失值控制及原地更新操作,附带类型冲突排错指南,适用于 Python 数据分析流程中的表结构整理。
2026-10-12
6

本文详细讲解 Pandas 中 DataFrame 与 Series 的数据排序方法,涵盖基于元素值的 sort_values() 与基于索引标签的 sort_index()。通过 ascending、na_position、inplace 及 axis 等核心参数配置,实现单列/多列升降序排列、缺失值控制及原地更新操作,附带类型冲突排错指南,适用于 Python 数据分析流程中的表结构整理。
在使用Pandas处理表格数据时,经常需要核对多列内容的异同。本文通过具体示例演示如何在Python中对比DataFrame的两列数据并生成比对结果。介绍自定义函数逐行判定与直接利用运算符进行向量化计算两种高效方案,附带完整代码与输出结果对照,帮助开发者快速完成数据校验与特征工程中的列匹配任务。
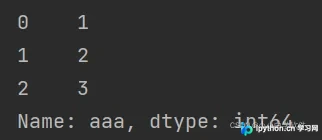
本文详细解析Python中pandas库的pd.Series()函数核心用法。演示如何通过元组、列表、NumPy数组、字典及标量快速构建一维序列,并深度拆解index索引映射、name对象命名与dtype类型强制转换等关键参数配置技巧,帮助开发者高效完成结构化数据的初始化与内存优化。
针对字符串中夹杂的数字序列及其间隔的逗号,本文演示如何利用Python正则表达式精准定位并移除数字间的分隔符。通过梳理匹配规则与设计迭代替换逻辑,提供可直接运行的代码示例与结果验证方法,帮助开发者高效完成特定格式的数据清洗任务。
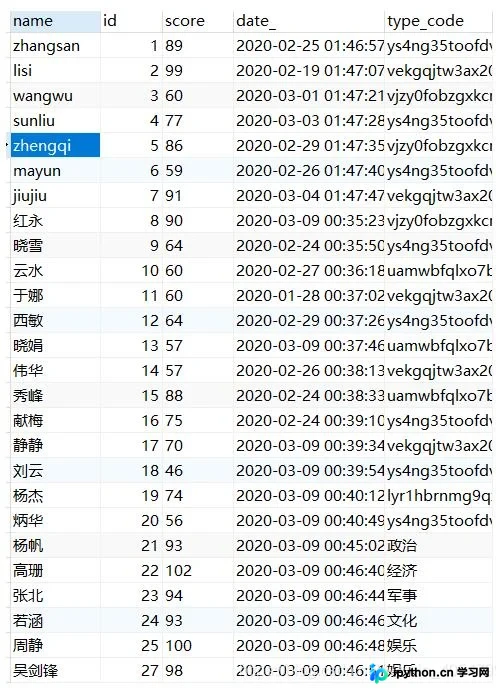
本文详解Python中pymysql库的cur.fetchall与cur.fetchone方法。通过连接MySQL数据库,演示如何提取数据并利用pandas进行分组统计、映射编码、排序及格式转换,最终输出前端所需JSON格式。同时对比fetchone在单行查询中的应用,提供完整的代码示例与结果分析。
本文深入解析 pandas DataFrame 赋值时的 Index 对齐机制,解释为何 Index 不匹配会导致 NaN。通过对比三种 Index 场景,阐明 df[condition] 赋值的潜在风险,并给出使用 loc 和 iloc 进行安全、规范赋值的最佳实践。
在使用pandas进行数据聚类时,单特征与双特征聚类对列类型的影响不同,可能导致后续merge操作报类型错误。本文分析了该现象的原因,并提供了一个基于阈值的数据聚类实现方案,帮助处理按数值大小归类数据集的需求。
本文系统梳理 Python 标准库 re 模块的常用操作,涵盖字符串替换与拆分、精准匹配验证、分组内容提取及迭代遍历等高频场景。通过演示直接使用模块函数与预编译正则对象的差异,帮助开发者掌握高效、安全的文本处理方案。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
本文介绍如何使用Python实现一个基础的职工信息管理系统。系统涵盖数据的添加、显示、查询、修改、删除、保存、排序及工资统计功能。通过列表存储数据,利用文件IO实现持久化,并演示了如何按姓名排序及统计工资分布。
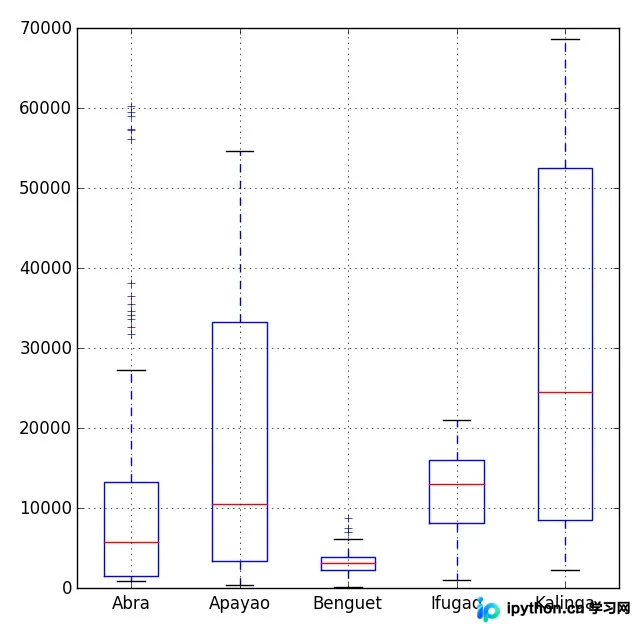
本文详解如何利用Python完成数据分析核心工作流。通过pandas实现CSV数据导入与字段筛选,借助scipy进行单样本t检验等统计推断,并结合matplotlib与seaborn快速生成盒须图、核密度图与回归图。附带现代语法规范与自定义函数编写技巧,助开发者高效掌握数据探索基础操作。
本文详细介绍Python内置random模块的核心功能,涵盖生成指定范围浮点数与整数、随机选取列表元素以及原地打乱序列等操作。通过完整的代码示例与运行结果对照,帮助开发者快速掌握随机数生成的标准写法与注意事项,适用于数据分析初始化、游戏逻辑或日常脚本编写。