

Python数据分析apply(),map(),applymap()用法对比与实操

发布时间:2026-10-12| 3人浏览过
在Python数据分析中,pandas库提供了apply()、map()和applymap()三个核心函数,分别用于DataFrame的行列级操作、Series的逐元素处理以及DataFrame的逐元素清洗。本文通过实际代码示例与运行结果对比,明确三者的作用范围、参数配置及典型应用场景,帮助开发者快速掌握批量数据处理技巧。
Pandas批量处理函数对比
在使用pandas进行数据预处理时,根据数据结构选择正确的函数可大幅提升效率。三者核心差异如下:
| 函数 | 适用对象 | 操作维度 |
|---|---|---|
| apply() | DataFrame | 按行或按列聚合/转换 |
| map() | Series | 逐个元素映射/转换 |
| applymap() | DataFrame | 逐个单元格映射/转换 |
第一步:使用 apply() 对 DataFrame 进行行列计算
apply() 专门用于 DataFrame,支持通过 axis 参数灵活切换运算方向。设置为 1 表示沿行操作(将每一行视为一个Series),设置为 0 表示沿列操作。
import pandas as pd
data = [[110, 120, 110], [130, 130, 130], [130, 120, 130]]
columns = ['语文', '数学', '英语']
df = pd.DataFrame(data=data, columns=columns)
print(df)
print("=============================")
print(df.apply(lambda x: x.sum(), axis=1))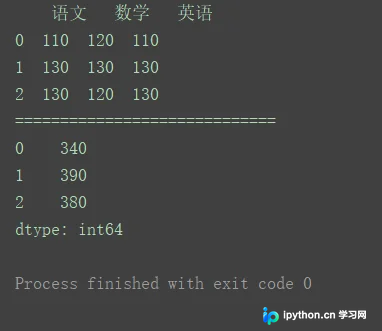
执行后控制台会依次打印原始成绩表与计算后的行总和向量。若需改为总分统计,仅需将 axis=1 调整为 axis=0 即可。
第二步:使用 map() 处理 Series 单个数据
当数据以一维数组形式存在时,应直接使用 map()。该函数会对索引对应的每一个值调用传入的匿名函数,非常适合类型转换或规则过滤。
import pandas as pd
s1 = pd.Series([11, 22, 33, 44, 55])
print(s1)
print("================================")
print(s1.map(lambda x: str(x)))
运行后将把原始整数列表转换为字符串格式返回,保持索引结构不变。
第三步:使用 applymap() 清洗 DataFrame 每个单元格
若需要统一修改整个二维表格内所有单元格的精度或文本格式,applymap() 是最佳选择。它会将自定义逻辑作用于底层所有独立数值。
import pandas as pd
data = [[110, 120, 110], [130, 130, 130], [130, 120, 130]]
columns = ['语文', '数学', '英语']
df = pd.DataFrame(data=data, columns=columns)
print(df)
print("=============================")
print(df.applymap(lambda x: '%.2f'%x))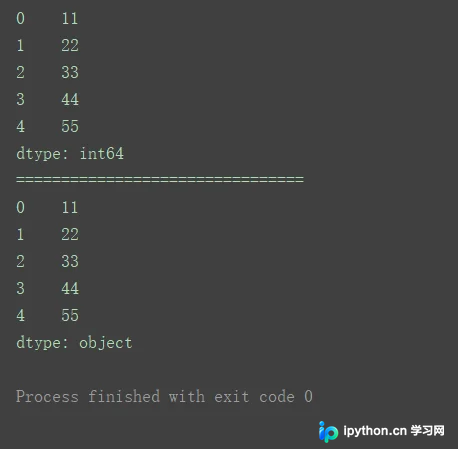
以上代码演示了如何通过字符串格式化占位符统一调整数值显示样式。实际业务中,也可结合 round() 或自定义校验函数完成缺失值标记与异常值拦截。
以上就是 Python数据分析apply(),map(),applymap()用法 的详细内容,更多关于pandas批量处理函数的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









