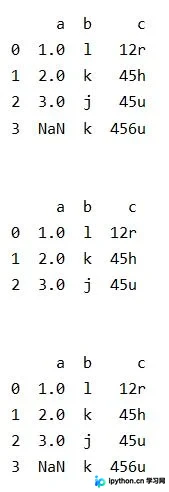
pandas纵向拼接多DataFrame并忽略索引的方法
本文介绍如何使用pandas的concat函数在纵向拼接多个DataFrame时忽略原有索引。通过设置ignore_index=True参数,可生成连续的新索引,避免NaN值。同时涵盖横向拼接的axis=1用法,帮助处理不同列名的数据合并问题。
2026-10-14
7

本文介绍如何使用pandas的concat函数在纵向拼接多个DataFrame时忽略原有索引。通过设置ignore_index=True参数,可生成连续的新索引,避免NaN值。同时涵盖横向拼接的axis=1用法,帮助处理不同列名的数据合并问题。
本文介绍在Pandas中处理混合类型数据及过滤特定值的方法。通过示例展示如何处理read_csv读取时的类型警告,利用str.isdigit()筛选纯数字列,以及使用isin()和逻辑与操作符剔除包含特定数值或多条件组合的异常数据行。
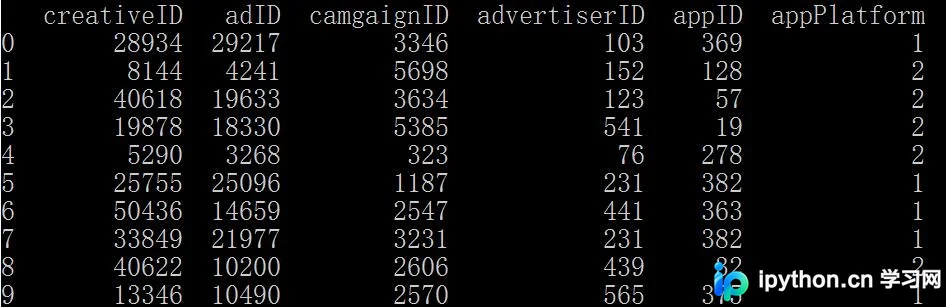
本文介绍使用Python pandas库遍历DataFrame并输出每行索引及对应数据的实现方法。通过iterrows()方法配合list()转换,可清晰展示每行数据的结构。示例包含含NaN、None等缺失值的数据处理,并附带完整代码与运行结果分析,适合初学者参考。
本文详解pandas中DataFrame.insert()方法,介绍如何通过loc参数在指定位置插入新列,以及利用allow_duplicates=True处理重复列名的技巧。同时对比insert与drop、pop在列删除与位置调整上的差异,结合代码示例演示整数、Series及数组值的插入操作。
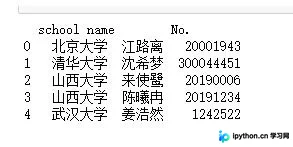
本文介绍在pandas中为DataFrame添加自增列的两种常用方法。第一种通过重置索引并修改列名,第二种利用insert方法在指定位置插入范围数据。此外还补充了新增带有默认值的列以及读写CSV文件的完整示例,帮助开发者快速实现ID生成与数据预处理。
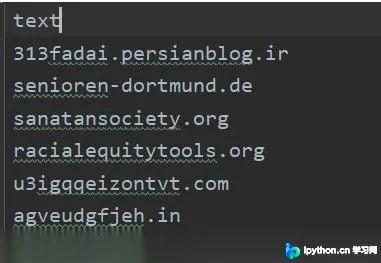
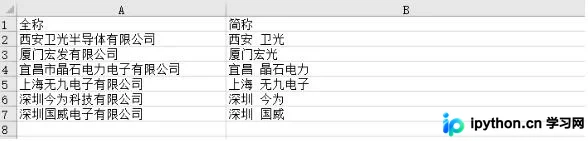
本文介绍如何利用Python的Pandas库处理包含数万条记录的Excel文件,自动根据预设的供应商全称与简称对应关系填充数据。通过构建字典映射并遍历数据列,实现批量填写简称的功能。文章同时探讨了字符串匹配中因括号、空格等细微差异导致的匹配失败问题,为后续优化提供思路。
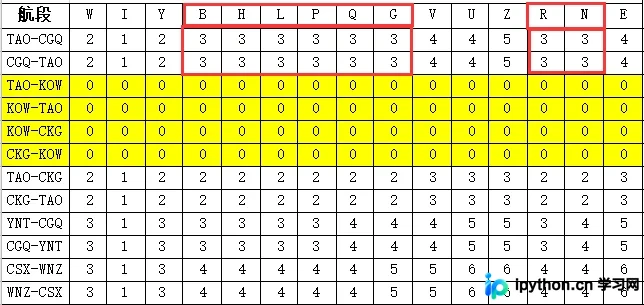
本文介绍如何使用Python的Pandas库自动化处理Excel表格数据。通过读取Excel文件,提取航线、舱位及价格信息,程序遍历每一行数据,找出数值相同的列索引,将对应的舱位字母合并,并提取返点价格。最终生成包含航线、合并舱位及价格的标准化结果列表,适用于供应链部门每周重复性数据清洗任务,替代手工操作。
本文介绍如何在Python中使用Pandas库高效实现DataFrame的行列转置。通过利用numpy内置矩阵转置方法,可显著提升处理速度,适用于数据长度不确定或需优化获取效率的场景。
本文详细介绍pandas中多层索引(MultiIndex)的创建方法,包括通过列表、numpy随机数及from_product函数构建Series和DataFrame。重点讲解利用[]和loc进行层级取值及切片操作,并演示sort_index按层级排序的具体用法,帮助开发者高效处理高维数据。
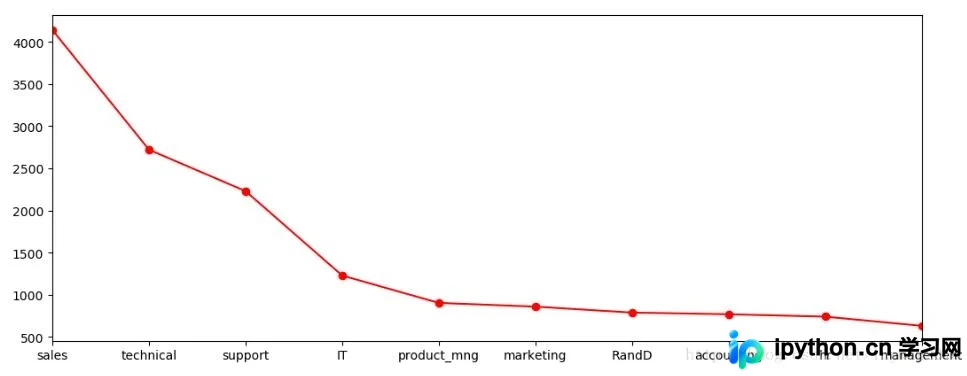
本文详解Python中matplotlib与pandas库的绘图方法。涵盖折线图、柱状图、饼图、箱型图及子图布局等常见统计图表的生成代码。重点解析帕累托分析、异常值注释及多条件筛选技巧,提供可直接运行的示例代码,帮助开发者快速掌握数据可视化核心技能。
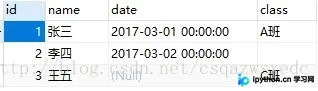
本文详解Python向MySQL插入NULL值的方法,区分%s占位符加不加引号的差异。深入对比数据库中NULL与空字符的区别,以及Python中None、Pandas中NaN与数据库NULL的对应关系,帮助开发者避免数据读取与写入时的类型错误。
本文详细解析Python pandas库中dropna()与notnull()函数在处理DataFrame空值时的行为差异。通过对比全局操作与指定列操作的返回值类型(Series vs DataFrame)及过滤逻辑,帮助开发者准确选择空值处理策略,避免数据丢失或类型错误。