SQL 随机抽取每班指定数量学生:使用 ROW_NUMBER 实现
本文介绍如何利用 SQL 窗口函数 ROW_NUMBER 结合随机排序,从包含班级和姓名的学生表中,精确抽取每个班级的任意 N 名学生。该方法通过生成随机序号并设定阈值,高效完成分层抽样任务,适用于班级点名、活动分组等场景。
2026-10-14
6

本文介绍如何利用 SQL 窗口函数 ROW_NUMBER 结合随机排序,从包含班级和姓名的学生表中,精确抽取每个班级的任意 N 名学生。该方法通过生成随机序号并设定阈值,高效完成分层抽样任务,适用于班级点名、活动分组等场景。
本文介绍利用 Pandas 和 fuzzywuzzy 进行数据模糊查询与替换的完整流程。涵盖从数据导入、清洗、筛选到多条件文本匹配的核心代码示例,重点解析如何通过列表推导式结合 str.contains() 实现高效的多条件模糊筛选,适用于大量文本数据的快速处理与标准化。
本文详细介绍 pandas 中 query() 函数的用法,涵盖基于列的代数式过滤、SQL 风格的 in/not in 操作以及包含外部变量引用的复杂表达式。通过具体代码示例解析 @x.name 等符号含义,帮助开发者高效实现 DataFrame 的条件筛选与数据提取。
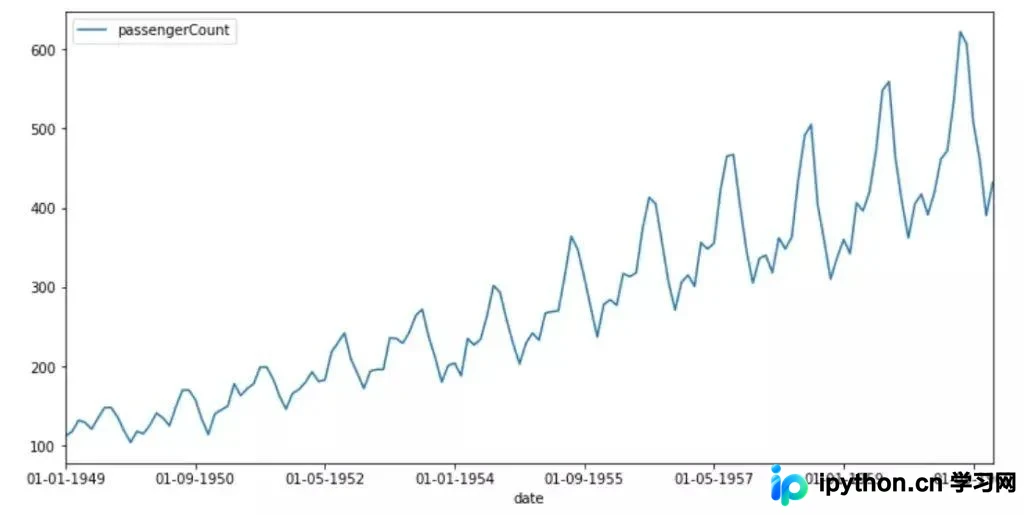
本文深入解析Python中的时间序列预测技术。从基础概念入手,详解如何可视化AirPassengers数据,识别趋势、季节性与周期性要素。重点对比经典分解、X11与STL分解算法,并演示简单移动平均(SMA)、加权移动平均(WMA)及指数平滑(EMA/Holt)等预测模型的Python实现与代码应用。
本文介绍如何利用pandas的apply方法结合axis=1参数,对DataFrame的多列数据进行行级计算并生成新列。通过具体代码示例演示了如何定义lambda函数处理多列数据,并展示了从数据创建到结果输出的完整流程,帮助开发者高效实现复杂的数据处理需求。
本文介绍如何利用Python自动实现Excel中相同数据区域的单元格合并。通过结合pandas进行数据分组定位,以及openpyxl执行具体的合并操作,解决了手动指定行列范围的繁琐问题。文章提供了完整的代码示例,并封装为基于tkinter的图形界面工具,提升了批量处理Excel文件的效率。
本文详细解析pandas中DataFrame的条件筛选方法。重点介绍使用布尔型DataFrame进行单条件与多条件筛选的正确写法,指出使用and/or运算符导致的ValueError错误及解决方案。深入对比loc、iloc及已弃用的ix方法的索引机制,说明标签索引与位置索引的区别,并演示如何结合逻辑表达式进行行列筛选。

本文详解Python中利用scipy.stats模块生成指定概率分布随机数的方法。重点讲解norm.rvs函数的loc和scale参数对期望与标准差的设定,以及size参数控制数组形状。通过具体代码实例展示如何生成正态分布等随机数,适用于统计分析场景。
本文详细介绍如何使用Python结合PySimpleGUI和Pandas库开发一款数据预处理小工具。通过构建图形用户界面,实现Excel文件的读取与预览,并自动化处理重复值、缺失值及异常值。文章涵盖界面布局设计、核心代码解析、数据处理逻辑及使用PyInstaller打包成可执行文件的全过程,旨在提供一键完成数据清洗的实用方案。
本文详细介绍Python中Pandas库的交叉表(crosstab)功能,涵盖其语法参数、默认频数统计及自定义聚合。同时深入解析如何利用groupby结合apply和cut函数,手动构建复杂的交叉分组表,适用于离散数据的统计汇总场景。
本文详解Python中Pandas库下DataFrame与Array(数组)的相互转换方法。通过pd.DataFrame()可将数组直接转为数据框,利用.values属性可将数据框还原为数组。文章提供具体代码实例,展示如何创建包含姓名薪资的数据框并提取其底层数组结构,帮助开发者掌握基础数据结构转换技巧。
本文介绍如何使用Python调用高德地图Web服务API,实现从CSV文件批量读取地址并转换为经纬度的功能。通过requests发送请求,利用pandas库处理数据,最终将转换结果保存为新的CSV表格,适用于需要批量地理编码的场景。