Python 数据可视化利器:Plotly 入门与实战
本文详细介绍 Python 第三方库 Plotly 的安装与基础用法。作为强大的在线数据分析与可视化工具,Plotly 支持多种语言接口。文章通过 Jupyter Notebook 环境,演示了如何绘制高质量的折线图、直方图和散点图,涵盖从环境配置到代码实现的完整步骤,帮助开发者快速掌握交互式图表制作技巧。
2026-10-14
7

本文详细介绍 Python 第三方库 Plotly 的安装与基础用法。作为强大的在线数据分析与可视化工具,Plotly 支持多种语言接口。文章通过 Jupyter Notebook 环境,演示了如何绘制高质量的折线图、直方图和散点图,涵盖从环境配置到代码实现的完整步骤,帮助开发者快速掌握交互式图表制作技巧。
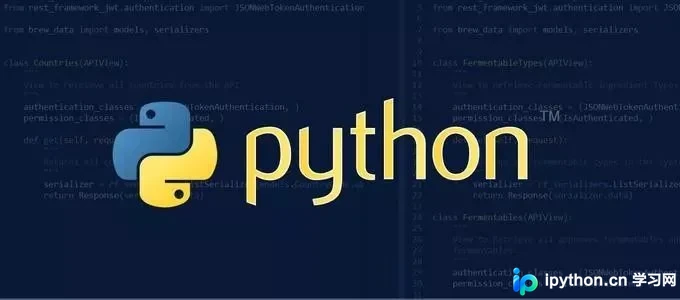
本文详解Python中利用pandas库实现Excel风格数据透视表的两种核心方法。通过pd.pivot_table()函数直接生成透视表,以及使用groupby结合agg进行分组聚合,对比两者的代码实现与适用场景。文章包含读取Excel、按客户名称汇总销量、排序、格式化处理及设置多级索引的完整代码示例,帮助开发者掌握更高效的数据处理技巧。
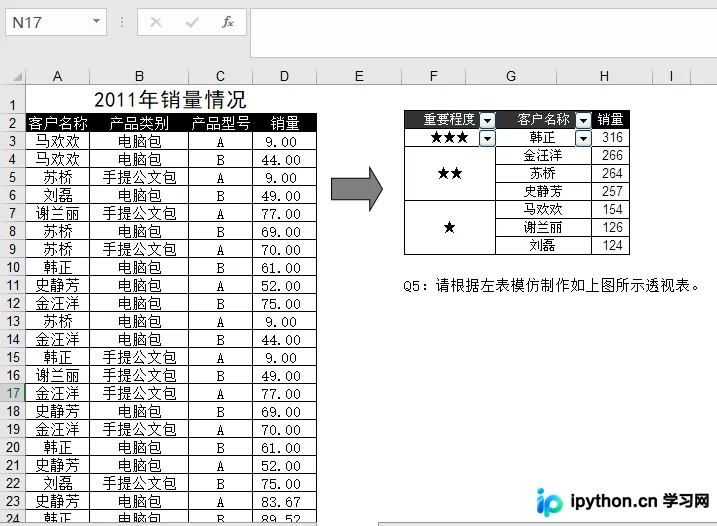
本文详细介绍如何使用Python读取xlsx文件。通过安装xlrd和pandas两个常用库,分别演示了基于工作表对象的数据提取方式以及DataFrame的高效读取方法。内容涵盖安装步骤、核心代码示例及行列操作技巧,帮助开发者快速掌握Excel数据处理技能。
本文介绍如何利用 pandas 的 read_csv 函数中的 chunksize 参数,实现对大型 CSV 文件的逐块读取与处理。通过示例代码演示了 TextParser 对象的迭代使用、Series 对象的 value_counts 统计以及 add 方法的累加合并技巧,有效解决内存溢出问题,适用于海量数据清洗与分析场景。
本文介绍在Pandas中交换DataFrame列顺序的两种常用方法。第一种通过获取列名列表,利用list的pop和insert方法调整顺序后,使用loc重新选取列;第二种直接通过赋值操作交换指定两列的值并更新列名。最后演示如何将调整后的数据保存回CSV文件,适用于数据清洗和特征工程场景。
本文详细介绍在pandas中抽取DataFrame行列数据的多种方法。涵盖直接使用列名、矩阵索引切片以及.loc和.iloc的高级用法。重点解析.loc基于标签和.iloc基于整数位置的区别,并说明省略参数时的默认行为及逗号分隔的重要性,帮助开发者准确获取所需数据。
本文介绍在Python Pandas库中如何计算两个Dataframe的交集与差集。通过pd.merge方法结合inner连接获取交集,支持指定列进行匹配。对于差集,演示了利用concat和drop_duplicates去除重复项的方法,分别计算df1-df2及df2-df1的结果,并提供另一种基于append和drop_duplicates的实现思路,帮助开发者高效处理数据差异。
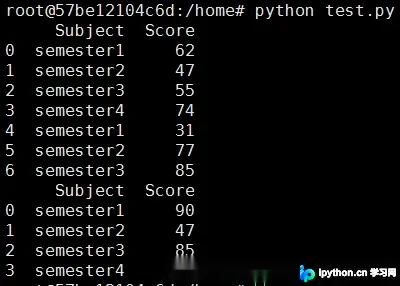
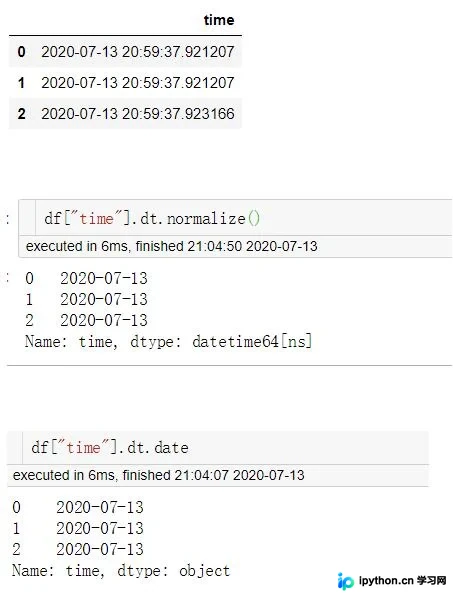
本文详解pandas中dt访问器的核心功能,涵盖日期部分提取、年月日时分秒获取、星期与季度判断、闰年检测及月份名称转换。结合str属性与apply函数,演示如何高效进行时间序列数据的筛选、比较与自定义处理,助力Python数据分析工作流。
本文介绍如何在PyCharm中配置Matplotlib以在独立窗口显示图像,通过取消Python Scientific工具选项实现。同时提供Pandas库在PyCharm中绘图时的兼容解决方案,即通过添加plt.show()语句确保Series和DataFrame图表正常渲染,解决IDE内嵌显示问题。
本文介绍如何在Python3中使用Pandas库为Excel表格设置布局背景颜色。通过定义特定的格式对象(如bg_format),可以高亮显示关键数据或标题,提升表格可读性。文章提供了完整的代码示例,展示如何遍历Sheet页并应用背景色、字体及对齐方式等样式设置。
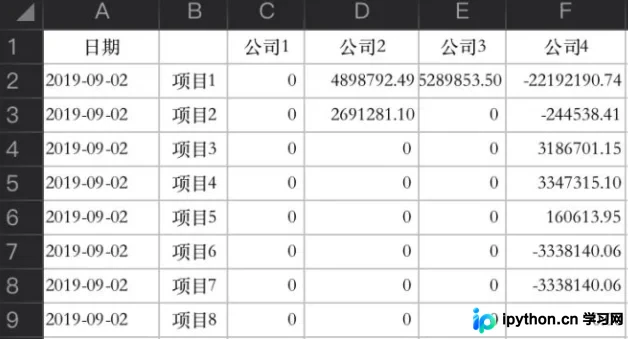
本文介绍如何在Django项目中利用count()方法实现数据计数功能。通过修改apiviews.py获取统计值,并在apitest_manage.html模板中渲染展示,完成从后端逻辑到前端页面的完整数据展示流程。
本文深入解析pandas中DataFrame赋值失败的常见场景,涵盖整列直接赋值、单值与多值非整列赋值以及跨列赋值的正确做法。重点阐述使用.loc进行条件赋值时因形状不匹配导致的报错原因,并提供通过.values.tolist()获取列表的正确实现方式,帮助开发者避免常见陷阱。