

pandas添加自增列的2种实现方案

发布时间:2026-10-14| 2人浏览过
本文介绍在pandas中为DataFrame添加自增列的两种常用方法。第一种通过重置索引并修改列名,第二种利用insert方法在指定位置插入范围数据。此外还补充了新增带有默认值的列以及读写CSV文件的完整示例,帮助开发者快速实现ID生成与数据预处理。
在实际数据处理中,经常需要为数据表添加一列自动递增的数字。以下是两种常用的实现方式:
第一种方法
>>> import pandas as pd
>>> df = pd.DataFrame([{'name':'apple', 'count':4},\
            {'name':'orange', 'count':2}])
>>> df = df.reset_index()
>>> df.columns.values[0] = 'New_ID'
>>> df['New_ID'] = df.index + 880
>>> df
  New_ID  name count New_ID
0    0  apple   4   880
1    1 orange   2   881
第二种方法
>>> import pandas as pd
>>> df = pd.DataFrame([{'name':'apple', 'count':4},\
            {'name':'orange', 'count':2}])
>>> df.insert(0, 'New_ID', range(880, 880 + len(df)))
>>> df
  New_ID  name count
0   880  apple   4
1   881 orange   2
补充说明:除了自增列,pandas也支持新增带有默认值的列。
原始数据示例:
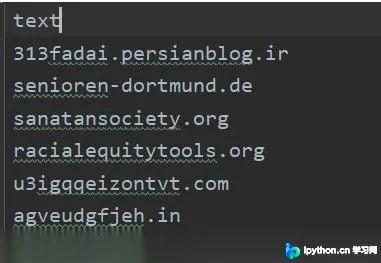
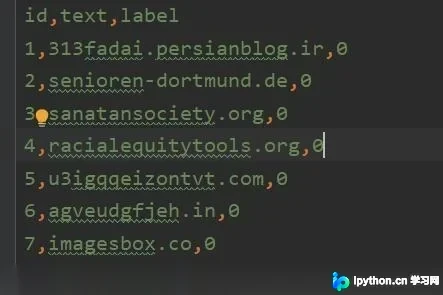
假设我们希望在'text'列之前插入一列作为ID(数值从小到大递增),并在末尾添加一列标签列,默认值设为0。
import pandas as pd

data = pd.read_csv('test.txt')
n = len(data)+1
nlist = range(1,n)
data['id'] = nlist

data['label'] = 0
print(data.head())
data.to_csv('newTest.csv',columns=['id','text','label'],index=0,header=1)
可以加上 df=pd.read_csv(sourceFile,low_memory=False) #读取csv,设置low_memory=False防止内存不够时报警告

#以下保存指定的列到新的csv文件,index=0表示不为每一行自动编号,header=1表示行首有字段名称
最终数据结果:
以上为个人经验分享,旨在提供参考。如有错误或未考虑周全之处,欢迎批评指正。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









