

Python 更快进行探索性数据分析的四个方法
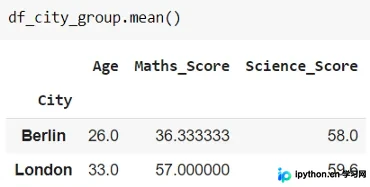
本文介绍Python中利用Pandas库加速探索性数据分析的四种实用方法。包括通过创建groupby对象复用聚合结果以节省内存并提升速度,使用nlargest和nsmallest快速获取Top N或Bottom N记录,以及利用比较运算符及其包装器进行高效数据切片和条件列生成。这些技巧能显著简化数据处理流程,提高分析效率。
2026-10-15
6

本文介绍Python中利用Pandas库加速探索性数据分析的四种实用方法。包括通过创建groupby对象复用聚合结果以节省内存并提升速度,使用nlargest和nsmallest快速获取Top N或Bottom N记录,以及利用比较运算符及其包装器进行高效数据切片和条件列生成。这些技巧能显著简化数据处理流程,提高分析效率。
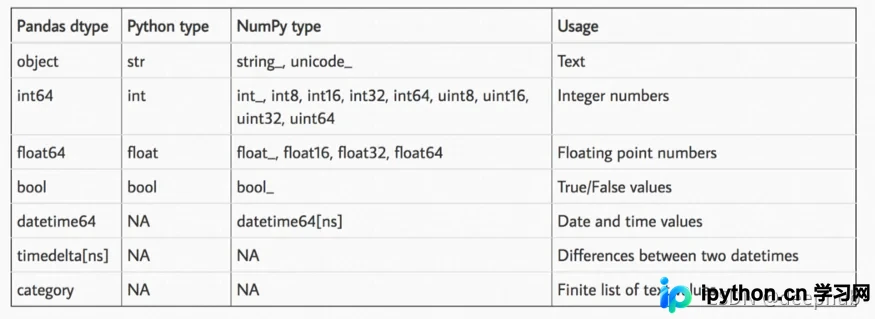
本文总结了pandas初学者在处理大规模数据集时常见的六个错误,包括使用read_csv读取大文件、未利用矢量化操作、未优化数据类型、忽略DataFrame样式设置、保存为CSV格式以及不阅读文档。通过对比实验,展示了使用datatable、NumPy矢量化、类型压缩及Parquet/Feather格式带来的显著性能提升,帮助开发者避免常见陷阱,提高数据处理效率。
本文深入对比Python操作MySQL、Oracle及MongoDB三大数据库的实战方法。详细解析Oracle环境配置与cx_Oracle库连接方式,MySQL连接参数及编码处理,以及MongoDB的增删改查与排序分页技巧。通过具体代码示例,帮助数据分析师快速掌握关系型与非关系型数据库的核心操作。
本文介绍基于Python3和Windows环境的爬虫开发基础,涵盖Anaconda与Jupyter工具使用。详细解析Robots协议规范、动态页面处理及反爬策略。同时展望Python在数据分析、人工智能、运维自动化及Web开发领域的核心应用与实战价值。
本文介绍利用Pandas库实现Excel文件的批量拆分与合并操作。通过iloc方法将大文件按行数均分保存,结合os模块遍历读取子文件并添加来源标记,最终使用pd.concat合并为单一Excel。
本文总结Python数据处理中常见的数据冲突、样本选取及共线性问题。详细解析多源数据冲突的特征与处理策略,对比简单随机、分层等抽样方法的适用场景,并深入探讨多重共线性的成因及岭回归、逐步回归等5种常用解决方法,为数据建模提供实用参考。
本文详解Pandas中处理文本数据的完整流程。涵盖object与string类型差异、大小写转换与对齐等基础字符串方法,深入讲解split、replace、cat等拆分替换拼接技巧,以及利用正则表达式进行match、extract和虚拟变量提取的高级操作,助力高效数据清洗与分析。
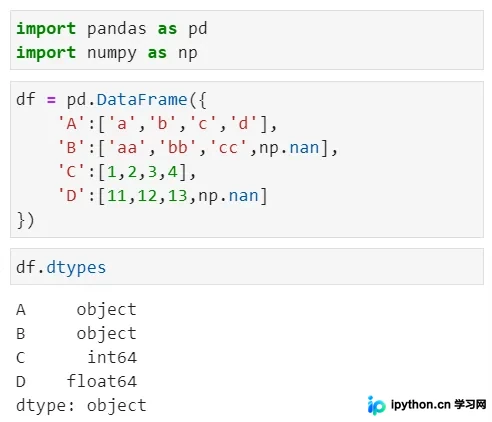
本文详细介绍Python中操作CSV文件的两种主要方式:内置csv库与第三方pandas库。涵盖读取表头、指定列、写入数据、统计分析及文件复制等常见操作,并提供具体代码示例与参数说明,帮助开发者高效处理表格数据。
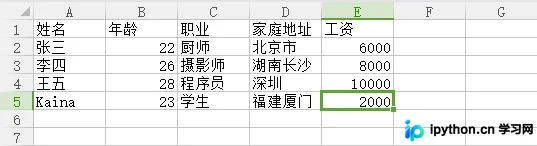
本文详细介绍pandas中DataFrame.shift()函数的使用方法。通过解析periods和axis参数,演示数据在行与列方向的上下左右移动。结合地铁站进出站数据的实际案例,展示如何利用shift计算小时级净流量,并处理由此产生的NaN值,帮助读者掌握时间序列数据处理技巧。
本文详细梳理了SQL Server 2008的关键新特性,涵盖TVF/临时表/表变量/CTE的性能差异与适用场景。深入解析了sql_variant、日期时间类型演进、MERGE语句的同步逻辑,以及GROUPING SETS的高级聚合用法。同时提供了CTE递归查询和PIVOT/UNPIVOT行列转换的实际代码示例,助力开发者掌握高效SQL编写技巧。
本文详解如何在Python中利用Pandas库高效读写MySQL数据库。通过结合pymysql和SQLAlchemy,实现从数据库读取数据生成DataFrame,以及将DataFrame写入数据库表的操作。包含完整的连接配置、查询及写入代码示例,适用于大数据处理场景。
本文介绍如何使用 Python 读取以空格为分隔符的数据文件,如 Boston 房价预测数据集。通过 pandas 的 read_csv 函数设置 delim_whitespace 参数实现解析,并探讨 header 和 names 参数的用法。此外,提供一个自定义 DealData 类,封装文件加载、折半查找及保存功能,供参考。