

Pandas文本数据处理全指南:从类型到高级操作

本文详解Pandas中处理文本数据的完整流程。涵盖object与string类型差异、大小写转换与对齐等基础字符串方法,深入讲解split、replace、cat等拆分替换拼接技巧,以及利用正则表达式进行match、extract和虚拟变量提取的高级操作,助力高效数据清洗与分析。
前言
在日常工作场景中,我们经常需要处理各类文本信息,从中解析出关键数据以支持后续的分析工作。
文本解析往往是一项繁琐且容易出错的任务,而Pandas提供了针对此类数据的强大处理工具,接下来我们将一同探索这些实用的处理方法。
1. 文本数据类型
在Pandas中,存储文本数据主要有两种类型:object和string。在Pandas 1.0版本之前,object是唯一的文本存储类型,当列中包含数值与文本混合数据时,默认也会被识别为object类型。自Pandas 1.0版本起,引入了专门的string类型,旨在提供更优的字符串处理支持。
1.1. 类型简介
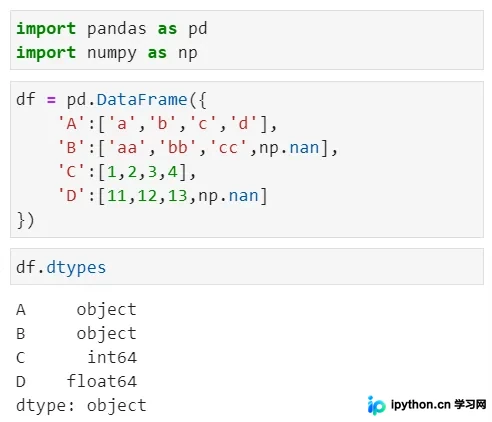
默认情况下,Pandas仍使用object作为文本数据的默认存储类型。
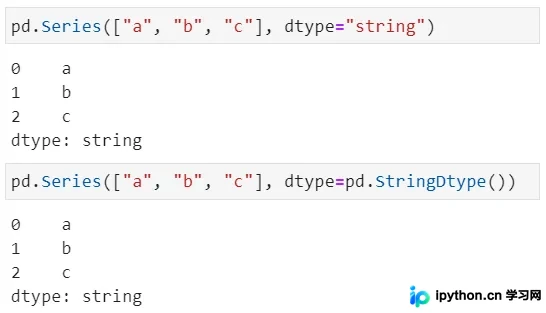
若需指定使用string类型,可以在创建数据时通过dtype参数进行设置。
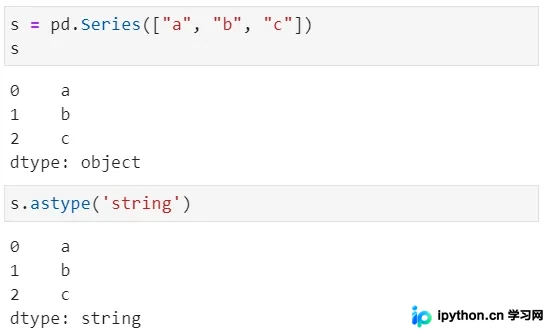
对于已创建的Series或DataFrame,我们也可以使用astype方法强制转换为string类型。
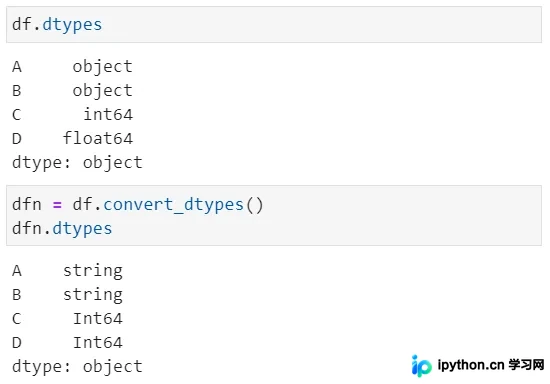
此外,Pandas还提供了df.convert_dtypes()方法,能够根据数据内容智能推断并选择最合适的数据类型。
1.2. 类型差异
string类型与object类型在操作行为上存在显著差异。
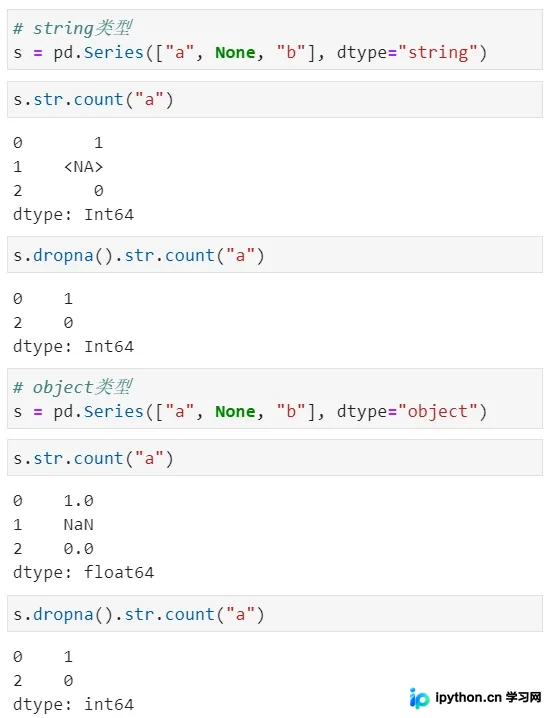
对于返回数值结果的字符串访问器方法,string类型始终返回可为空的整数类型(Int64);而object类型则根据是否存在NA值,返回int或float类型。
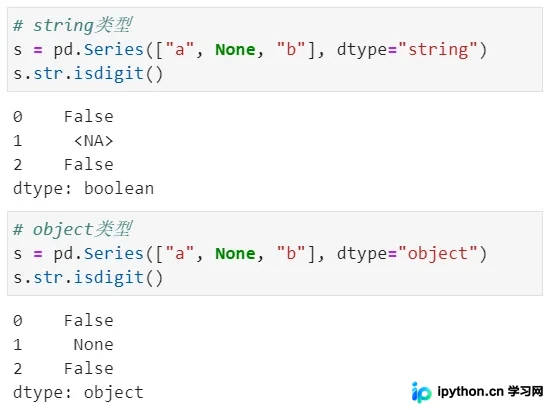
对于返回布尔结果的方法,string类型会返回可为空的布尔数据类型(boolean),而object类型则返回标准的bool类型。
2. 字符串方法
Series和Index对象均提供了丰富的字符串处理方法,通过str属性即可访问。这些方法的一个关键特性是会自动忽略缺失值(NA),从而简化数据处理流程。
2.1. 文本格式
文本格式化处理主要涉及字符串的大小写转换等操作,例如将文本统一转为大写或小写。
>>> s = pd.Series(
...     ["A", "B", "Aaba", "Baca", np.nan, "cat"],
...     dtype="string"
... )
>>> s.str.lower() # 转小写
0       a
1       b
2    aaba
3    baca
4    <NA>
5     cat
dtype: string
>>> s.str.upper() # 转大写
0       A
1       B
2    AABA
3    BACA
4    <NA>
5     CAT
dtype: string
>>> s.str.title() # 每个单词大写
0       A
1       B
2    Aaba
3    Baca
4    <NA>
5     Cat
dtype: string
>>> s.str.capitalize() # 首字母大写
0       A
1       B
2    Aaba
3    Baca
4    <NA>
5     Cat
dtype: string
>>> s.str.swapcase() # 大小写互换
0       a
1       b
2    aABA
3    bACA
4    <NA>
5     CAT
dtype: string
>>> s.str.casefold() # 转为小写,支持其他语言
0       a
1       b
2    aaba
3    baca
4    <NA>
5     cat
dtype: string
2.2. 文本对齐
文本对齐功能允许在显示文本时按照特定规则进行排版,包括左对齐、右对齐和居中对齐等样式。
>>> s.str.center(10,fillchar='-') # 居中对齐,宽度为10,填充字符为'-'
0    ----A-----
1    ----B-----
2    ---Aaba---
3    ---Baca---
4          <NA>
5    ---cat----
dtype: string
>>> s.str.ljust(10,fillchar='-') # 左对齐
0    A---------
1    B---------
2    Aaba------
3    Baca------
4          <NA>
5    cat-------
dtype: string
>>> s.str.rjust(10,fillchar='-') # 右对齐
0    ---------A
1    ---------B
2    ------Aaba
3    ------Baca
4          <NA>
5    -------cat
dtype: string
>>> s.str.pad(width=10, side='left', fillchar='-') # 指定宽度,填充字符对齐方式为 left,填充字符为'-'
0    ---------A
1    ---------B
2    ------Aaba
3    ------Baca
4          <NA>
5    -------cat
dtype: string
>>> s.str.zfill(3) # 指定宽度3,不足则在前面添加0
0     00A
1     00B
2    Aaba
3    Baca
4    <NA>
5     cat
dtype: string
2.3. 计数与编码
文本计数与编码功能用于统计字符串长度、字符出现次数,以及进行字符编码与解码操作。
>>> s.str.count("a") # 字符串中指定字母的数量
0       0
1       0
2       2
3       2
4    <NA>
5       1
dtype: Int64
>>> s.str.len() # 字符串的长度
0       1
1       1
2       4
3       4
4    <NA>
5       3
dtype: Int64
>>> s.str.encode('utf-8') # 编码
0       b'A'
1       b'B'
2    b'Aaba'
3    b'Baca'
4       <NA>
5     b'cat'
dtype: object
>>> s.str.encode('utf-8').str.decode('utf-8') # 解码
0       A
1       B
2    Aaba
3    Baca
4    <NA>
5     cat
dtype: object
2.4. 格式判断
格式判断功能用于检测字符串是否符合特定格式,例如判断其是否仅包含数字、字母、小数或空格等。
>>> s = pd.Series(
...     ["A", "B", "Aaba", 12, 5, np.nan, "cat"],
...     dtype="string"
... )
>>> s.str.isalpha() # 是否为字母
0     True
1     True
2     True
3    False
4    False
5     <NA>
6     True
dtype: boolean
>>> s.str.isnumeric() # 是否为数字0-9
0    False
1    False
2    False
3     True
4     True
5     <NA>
6    False
dtype: boolean
>>> s.str.isalnum() # 是否由数字或字母组成
0    True
1    True
2    True
3    True
4    True
5    <NA>
6    True
dtype: boolean
>>> s.str.isdigit() # 是否为数字
0    False
1    False
2    False
3     True
4     True
5     <NA>
6    False
dtype: boolean
>>> s.str.isdecimal() # 是否为小数
0    False
1    False
2    False
3     True
4     True
5     <NA>
6    False
dtype: boolean
>>> s.str.isspace() # 是否为空格
0    False
1    False
2    False
3    False
4    False
5     <NA>
6    False
dtype: boolean
>>> s.str.islower() # 是否为小写
0    False
1    False
2    False
3    False
4    False
5     <NA>
6     True
dtype: boolean
>>> s.str.isupper() # 是否为大写
0     True
1     True
2    False
3    False
4    False
5     <NA>
6    False
dtype: boolean
>>> s.str.istitle() # 是否为标题格式
0     True
1     True
2     True
3    False
4    False
5     <NA>
6    False
dtype: boolean
上述字符串处理方法在功能上与Python原生字符串方法基本一致,但在Pandas中针对Series进行了向量化优化。
3. 文本高级操作
文本高级操作涵盖了拆分、替换、拼接、匹配与提取等核心功能。掌握这些技巧,即可应对大多数复杂的文本信息处理与分析需求。
3.1. 文本拆分
文本拆分功能类似于Excel中的数据分列,允许按照指定字符或规则将文本分割。具体实现可参考以下案例。
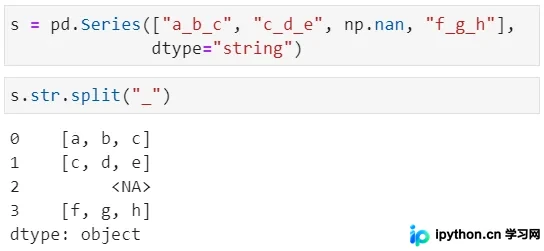
split()方法返回的结果是一个列表对象。
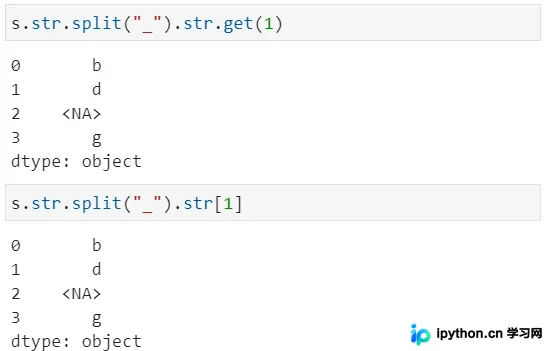
我们可以通过get方法或索引符号[]来访问拆分后列表中的特定元素。
若希望将拆分后的列表直接展开为多列,需使用expand参数。
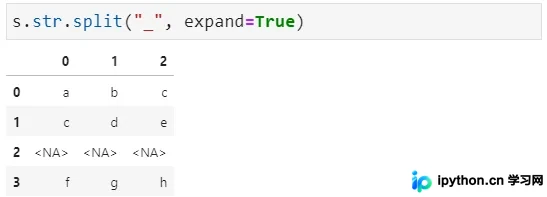
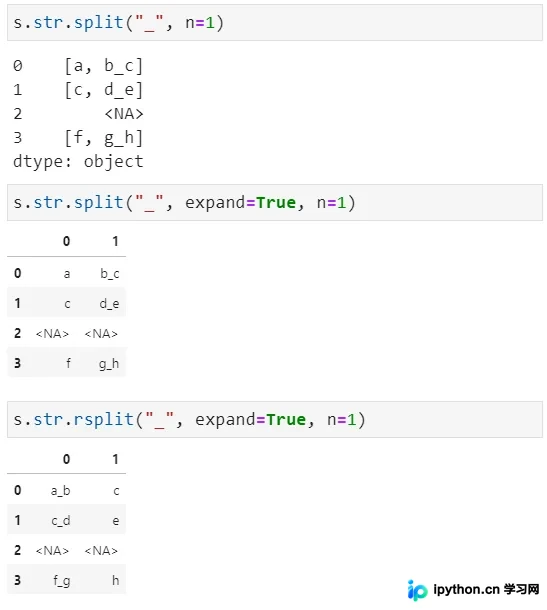
同样,我们可以限制拆分的次数,默认从左向右分割,若需从右向左可使用rsplit,通过n参数控制分割次数。
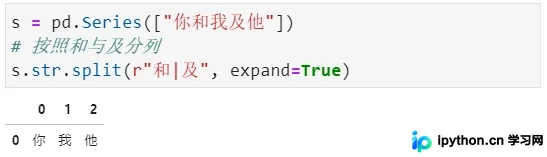
对于更复杂的分割需求,可以在分隔符参数中传入正则表达式以实现灵活拆分。
补充说明:str.slice()切片选择方法与str.partition()文本划分方法也能实现类似效果,建议查阅官方文档案例以深入了解。
3.2. 文本替换
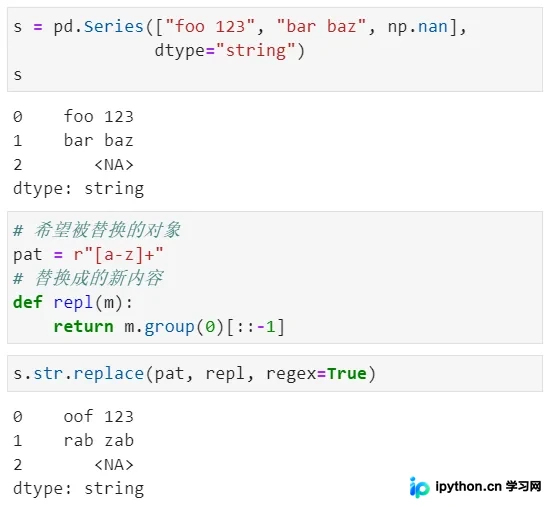
在数据处理中,替换指定内容是一项常见需求。对于文本数据,str.repalce()方法同样能高效满足这一操作。
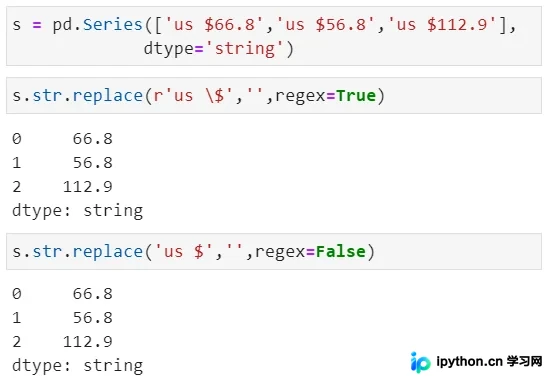
在上述案例中,若将regex参数设置为False,则执行字面量替换(不进行正则转义);若为True,则执行正则表达式替换。
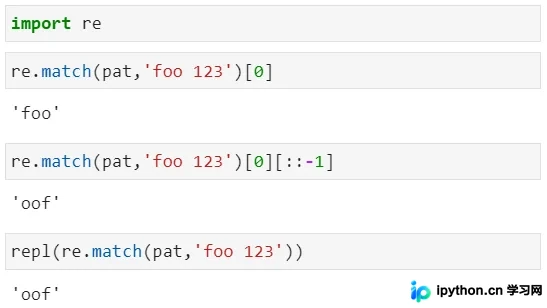
此外,我们还可以结合正则表达式进行复杂替换,例如以下示例展示了如何将文本中的英文部分进行倒序处理。
若对上述正则案例的理解存在困难,此处提供简要拆解说明。
关于正则表达式的更多用法,可参考此前的相关文章《》以获取更深入的知识。
另外,我们还可以利用str.slice_replace()方法来实现保留选定内容并替换其余内容的操作。
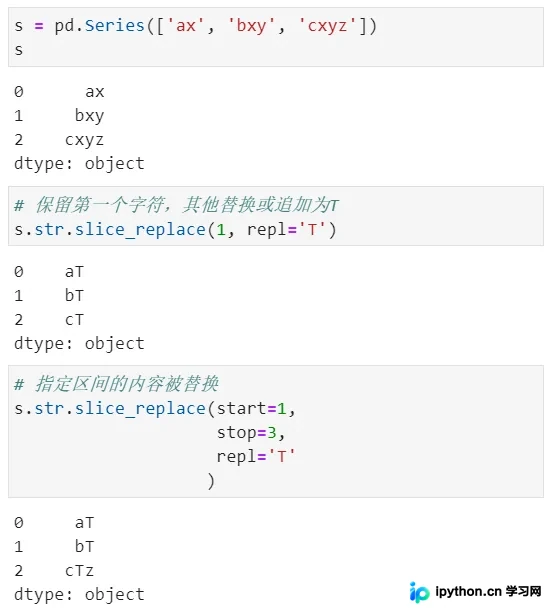
补充:通过str.repeat()方法,我们可以让原有文本内容重复指定次数,具体效果可自行尝试。
3.3. 文本拼接
文本拼接功能用于将多个文本字符串连接在一起,主要基于str.cat()方法实现。
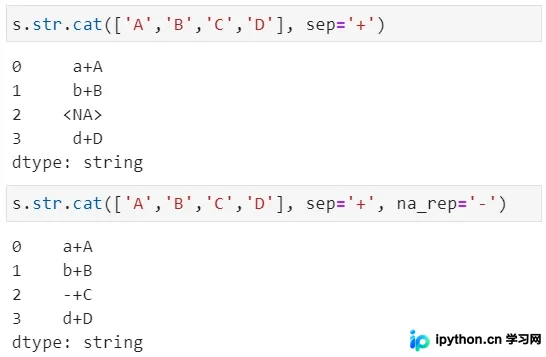
例如,拼接一个序列的内容时,默认会忽略缺失值,但也可以指定缺失值的处理方式。
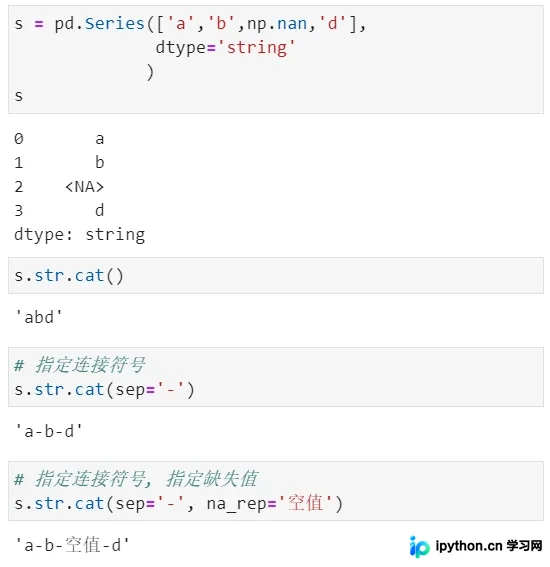
当拼接一个序列与另一个等长列表时,若存在缺失值,结果中也会包含缺失值,不过可以通过指定na_rep参数来处理这种情况。
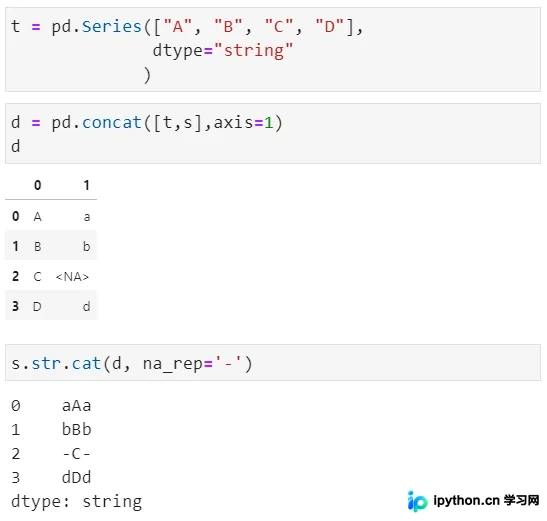
还可以拼接一个序列与另一个等长数组,前提是两者的索引一致。
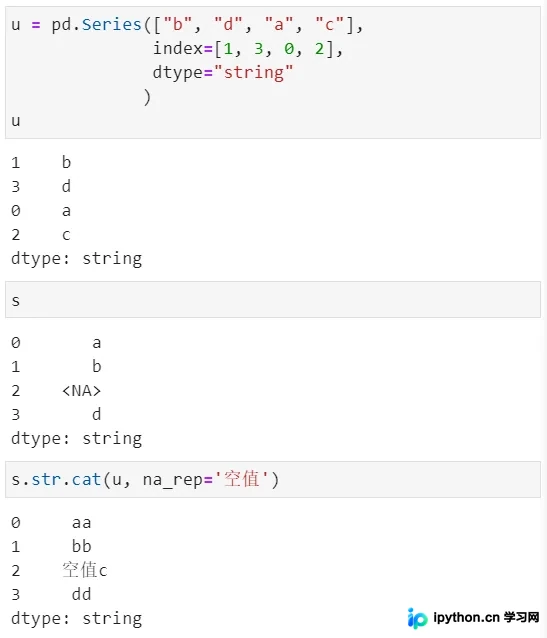
索引对齐
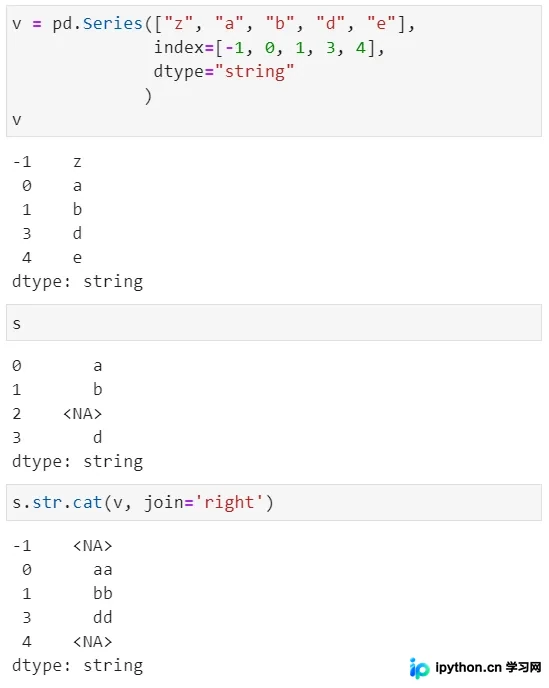
在索引对齐操作中,可通过join参数指定对齐形式,默认值为左对齐(left),此外还支持outer、inner和right等模式。
3.4. 文本匹配
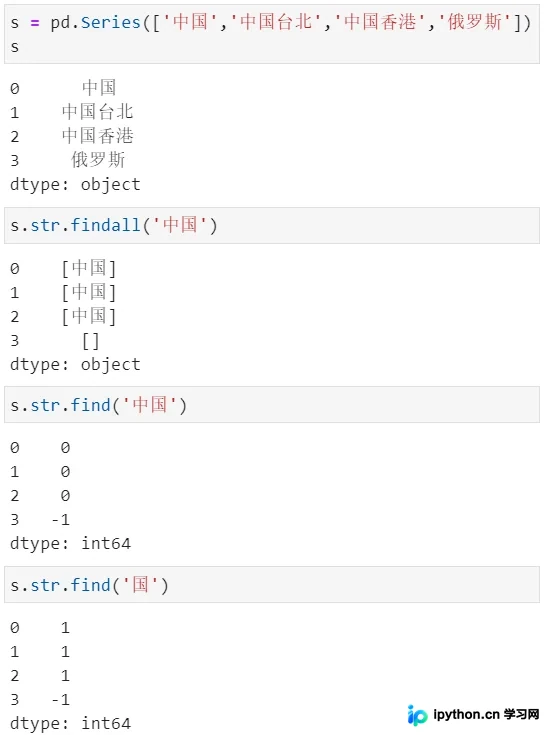
文本匹配主要介绍查询与包含判断,分别涉及str.findall()、str.find()和str.contains()等方法。
在文本查询中,str.findall()返回匹配到的具体值,而str.find()返回匹配结果的位置索引(若不存在则返回-1)。
在文本包含判断中,str.contain()常用于数据筛选场景。
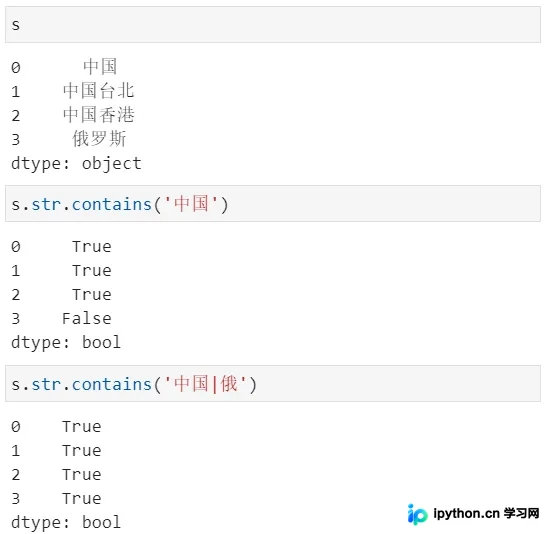
此外,str.startwith()和str.endwith()分别用于判断字符串是否以特定字符开头或结尾,而str.match()则支持基于正则表达式的匹配。
3.5. 文本提取
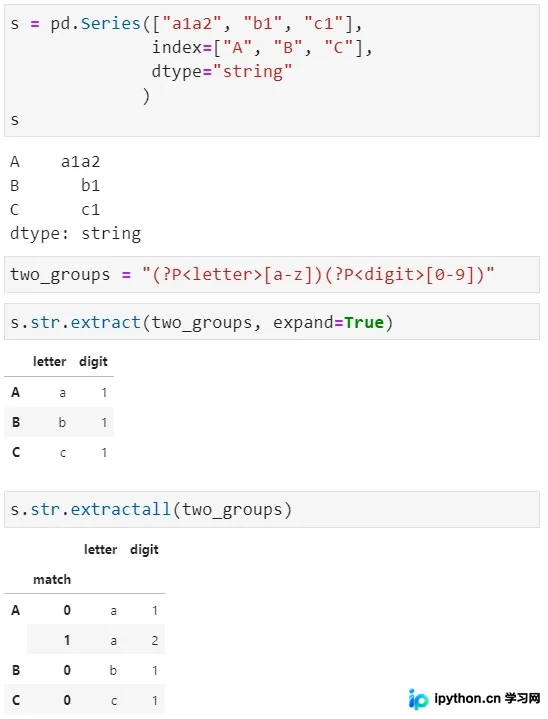
日常工作中,经常需要从序列文本中提取特定的字符串子集,此时使用str.extract()方法可高效处理。该方法利用正则表达式提取满足条件的数据,并将其形成独立的列。
例如以下案例,我们使用正则表达式将文本分为两部分:第一部分匹配字母a和b,第二部分匹配数字。
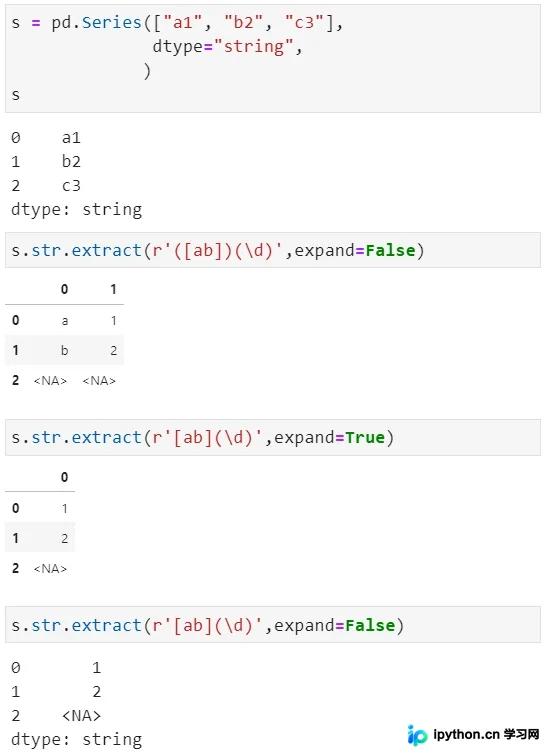
在上述案例中,当expand参数为False时,若返回结果仅为一列,则类型为Series;否则为DataFrame。
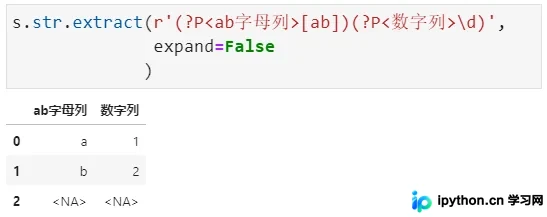
我们还可以对提取的列进行命名,格式如?P<列名称>所示,具体操作如下。
提取全部匹配项的功能会将文本中所有符合规则的内容匹配出来,最终形成多层索引数据。
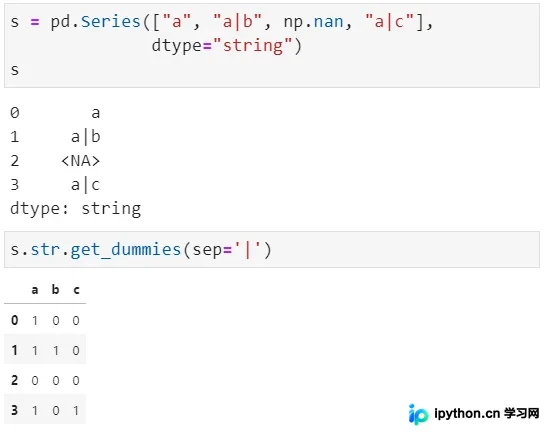
我们还可以从字符串列中提取虚拟变量,例如使用"|"作为分隔符(第一行abc仅含a,第二行含a和b,第三行均无,第四行含a和c)。
以上就是本次关于Pandas文本数据处理的全部内容。相信熟练运用这些操作后,您在日常工作中处理文本数据将更加得心应手。
总结
至此,关于Pandas文本数据处理的介绍已告一段落。如需了解更多相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









