Pandas merge()函数:参数详解与连接类型实战
本文深入解析Pandas中merge()函数的核心用法,涵盖inner、outer、left、right四种连接模式。详细讲解how、on、left_on、right_on、suffixes等关键参数的配置方法,并通过具体代码示例演示如何处理多列匹配、索引连接及重复列后缀处理,帮助开发者高效实现数据集合并。
2026-10-15
6

本文深入解析Pandas中merge()函数的核心用法,涵盖inner、outer、left、right四种连接模式。详细讲解how、on、left_on、right_on、suffixes等关键参数的配置方法,并通过具体代码示例演示如何处理多列匹配、索引连接及重复列后缀处理,帮助开发者高效实现数据集合并。
本文详细介绍在Pandas中创建Category类型数据的两种主要方法。首先讲解如何直接指定预设类别创建分类数据,其次演示如何利用分箱机制(结合max、mean、min)动态生成Category类型。通过具体代码示例,展示如何处理空值、NaN及多字段数据分类,帮助开发者高效进行数据预处理与分类管理。
本文介绍如何在pandas中实现类似SQL row_number()的组内排序与排名功能。通过groupby结合rank或apply排序方法,可为DataFrame指定列按分组添加序号。示例涵盖薪资与班级得分场景,提供多种实现代码及注意事项,帮助开发者高效处理分组数据。
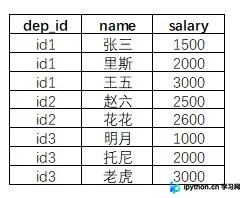
本文介绍在 Pandas 中快速筛选包含特定字符列的三种常用方法:利用 if 判断结合列表推导式、使用 str.contains 配合列表解析,以及调用 DataFrame 的 filter 函数。重点解析 filter 函数的 like、regex 和 item 参数,展示如何结合行与列条件进行精准数据提取,并提供完整代码示例供参考。
本文详解如何使用Python实现疫情地图可视化。首先介绍json模块解析数据,接着通过requests模块爬取疫情接口,利用pandas将JSON转换为DataFrame并保存为Excel。最后,使用pyecharts库结合echarts地图包,绘制全国确诊疫情地图,展示从数据获取到可视化输出的完整流程。
本文系统讲解Pandas中缺失数据的处理流程。涵盖isna/isnull统计逻辑、dropna删除策略及thresh参数、fillna填充方法(含ffill/bfill与分组填充)、interpolate插值算法(线性、最邻近、索引插值)。同时解析np.nan与pd.NA的类型差异及Nullable类型优势,结合分类检验与KNN回归示例,提供完整代码实现与参数说明。
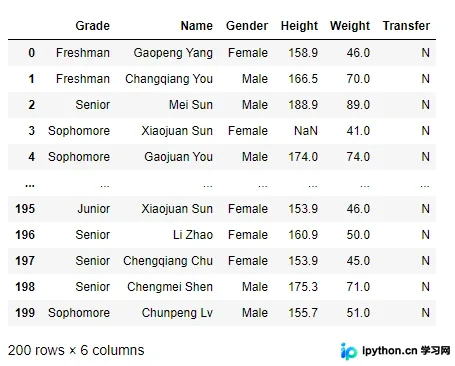
本文详细介绍Python中Pandas库的pivot()函数,用于数据重塑。解析index、columns、values三大参数,提供完整代码示例及注意事项,如使用reset_index()处理结果,帮助开发者高效进行数据分析与表格转换。
本文详细介绍如何使用pyecharts库在Python中进行数据可视化,涵盖柱状图、饼图、折线图及地图绘制。结合pandas处理JSON数据,通过获取国内疫情数据并转换为Excel,展示从数据抓取、清洗到可视化输出的完整流程。
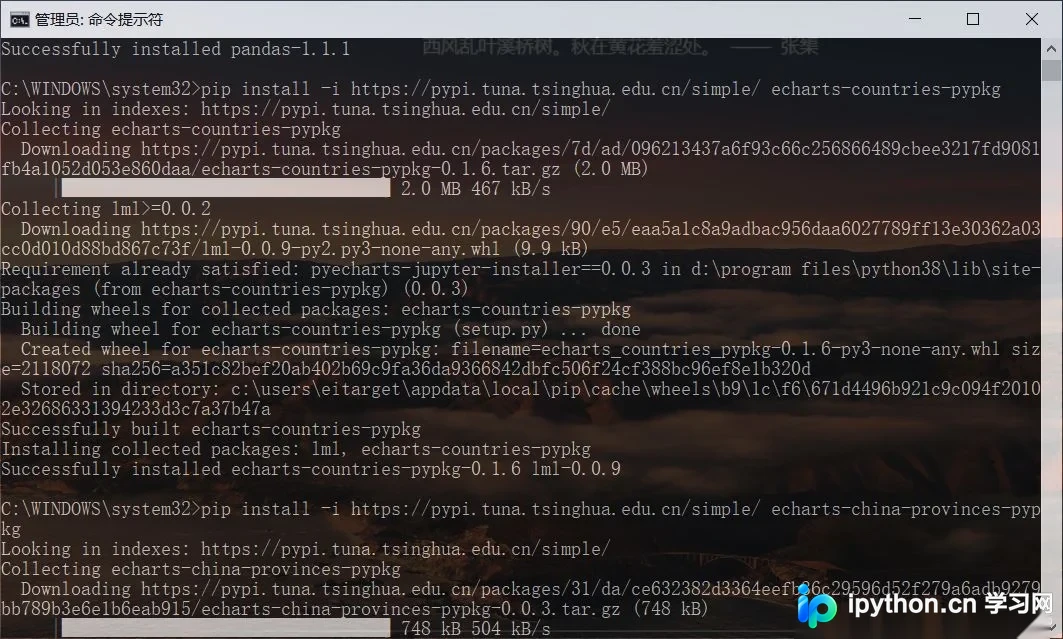
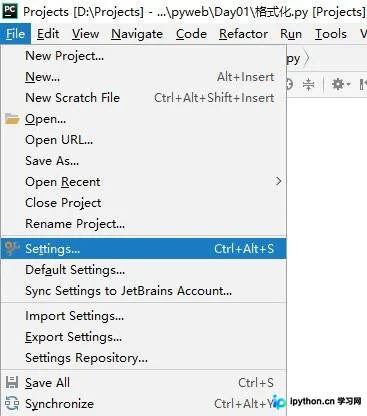
本文详细介绍在PyCharm中通过图形界面安装pandas库的步骤,以及如何在CMD命令行中使用pip安装模块。针对pip版本过旧导致的警告,文章演示了如何升级pip并解决Anaconda与独立Python环境下的pip版本冲突问题,指导用户正确使用pip或pip3命令。
本文介绍如何在Python中使用pandas处理数据,并结合sklearn库进行数据集划分。详细讲解train_test_split函数的随机划分方法及KFold交叉验证的原理与参数设置,包括shuffle和random_state的影响,帮助开发者优化模型训练流程。
本文深入解析Pandas库中自由度最高的Apply函数。详细讲解如何通过axis参数控制遍历方向,利用自定义函数实现行级或列级数据计算。重点演示如何结合*args和**kwds向Apply传递额外参数,以灵活处理如日期差计算等复杂逻辑,提升数据清洗效率。
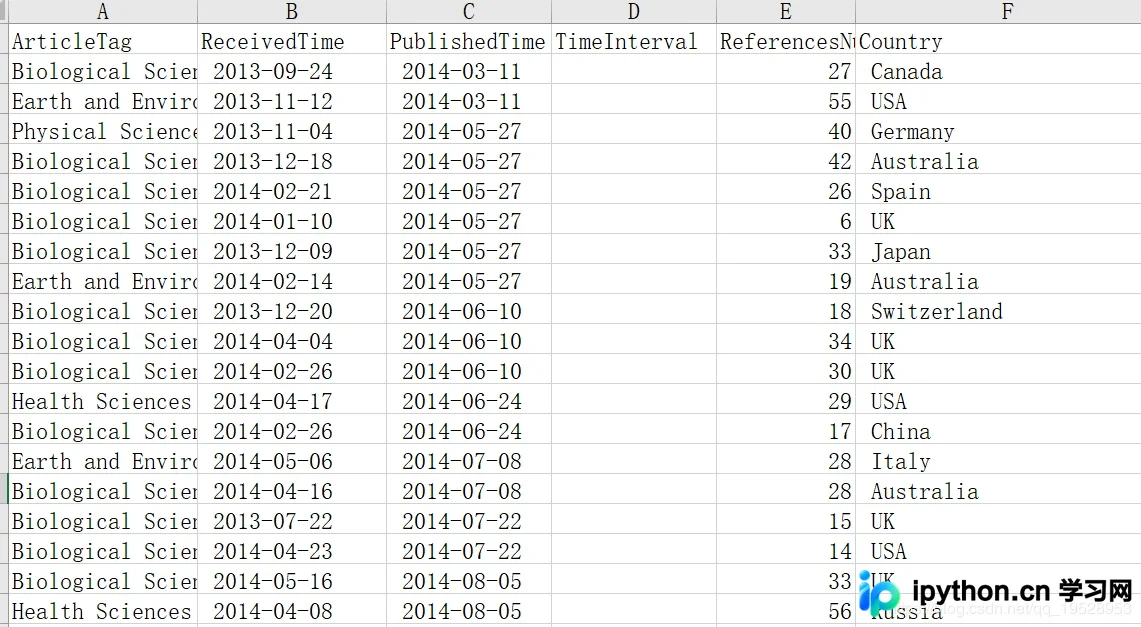
本文介绍Python中DataFrame的去重操作及如何提取重复数据。通过drop_duplicates函数,默认保留重复值,设置keep=False可去除重复值。结合concat与去重操作,可高效提取重复数据。此外,还演示了按单列或多列去重的具体方法,适用于数据分析中的常见需求。