Python Pandas loc布尔索引:单条件与多条件筛选详解
本文详细介绍Pandas中loc方法的布尔索引用法。通过具体代码示例,演示如何利用loc进行单条件筛选(如字段值大于特定阈值)及多条件组合筛选(使用&连接多个条件)。深入解析loc接收Series类型布尔值的过程,帮助开发者掌握高效的数据子集提取技巧。
2026-10-15
6

本文详细介绍Pandas中loc方法的布尔索引用法。通过具体代码示例,演示如何利用loc进行单条件筛选(如字段值大于特定阈值)及多条件组合筛选(使用&连接多个条件)。深入解析loc接收Series类型布尔值的过程,帮助开发者掌握高效的数据子集提取技巧。
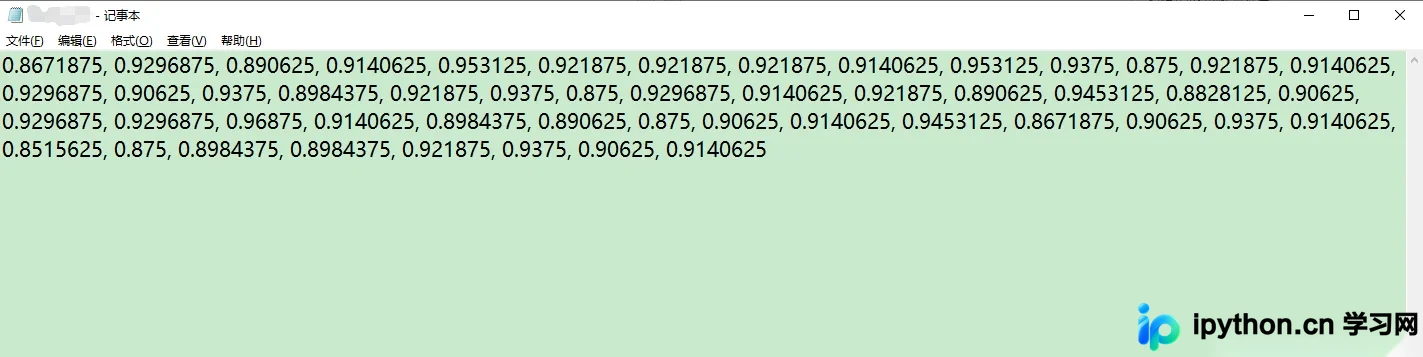
本文详细介绍在Python中读取TXT数据的三种主流方法。首先演示使用内置open函数进行基础读取与列表转换;其次讲解利用NumPy的loadtxt方法处理纯数值型实验数据,强调其返回ndarray类型的特性;最后介绍通过Pandas的read_table方法处理更复杂的文本格式,返回DataFrame对象。内容涵盖环境配置、代码示例及结果分析,适用于不同场景下的数据读取需求。
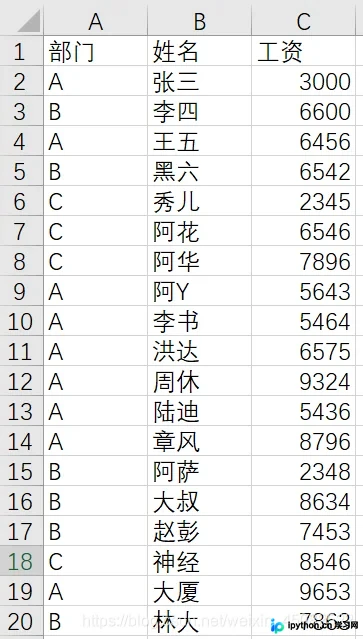
本文详细介绍如何使用Python Pandas库从Excel或CSV文件中读取指定的行和列数据。通过loc和iloc函数,您可以基于索引、位置或特定条件(如部门、工资范围)精准提取数据,并演示如何将筛选结果导出为新的Excel或CSV文件。
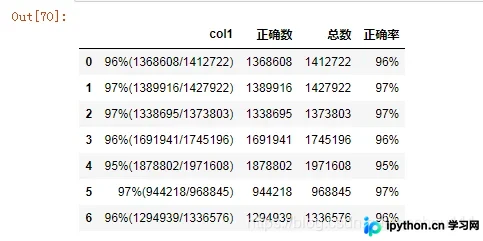
本文介绍了pandas中apply函数与lambda匿名函数的结合使用方法。通过具体示例,展示了如何利用apply和lambda处理字符串分割、数值计算等任务,包括将包含百分比和分数的字符串拆分为独立列,以及基于多列气象数据计算人体舒适指数。
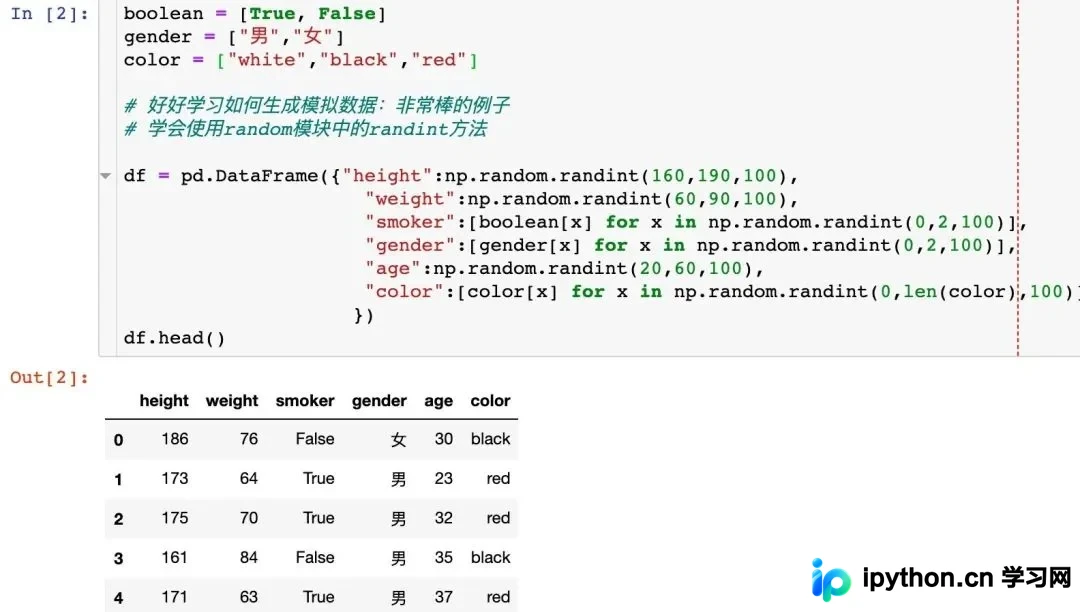
本文深入解析Pandas中处理数据的三大核心函数:map、apply和applymap。通过模拟数据演示,详细对比三者在Series与DataFrame上的应用差异,涵盖性别映射、数值运算及BMI计算等实际案例,帮助开发者高效完成数据清洗与转换任务。
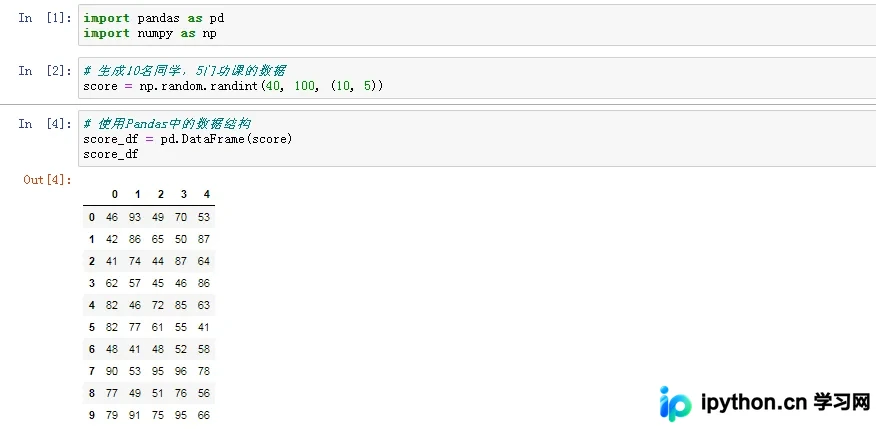
本文详细解析Python Pandas库中的核心数据结构,包括一维的Series和二维的DataFrame。内容涵盖两者的创建方法、关键属性(如index、values、shape)以及索引设置与重置技巧,帮助开发者掌握高效的数据处理基础。
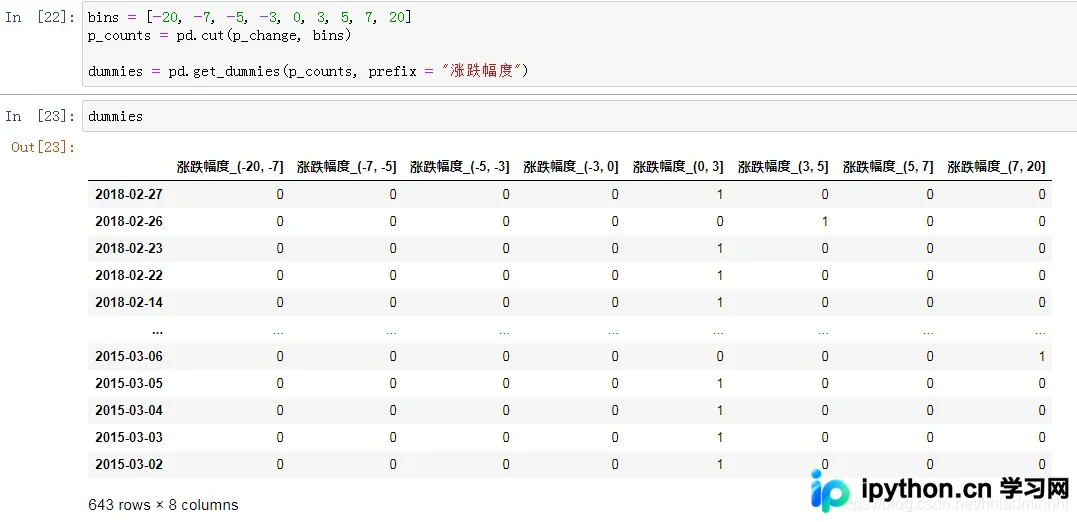
本文详解Python Pandas中数据离散化与合并的核心操作。介绍如何利用pd.cut和pd.qcut进行连续数据分组及One-hot编码,并通过pd.concat与pd.merge实现多表按行、列及不同连接方式(内、外、左、右)的合并,适用于数据挖掘前的预处理与分析场景。
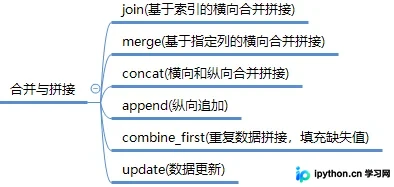
本文详解Python Pandas中数据合并与拼接的四种核心方法:基于索引的join、基于列的merge、支持纵向concat以及追加操作append。通过具体代码示例对比left/right/inner/outer连接方式,并补充combine_first与update的填充差异,帮助开发者高效处理多源数据。
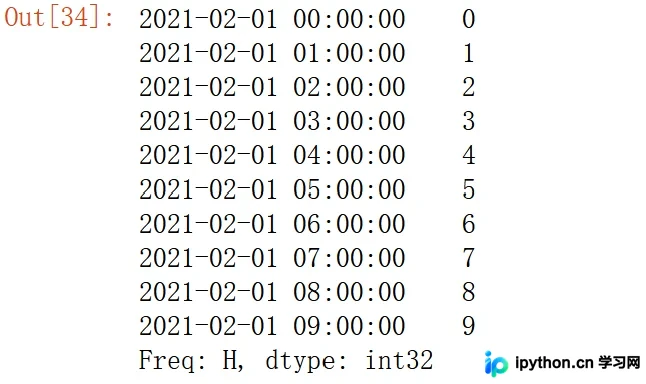
本文详细介绍Pandas中resample函数的核心参数closed和label。通过具体代码示例,解析这两个参数如何决定时间区间的闭合方式及聚合值的标签命名,帮助开发者准确控制时间序列重采样的行为。
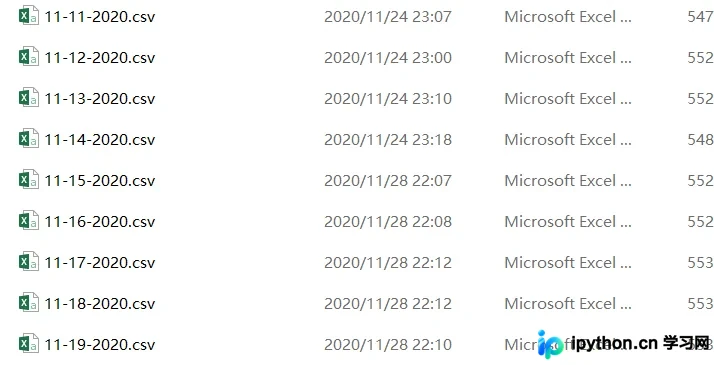
本文详细介绍如何使用Python合并本地CSV文件。内容涵盖单文件合并、单文件夹内多文件合并以及多文件夹递归合并三种场景。通过演示os、glob和pandas库的配合使用,重点解析skiprows参数处理索引冲突及递归函数遍历深层目录的方法,帮助开发者高效处理大规模数据文件。
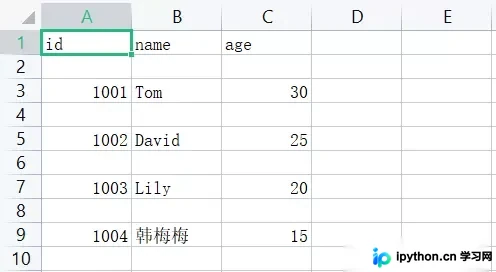
本文详细介绍Python中读写CSV文件的两种主流方法。通过内置csv模块和第三方pandas库,演示如何读取含中文的CSV数据及写入表格。重点讲解解决Windows下换行异常的newline参数用法,以及处理引号、分隔符等CSV规范细节,帮助开发者高效处理结构化数据。
本文介绍如何使用Python Pandas库筛选或删除数据框中指定列包含特定值的行。通过isin()函数结合逻辑取反符号~,可以精准提取包含或排除特定数值(如货币代号1)的数据,并演示了多列组合条件下的行删除操作,适用于常见数据清洗场景。