

Pandas数据筛选进阶:高效使用 df.query() 方法
Pandas 提供的 df.query() 方法是一种基于字符串表达式的优雅数据筛选工具。相比传统布尔索引,它能自动解析列名、完整支持数学与逻辑运算符,并可借助 @ 符号灵活调用外部变量。本文详细演示了该方法的配置流程、多条件组合、跨列计算技巧及使用边界。
2026-10-12
6

Pandas 提供的 df.query() 方法是一种基于字符串表达式的优雅数据筛选工具。相比传统布尔索引,它能自动解析列名、完整支持数学与逻辑运算符,并可借助 @ 符号灵活调用外部变量。本文详细演示了该方法的配置流程、多条件组合、跨列计算技巧及使用边界。
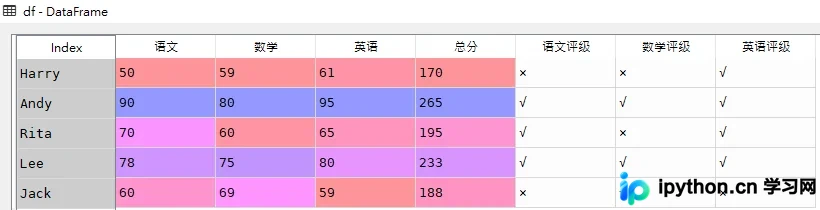
在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。
NumPy 作为 Python 数据分析的基石,其核心数据结构 ndarray 封装了大量元数据属性,便于快速掌握数组的维度、内存布局与类型特征。本文将系统演示 ndarray.ndim、shape、size、dtype、itemsize、flags 等核心属性的实际调用方式,结合完整代码与运行结果输出,帮助开发者在数据处理与模型调试中高效进行结构分析与内存评估。
本文演示如何利用 Python 的 Pandas 库快速对 Excel 数据表中的手机号进行中间四位隐藏处理。通过指定读取类型并运用字符串切片技术,可一行代码完成批量脱敏,兼顾执行效率与数据隐私安全,适用于跨系统对接前的合规数据清洗。
本文详细介绍使用 Python 的 pandas 库进行 CSV 与 Excel 文件的读取及保存方法,系统讲解空值筛选、行列删除、索引重置与缺失统计等核心清洗操作。通过明确关键参数设置与标准化代码示例,协助开发者高效完成数据预处理与质量校验流程,确保分析基础稳定可靠。
本文详解Python中Lambda匿名函数的语法结构,演示其与内置函数filter、map及Pandas库apply方法的结合使用技巧。通过实际代码对比过滤、映射与批量处理数据的完整流程,并明确不建议将Lambda赋值给变量或包裹已有内置函数的场景,帮助开发者写出更简洁高效的代码。
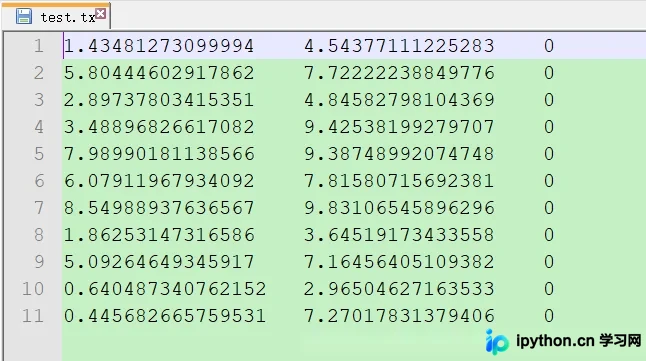
本文介绍在Python中加载数据文件的两种实用方法,分别使用内置open()函数和pandas库的read_csv()功能。通过实例演示如何读取特征和标签数据,比较结果一致性,适用于机器学习等数据密集型任务的预处理环节。
在数据分析流程中,按特定字段划分数据集并计算组内指标是高频需求。本文详解 pandas groupby 的底层对象结构,演示使用 agg 实现多列自定义聚合,并通过 transform 将分组统计值精准广播回原表,附带完整代码与对照输出。
本文详细解析Python中lambda匿名函数的定义语法、适用边界及其与def语句的差异,并系统说明apply函数的参数解包机制、现代替代方案以及Pandas DataFrame中的应用逻辑。通过标准代码示例与版本兼容性排查指引,帮助开发者快速掌握高阶函数调用与数据框映射技巧。
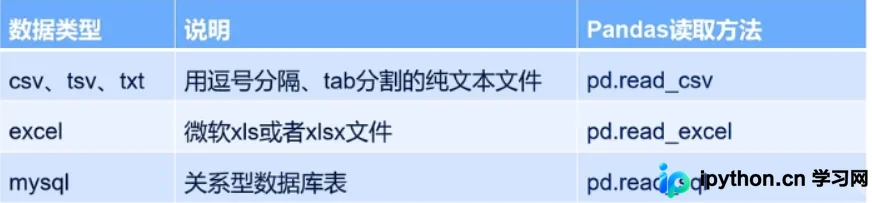
本文详解在 Python 数据分析中,如何使用 Pandas 库高效读取 CSV、TXT 文本文件、多 Sheet Excel 表格以及关系型数据库表。涵盖分隔符指定、列名自定义、数据库引擎配置等核心参数,提供可直接运行的代码示例,助您快速完成数据加载。
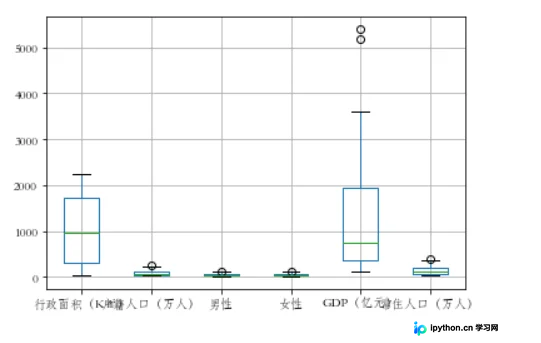
数据清洗是确保后续分析质量的关键环节,主要解决不完整、错误和重复三类问题。本案例演示如何利用 Python 的 pandas 库自动读取 CSV 文件,依次执行重复项过滤、空值均值填充、数值型字段箱线图异常检测,最后将两地表格安全合并。整套流程可快速复用于同类政务或业务数据预处理任务。
本文详细拆解使用Pandas批量合并多张Excel表格的标准流程,涵盖有序文件遍历与无序目录扫描两种代码实现。同步给出身份证号等超长数字截断乱码的精准修复方案,助力高效完成底层数据汇总。