Python数据分析实战:北京高考分数线(2006-2019)统计处理
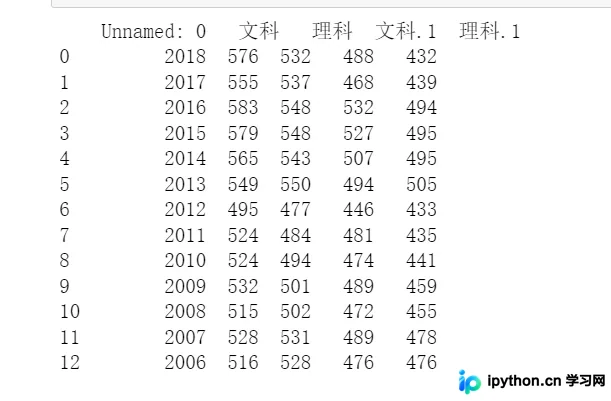
本文基于Python的Pandas库,对北京2006至2019年高考录取分数线进行统计分析。通过数据爬取与本地文件读取,利用groupby、max、min及mean等方法,计算文理科最高最低分、一本与二本分数线差值及历年平均分。结合Matplotlib进行可视化展示,为考生填报志愿提供数据支持。
2026-10-12
6

本文基于Python的Pandas库,对北京2006至2019年高考录取分数线进行统计分析。通过数据爬取与本地文件读取,利用groupby、max、min及mean等方法,计算文理科最高最低分、一本与二本分数线差值及历年平均分。结合Matplotlib进行可视化展示,为考生填报志愿提供数据支持。
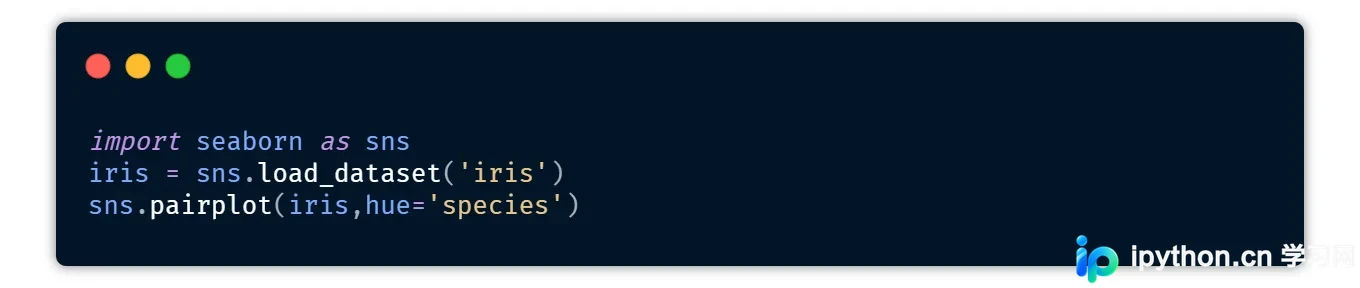
本文深入解析Python中7款主流数据可视化库,涵盖静态绘图、交互式仪表板及地理地图制作。重点介绍Seaborn的高级统计绘图、Plotly的Web部署能力、Bokeh的浏览器交互性以及Missingo的数据缺失分析功能,帮助开发者快速选择合适工具提升数据分析效率。
本文系统梳理了 Python Pandas 库中最常用的数据处理函数与方法,涵盖数据读写、统计展示、增删改及特殊操作四大类。通过提供详细的函数列表与可直接运行的代码示例,帮助开发者快速定位所需功能,解决记忆模糊或查找效率低的问题,提升数据处理效率。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
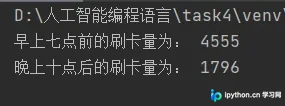
本文基于公交IC卡刷卡数据集,演示使用Python进行数据分析的完整流程。涵盖数据导入、时间格式转换、早晚高峰刷卡量统计、各小时刷卡趋势折线图绘制、乘客搭乘时间函数构建、交易类型占比饼图生成,以及线路、司机与车辆信息的分类存储与高频服务者分析。
本文详解pandas中NaN空值的判断方法,指出pd.isnull、pd.isna及np.isnan为正确方式,而直接使用==、bool或if语句会导致误判。文章通过示例对比is与==表达式的差异,并补充了查找、填充及删除空值的完整操作指南,帮助开发者避免常见陷阱。
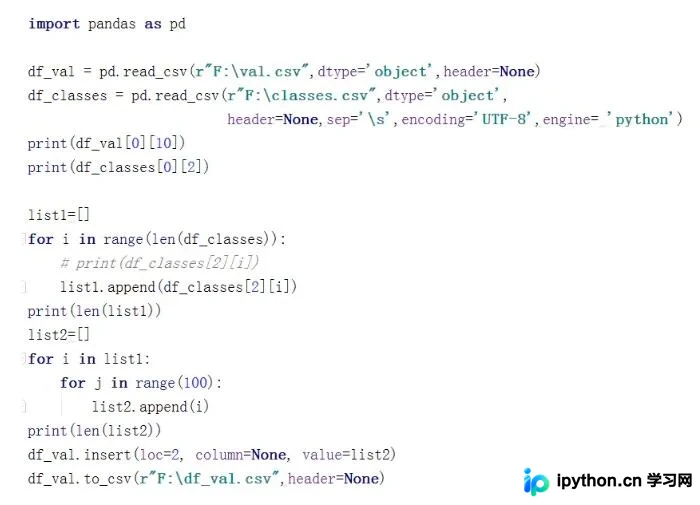
本文介绍在 pandas 中为 DataFrame 添加空列并赋空值的方法。通过 apply 函数或直接赋值实现,并解决多文件标签映射时的列扩展问题。
本文详解如何利用Python的os与pandas模块,自动化合并同一文件夹下多个Excel文件中同名Sheet的数据。通过遍历文件、读取数据、提取Sheet名并拼接内容,最终生成包含所有同名Sheet数据的新Excel文件,适用于日常办公数据整理场景。
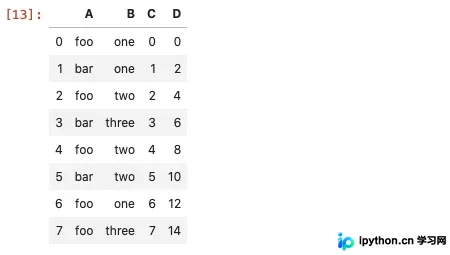
本文详解pandas中筛选指定列值对应行的多种方法。涵盖布尔索引、基于iloc的位置索引、基于loc的标签索引及高效的query API。通过具体代码示例,演示如何筛选等于标量、属于范围、多条件组合及排除特定值的行,帮助开发者高效处理数据子集。
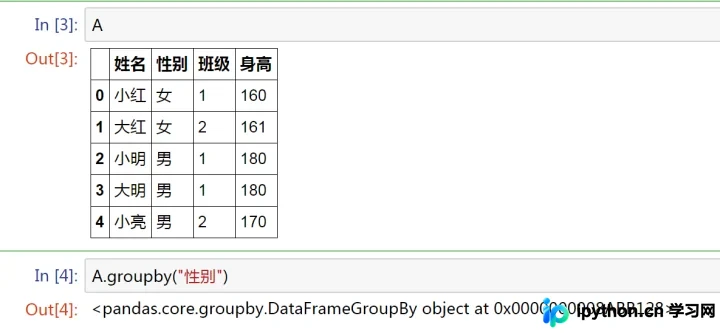
本文详解Python中pandas库的groupby函数,涵盖单类分组、多类分组及时间序列分组场景。通过describe、unstack、agg、first、filter等方法的组合使用,演示如何高效进行数据分组统计、多函数聚合运算及特定条件过滤,帮助开发者掌握数据清洗与分析的核心技巧。
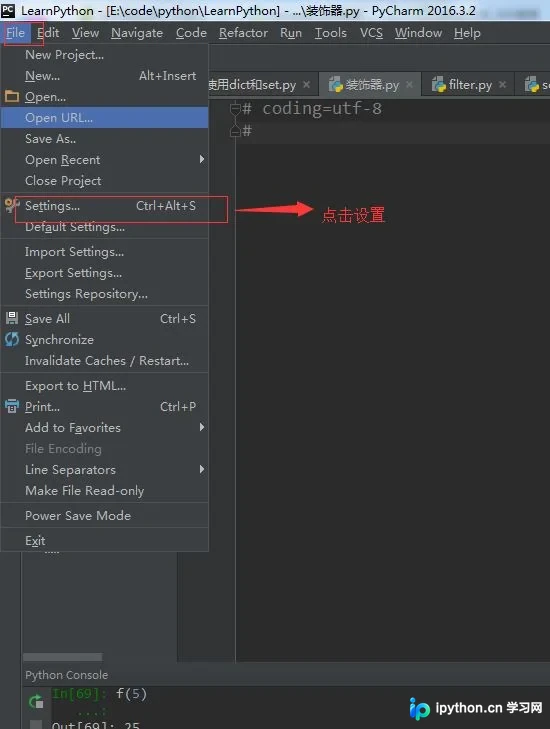
本文详细讲解如何在PyCharm中配置IPython 4.2.1交互环境,解决原生Python编码效率低的问题。通过安装指定版本IPython、修改控制台设置以及编写和绑定宏快捷键,实现多行代码快速执行,提升Python数据分析的开发体验。
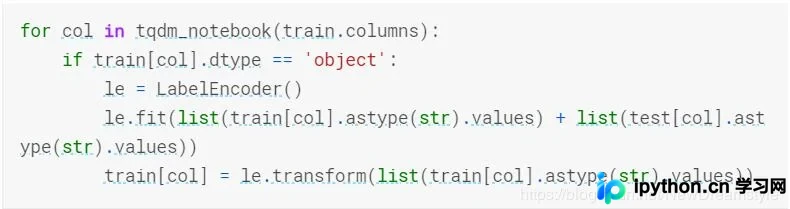
本文介绍在Python中使用pandas和sklearn将非数值数据转换为数值的方法。通过自定义函数处理类别列,并对比LabelEncoder的使用。文中指出直接操作DataFrame时的常见陷阱,如列顺序重置和字典映射逻辑,并提供基于LabelEncoder的更简洁实现方案,适用于机器学习前的数据预处理阶段。