

使用Python Pandas读取CSV并保存至MySQL数据库
本文详细介绍如何利用Python的Pandas库读取本地CSV文件,处理日期格式,并通过两种方法将数据保存至MySQL数据库。文章对比了直接使用MySQLdb库与使用SQLAlchemy结合to_sql方法的优劣,重点讲解了日期格式转换及字段类型匹配问题,帮助开发者高效完成数据入库操作。
2026-10-12
6

本文详细介绍如何利用Python的Pandas库读取本地CSV文件,处理日期格式,并通过两种方法将数据保存至MySQL数据库。文章对比了直接使用MySQLdb库与使用SQLAlchemy结合to_sql方法的优劣,重点讲解了日期格式转换及字段类型匹配问题,帮助开发者高效完成数据入库操作。
在数据处理中快速定位目标记录的具体位置是分析的前置步骤。本文介绍如何通过已知列名、未知列名及全表搜索三种场景,结合布尔索引与 .index 属性精准提取行号,并演示将标签索引转换为实际物理行号的完整代码流程,帮助开发者高效完成数据筛选与定位。
本文介绍如何使用 Python 的 Pandas 库,根据特定日期条件批量修改 DataFrame 中的数据。通过遍历行并判断日期字段,将符合条件的记录的 promotion 字段更新为 1,提供具体的代码示例和操作步骤。
面对包含多个工作表的Excel文件,手动拆分极易漏改且耗时。本文介绍使用Python与pandas库编写自动化脚本,按Sheet名称逐个读取并导出为独立文件的操作流程,附带核心参数说明与运行排错指南,适用于日常数据处理与办公提效。
Python 中的 len() 是用于获取对象元素数量的内置函数,以 O(1) 时间复杂度直接读取对象的长度属性。它广泛支持字符串、列表、元组、字典及集合等内置序列与映射类型,同时可被 NumPy 数组和 pandas DataFrame 等第三方数据结构继承。本文将详细解析其运行原理、适用边界,并结合输入校验、循环控制与数据切分等实际编码场景提供标准化代码示例,帮助开发者高效调用并避免类型错误。
针对业务数据表中存在的分类标签重复、维护标准不一及缺失值干扰等问题,本文基于Python与Pandas库构建自动化字段清洗方案。通过字符串规范化、正则过滤、哈希索引去重与分块读取等核心操作,配合异常处理机制与模糊匹配扩展,提供从环境配置、脚本编写到结果验证的完整实践路径,有效替代人工排查,提升数据结构化质量。
本文演示如何基于Python从零构建多尺度文本统计模型。通过非重叠窗口提取1至5字符片段,结合Pandas进行频次排序,并利用交叉减法消除长短片段的重复计数。该流程可为自定义分词器设计、文本压缩编码及NLP数据清洗提供可落地的工程参考。
本文详解Pandas在数据处理中的核心操作,涵盖缺失值(NaN)的检测与填充策略、基于多键的表关联合并(Merge)与纵向拼接(Concat),以及利用透视表进行多维统计。通过具体代码示例,展示如何高效完成数据清洗、多表关联及报表生成,解决日常数据分析中的常见痛点。
在pandas中处理DataFrame时,布尔索引是最常用的行过滤方式。本文系统梳理单列条件、多条件组合及字符串匹配的写法,结合电影数据集演示完整筛选流程,并提示运算优先级与缺失值处理的易错点,帮助快速准确提取目标数据。
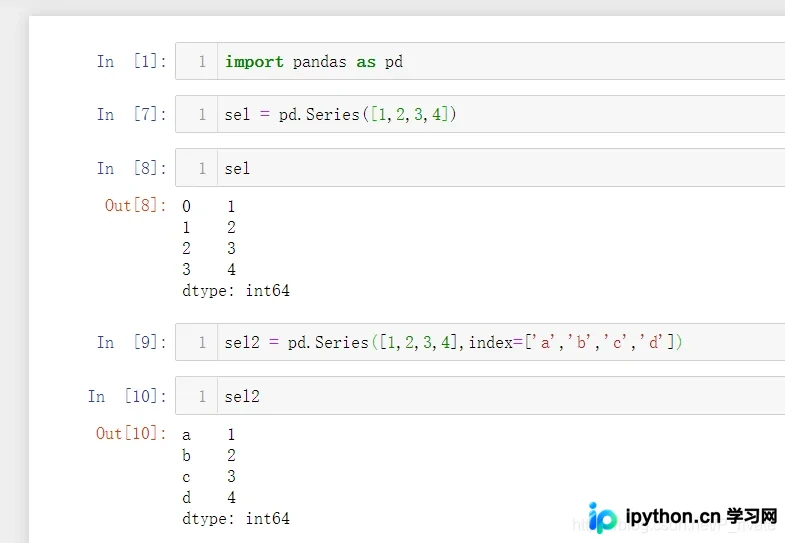
Pandas 的 Series 是用于存储一维序列的带标签数据结构,其底层由索引与值数组组成。本文通过可运行代码演示如何创建 Series、使用索引与切片访问元素、执行基础数学运算与标签对齐,并掌握 unique、value_counts 及 isin 等高效统计筛选方法,助您快速上手结构化数据的常规处理流程。
介绍在Python中如何利用pandas库和标准csv模块向CSV文件写入初始数据或安全追加新记录。涵盖核心参数配置、不同数据结构的转换方法、按行追加的正确姿势,以及追加列的通用逻辑,提供可直接运行的代码示例与注意事项。