

pandas清洗与合并北京天津地区数据的完整流程

数据清洗是确保后续分析质量的关键环节,主要解决不完整、错误和重复三类问题。本案例演示如何利用 Python 的 pandas 库自动读取 CSV 文件,依次执行重复项过滤、空值均值填充、数值型字段箱线图异常检测,最后将两地表格安全合并。整套流程可快速复用于同类政务或业务数据预处理任务。
基于Pandas的地区数据清洗与预处理流程
数据清洗的任务是过滤不符合要求的数据,将结果交由业务部门确认为丢弃还是修正后抽取。与问卷审核不同,录入后的数据清理通常由计算机自动完成,核心目标是处理缺失值、重复值与异常值。
第1步:导入数据并清除重复记录
目的:读取原始 CSV 文件,识别因人工录入或系统抓取产生的完全重复行,并为后续清理建立干净的基础表。
操作:使用 pandas.read_csv() 分别加载北京与天津数据,调用 duplicated() 生成布尔序列标记重复项。返回 True 的行即为冗余数据,确认后使用 drop_duplicates() 执行原位去重,查看去除后的行列数变化以验证完成状态。
# 读取北京地区的数据
import pandas as pd
with open("北京地区信息.csv") as f:
    file_data_bjinfo = pd.read_csv(f)
# 读取天津地区的数据
with open("天津地区信息.csv") as f:
    file_data_tjinfo = pd.read_csv(f)

# 检测file_data_bjinfo中的数据,返回True的表示是重复数据
dup_bj = file_data_bjinfo.duplicated()
print(dup_bj)

# 检测file_data_tjinfo中的数据,返回True的表示是重复数据
dup_tj = file_data_tjinfo.duplicated()
print(dup_tj)

# 对北京地区的数据,删除重复值
drop_dup_bj = file_data_bjinfo.drop_duplicates()
print(drop_dup_bj)
第2步:定位缺失值并使用均值填充
目的:检查目标表中是否存在空缺字段,优先采用统计学中最具代表性的集中趋势指标进行修复,避免直接删除整行导致样本结构失真。
操作:通过 pd.isnull() 输出缺失矩阵定位空白单元格。选取关键指标列计算算术平均数,使用格式化字符串严格保留两位小数并转为浮点类型,构建键值对字典传入 fillna() 完成列级映射填补,运行后原空缺位置将替换为计算出的均值。
# 检测天津地区的数据是否存在缺失值
print(pd.isnull(file_data_tjinfo))
# 计算天津地区常住人口的平均数,设置float类型,并保留两位小数
avg = float("{:.2f}".format(file_data_tjinfo['常住人口(万人)'].mean()))
# 以字典映射的方式进行填充
values = {'常住人口(万人)':avg}
file_data_tjinfo = file_data_tjinfo.fillna(value=values)
print(file_data_tjinfo)
第3步:异常值检测与箱线图展示
目的:识别数值型字段(如行政面积、GDP、人口等)中的极端偏离值。箱线图能直观呈现四分位数分布与离群点,便于业务人员核对是否属于真实极值或录入笔误。
入口与配置:初始化 matplotlib 全局字体与环境设置,解决图表中文乱码与负号显示异常问题。随后直接在 DataFrame 对象上调用 boxplot() 渲染图形。
# 对北京地区信息进行异常值检测。并且用箱型图进行表示
from matplotlib import pyplot as plt

plt.rcParams['font.family']=['STFangsong']  # 用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False # 用来正常显示负号
file_data_bjinfo.boxplot()
plt.show()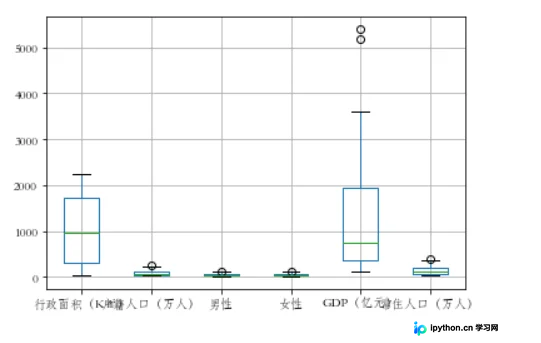
# 对天津地区信息进行异常值检测。并且用箱型图进行表示
file_data_tjinfo.boxplot()
plt.show()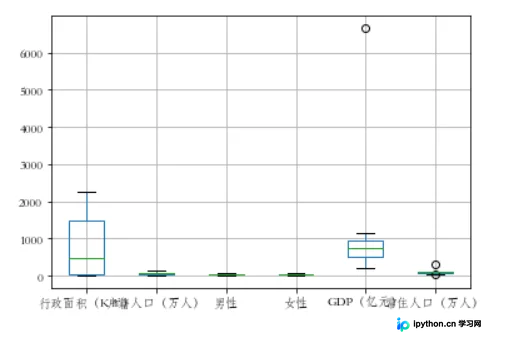
第4步:多区域数据集合并
目的:将清洗完毕的独立城市数据表整合为统一宽表,便于跨地域对比分析或报表汇总。
操作:调用 pd.concat() 沿行方向拼接。设置 join='inner' 仅保留共有的列名交集,axis=0 指定纵向堆叠数据,ignore_index=True 重置行索引以消除旧表累积的编号。执行后将输出一张包含两地所有已清洗记录的连续 DataFrame。
# 对两地数据进行合并
print(pd.concat([file_data_bjinfo,file_data_tjinfo],join='inner',axis=0,ignore_index=True))
以上就是利用pandas进行地区数据清洗与合并的详细内容,更多关于Python数据处理与数据分析的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









