

Python数据分析实战:北京高考分数线(2006-2019)统计处理

本文基于Python的Pandas库,对北京2006至2019年高考录取分数线进行统计分析。通过数据爬取与本地文件读取,利用groupby、max、min及mean等方法,计算文理科最高最低分、一本与二本分数线差值及历年平均分。结合Matplotlib进行可视化展示,为考生填报志愿提供数据支持。
前言:
为协助考生及家长掌握历年高考录取动态,众多平台汇总了各省市的录取控制分数线,作为志愿填报的重要参考。受多种因素制约,历年分数线存在波动。本文采集了北京地区2006年至2019年的相关数据,并运用Python的Pandas库完成后续的数据分析工作。
1.1 数据爬取
本部分主要阐述数据来源、获取方式以及最终获取的数据结果。
代码:
import pandas as pd

import numpy as np

data=pd.read_excel("scores.xlsx",header=1)

print(data)
运行结果:
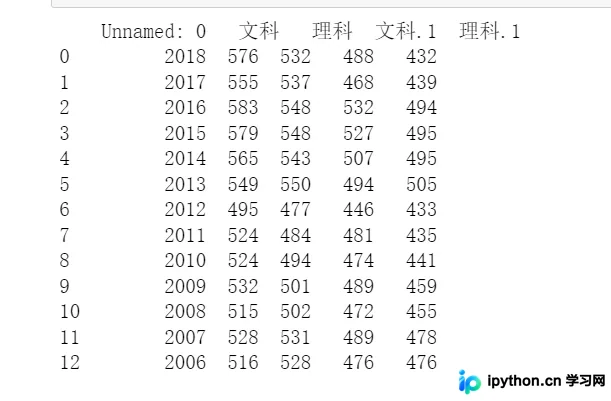
分析:本次分析直接读取了本地保存的数据文件。
读者也可选择从相关网站下载数据,或自行编写爬虫程序获取数据源,进而开展数据分析工作。
在数据处理环节,主要采用了Pandas numpy进行数据预处理。
随后使用matplotlib完成数据的可视化展示。
1.2 最高分最低分统计
mindata= data.groupby(['文科','理科'], as_index=False).min(axis=1)

maxdata= data.groupby(['文科','理科'], as_index=False).max(axis=2)

print(data.min())

print(data.max())
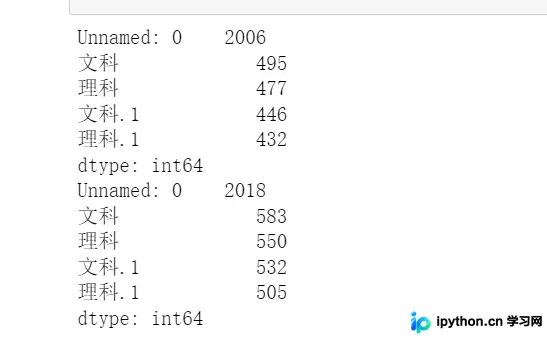
对数据进行清洗处理,统计最高分与最低分。由于数据涵盖不同年份,且区分文科与理科,因此涉及两组文科数据和两组理科数据的计算。
- 我们利用
groupby按文理科类别进行分组。 - 接着使用
max()和min()分别计算最大值和最小值。 - 经过上述分析与处理,可以得到打印输出的最大值和最小值结果。
1.3 一本二本理科差值统计
代码:
s1math=data["一本分数线","理科"]
print(s1math)
print(s1math[0]-s1math[2])

s1c=data["一本分数线","文科"]
print(s1c[0]-s1c[2])
s2math=data["二本分数线","理科"]
print(s2math[0]-s2math[2])
s2c=data["二本分数线","文科"]
print(s2math[0]-s2math[2])
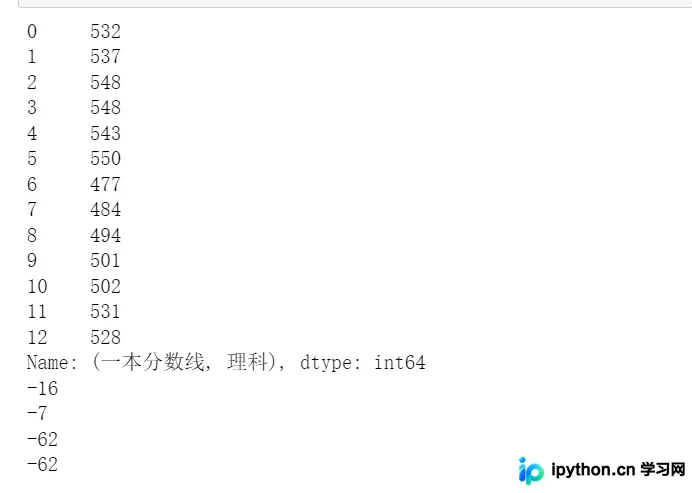
运行结果:
注意:
首先提取对应的文理科一本及二本成绩数据,随后计算极差,即使用前一个数值减去后一个数值即可。
print(s1math[0]-s1math[2])
1.4 2006—2019年近14年每科分数线的平均值统计
代码:
# 2006—2019年近14年每科分数线的平均值统计

data1=data[data['Unnamed: 0'].between(2006, 2014, inclusive=True)].groupby(['Unnamed: 0']).mean()

print(data1)
运行结果:
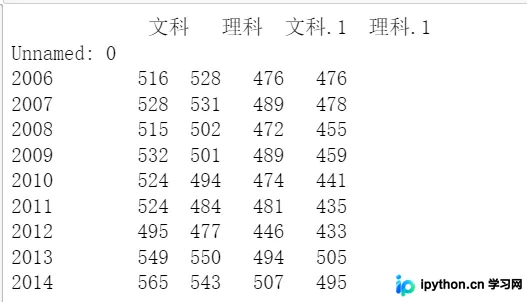
首先提取数据,然后计算平均值。由于此处是一个年份对应一个成绩,并非一对多关系,因此下文介绍的方法更为简便。
也可以采用mean方法来进行平均值的计算。
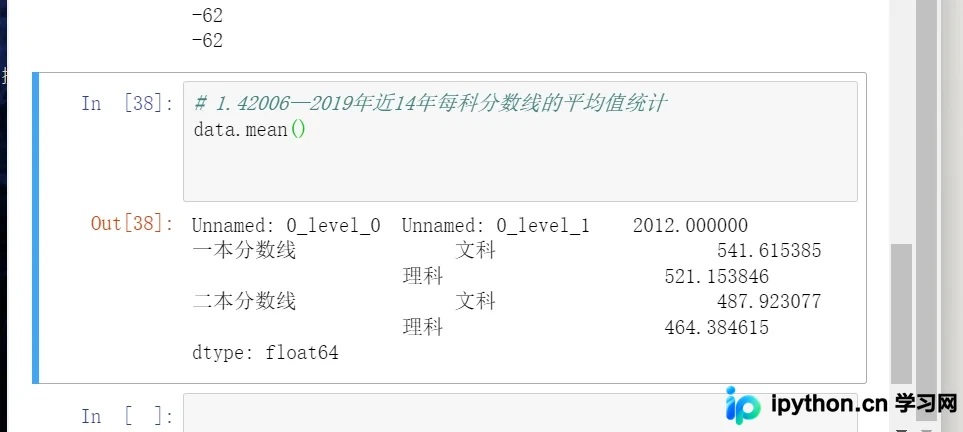
鉴于是一个成绩对应一个年份,非一对多关系,故下文方法更为高效。
同样可以使用mean方法进行平均值的求解。
至此,关于Python数据分析与处理北京高考分数线统计分析的文章介绍完毕。如需了解更多Python数据分析与处理相关内容,请搜索本站往期文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









