

Python实现邮件自动下载与附件解析实战
本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
2026-10-12
6

本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
本文详解pandas中处理重复数据的两个核心方法:duplicated()与drop_duplicates()。通过DataFrame、Series及Index三种对象的示例,解析subset与keep参数的具体行为,并演示如何根据品牌或全部列识别重复项,以及如何直接删除重复数据以完成数据清洗。
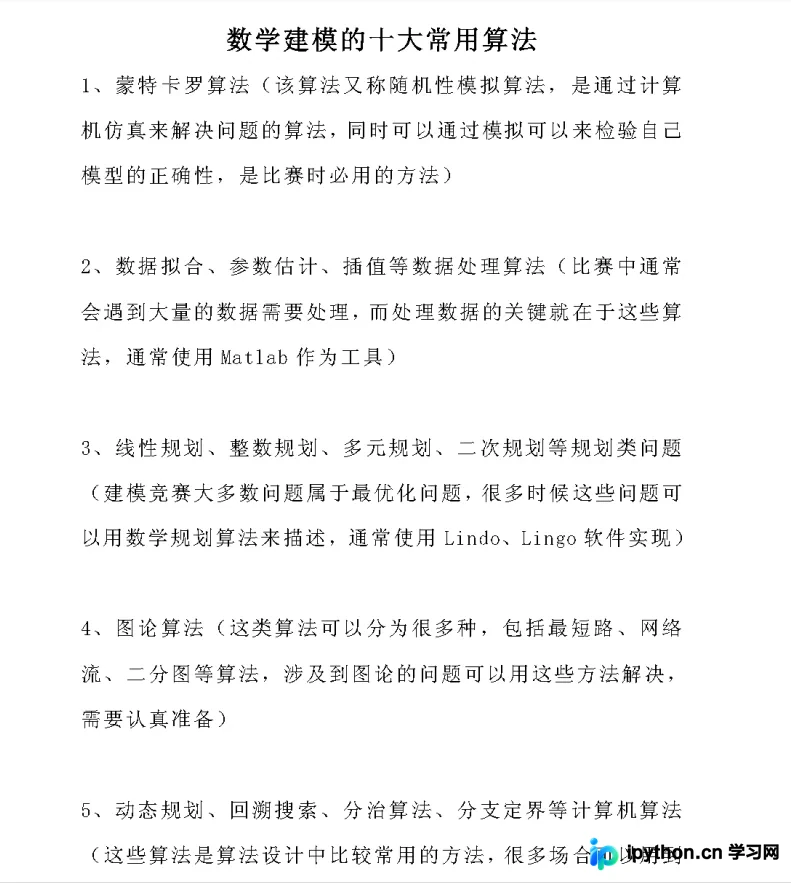
本文系统梳理Python数学建模核心知识,详解预测、优化、评价三大模型及十大常用算法。结合Pandas库实战,演示CSV/Excel读取、Series与DataFrame数据结构操作,涵盖单值、批量、区间及条件查询技巧,并解决数据类型转换等常见报错,助力掌握建模与数据处理全流程。
本文介绍如何利用Python的pandas库读取CSV文件数据,并结合matplotlib进行基础绘图。重点演示使用seaborn库绘制Pearson相关系数热力图,详细解析data.corr()计算相关性、sns.heatmap()绘制图表及annot参数控制数值显示的方法,同时说明对空值np.nan的支持情况。
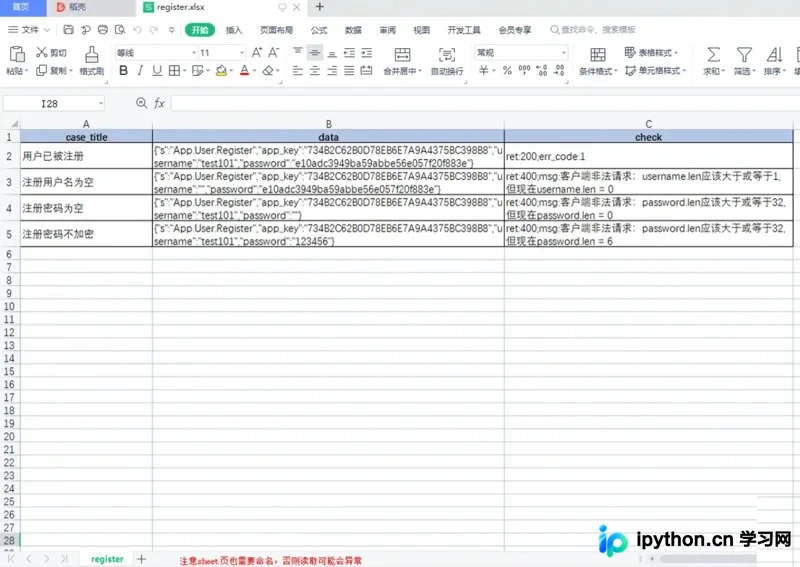
本文总结Python接口自动化测试中三种主流用例数据读取方法:xlrd、pandas和yaml。通过注册接口示例,详细解析各库的代码实现与优缺点。xlrd适合小规模数据,pandas擅长处理大型表格,而yaml凭借高可读性和模块隔离性成为复杂场景优选。文章提供完整代码片段及注意事项,帮助测试人员根据项目规模选择最佳方案。
本文深入解析pandas中pd.concat()函数的核心用法,详细讲解objs、axis、join等关键参数的含义与区别。通过上下堆叠与左右拼接两个实战案例,展示如何灵活处理Dataframe和Series的合并操作,帮助开发者掌握高效的数据合并技巧。
本文详解pandas读取Excel时的常见陷阱,重点解析converters参数用于强制类型转换(如学号转字符串)以解决空值问题,以及usecols参数的三种用法:列表指定列名、numpy切片区间及字母范围切片。强调sheet_name需显式指定,提供完整代码示例与注意事项。
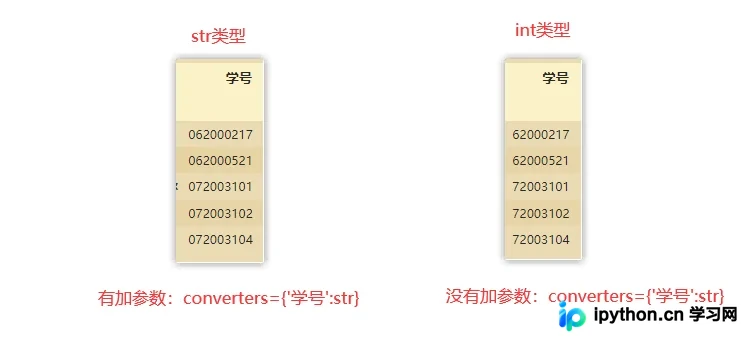
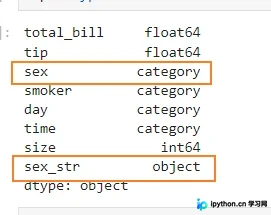
本文深入解析Pandas中数据类型的转换方法。重点介绍使用astype进行基础类型转换,以及处理含缺失值数据时to_numeric函数的errors和downcast参数应用。同时讲解Categorical分类数据的创建、排序及CategoricalDtype自定义顺序排序的高级技巧,帮助开发者高效处理数据清洗与类型优化问题。
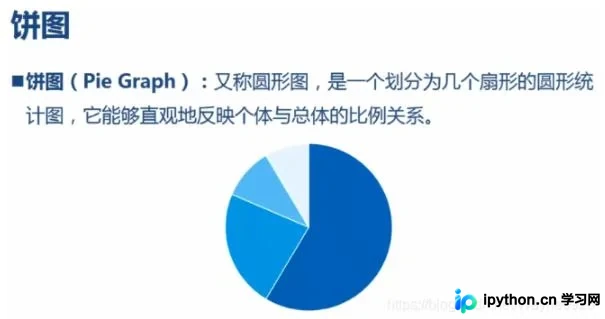
本文详细展示了如何使用Python的Matplotlib库绘制饼图和直方图。通过读取CSV数据,利用Pandas进行分组统计,并配置字体、颜色及参数,分别生成了展示品牌分布的饼图和展示用户购买数量的直方图(含累计效果)。代码包含完整的数据处理与绘图逻辑,适合数据分析入门参考。
本文详解Python Pandas中缺失值NaN的处理方法。涵盖使用isnull()检测空值,通过dropna()按条件删除含缺失值的行或列,以及利用fillna()进行统一值、字典映射、统计量或前后向填充。包含具体代码示例与参数说明,帮助高效清洗数据。
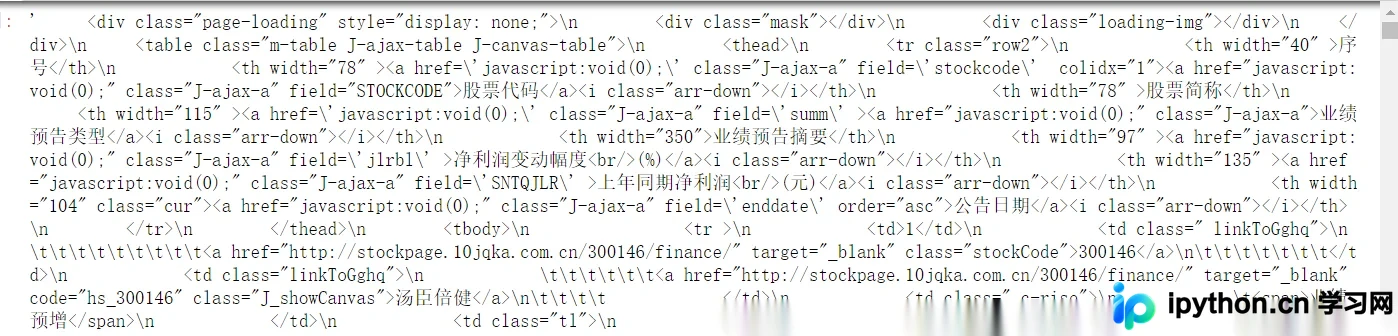
本文详解利用Python从同花顺财经抓取业绩预告数据的全过程。通过requests获取HTML源码,结合正则表达式提取股票代码、净利润及增长幅度,构建DataFrame进行数据清洗。最后使用Matplotlib绘制饼图,直观展示148家公司的盈利与亏损分布情况,为财务数据分析提供可视化参考。
本文系统介绍Python中Numpy库的核心功能,涵盖数组基础属性查询、多维数组创建与数学运算、axis轴参数理解以及线性代数计算。通过具体代码示例,解析如何高效处理数据初始化、矩阵变换及方程求解,为数据分析提供基础工具支持。