

Python使用re库进行字符串匹配详解
本文介绍如何利用Python的re库进行简单的字符串匹配。通过构建正则表达式模式并编译为对象,调用其方法即可获取匹配结果。文章结合具体代码示例,展示了从导入模块到打印匹配内容的完整流程,适合数据分析与算法工作者参考。
2026-10-13
6

本文介绍如何利用Python的re库进行简单的字符串匹配。通过构建正则表达式模式并编译为对象,调用其方法即可获取匹配结果。文章结合具体代码示例,展示了从导入模块到打印匹配内容的完整流程,适合数据分析与算法工作者参考。
本文详细解析 Python 中 Pandas DataFrame 的核心操作。涵盖从字典和多维数组创建 DataFrame 的方法,重点讲解列与行的索引技巧,特别是 iloc 与 loc 的区别及赋值警告处理。同时演示如何新增多列数据及删除指定的行与列,提供实用的代码示例与避坑指南。
本文介绍在Python pandas中如何排除DataFrame中的特定行。虽然pandas提供了[[wp:a0]]方法用于筛选包含特定值的行,但缺乏直接排除的API。文章通过示例演示了将列值转为列表、移除不需要的元素后再次使用[[wp:a5]]来实现反向筛选的技巧,帮助开发者解决复杂的数据过滤需求。
本文详细介绍在 Python 中使用 Pandas 库对 DataFrame 进行行与列求和,并将结果作为新列或新行添加至数据框末尾的具体操作方法。通过导入模块、生成随机数据及应用 apply 函数,实现数据的汇总与扩展,为数据分析提供基础支持。
本文介绍在 Python 3.6 和 Windows 64位环境下,利用 pymysql 建立数据库连接并配置字符集,结合 pandas 模块执行 SQL 查询语句以读取 MySQL 数据库表数据的具体实现方法。
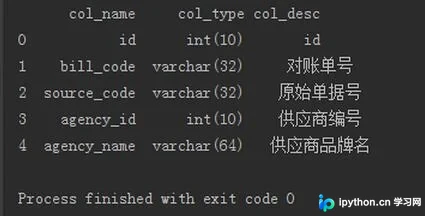
本文深入讲解Python Pandas库在数据清洗中的核心操作。涵盖merge函数的多种连接方式(inner, outer, left, right)及列名指定;介绍combine_first处理重叠数据的方法;详解数据重塑与轴向旋转;演示删除重复行、替换值及分段统计(cut/qcut);最后解析随机排列与采样技巧,助力高效数据预处理。
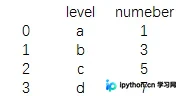
本文详细介绍Python中Pandas库的核心功能,涵盖Series一维数据与DataFrame二维表格的创建与操作。内容包含安装导入、数据选择切片、缺失值处理、统计函数应用、数据合并及时间序列重采样等关键操作,帮助开发者快速掌握科学计算基础。
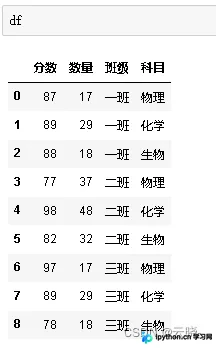
本文详解Python Pandas中数据分组统计、聚合运算及透视表的实现方法。涵盖groupby的分割、应用与组合流程,演示单列与多列分组统计、缺失值填充技巧。深入解析agg函数的标准与自定义聚合,以及pivot_table和crosstab在数据透视与频率统计中的应用,提供完整代码示例。
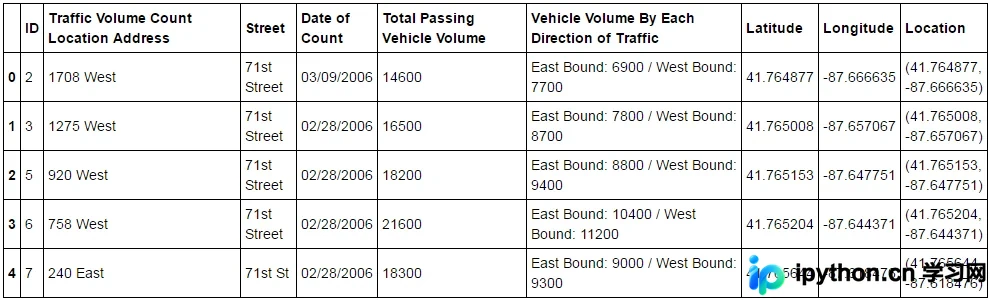
本文详解在Python中利用Pandas、Numpy和Sklearn库实现数据随机打乱、抽样及分割的方法。通过plotly内置数据集演示,涵盖DataFrame的sample函数按行/列抽样、sklearn.utils.shuffle与random模块打乱索引、np.random.permutation生成随机索引,以及train_test_split进行80/20数据划分的具体代码与参数设置。
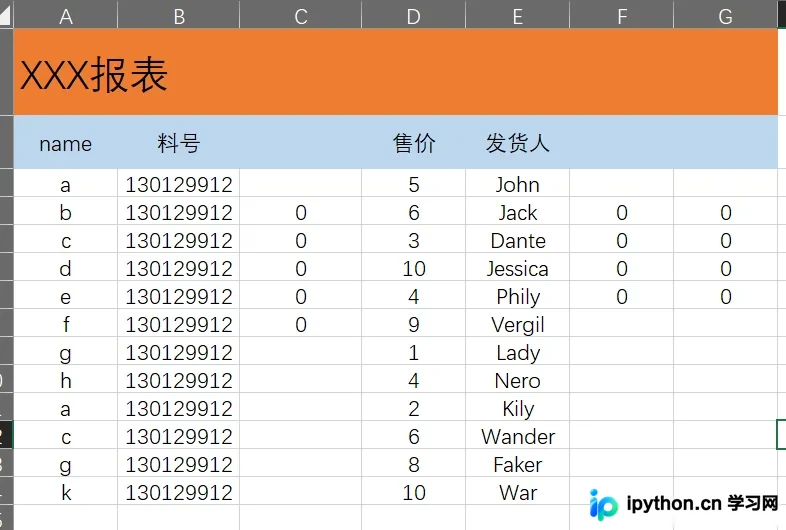
本文介绍使用Python pandas库处理包含重复行和空列的Excel文件。通过设置header=None读取数据,利用notna()生成布尔列表,并对比三种获取False索引的方法:list.index()配合count、遍历判断及enumerate。最终演示如何删除空列、提取首行作为新列名并保存结果,解决数据清洗中的常见难题。
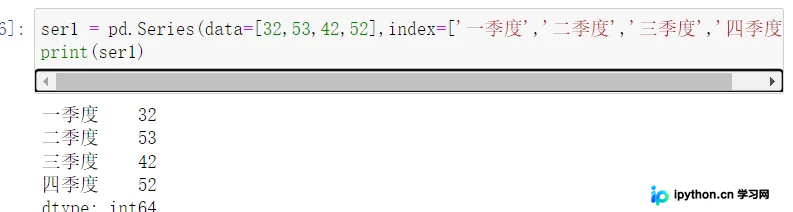
本文详细介绍 Pandas 中 Series 数据结构的创建、索引机制及常用操作方法。涵盖通过列表和字典构建 Series,掌握位置索引与标签索引的区别,演示花式索引与布尔索引技巧。同时深入解析 describe、value_counts、去重、空值处理(dropna/fillna)及排序取 Top-N 等核心函数的使用,帮助开发者高效处理一维数据。
本文介绍Python处理包含非法双引号的JSON字符串时的报错问题,提供通过正则替换转义特殊字符的解决方案。同时详解json.dumps与json.loads的正确用法,避免单双引号混用导致的解析错误,适用于数据清洗与跨系统数据传输场景。