
Python中使用BeautifulSoup进行HTML解析与节点操作
本文介绍Python中BeautifulSoup库的基本用法。内容涵盖模块导入、HTML文档解析,以及如何通过find和find_all方法查找特定标签(如a、p等)。同时演示如何获取标签名称、文本内容及属性值,并利用正则表达式和CSS选择器进行高级筛选,最后展示修改和删除节点属性的实际操作。
2026-10-13
6


本文介绍Python中BeautifulSoup库的基本用法。内容涵盖模块导入、HTML文档解析,以及如何通过find和find_all方法查找特定标签(如a、p等)。同时演示如何获取标签名称、文本内容及属性值,并利用正则表达式和CSS选择器进行高级筛选,最后展示修改和删除节点属性的实际操作。
本文演示如何使用Python的urllib库获取基金网站网页内容,并利用BeautifulSoup库解析HTML结构。通过具体代码示例,展示如何读取网页源码、处理编码问题,并提取基金编码、名称及净值等关键信息,供Python开发者参考学习。
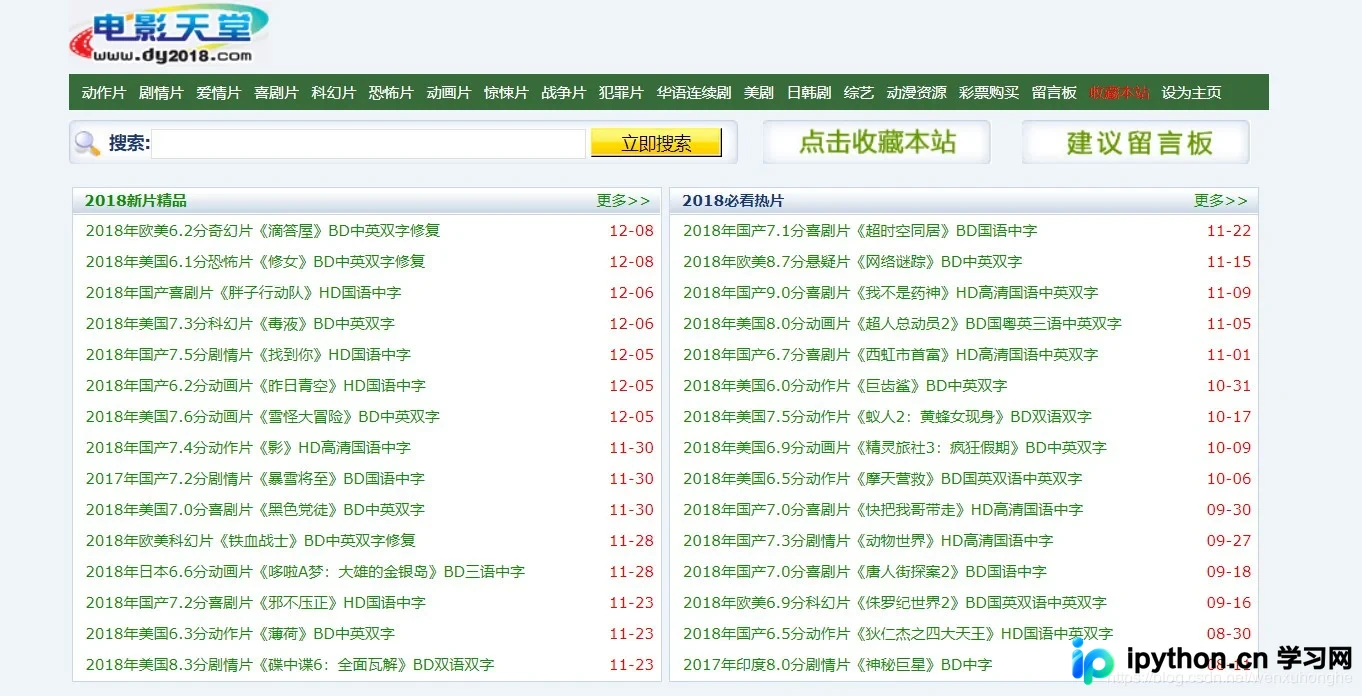
本文详细解析使用Python爬取《电影天堂》动作片板块的全过程。从URL结构分析、页面HTML解析到数据存储,逐步讲解如何构建爬虫程序。重点介绍利用BeautifulSoup提取电影名称与磁力链接,并通过优化代码仅保留magnet协议链接。此外,分享了结合pyperclip与迅雷实现批量下载的技巧,帮助读者掌握基础爬虫原理及实用数据处理方法。
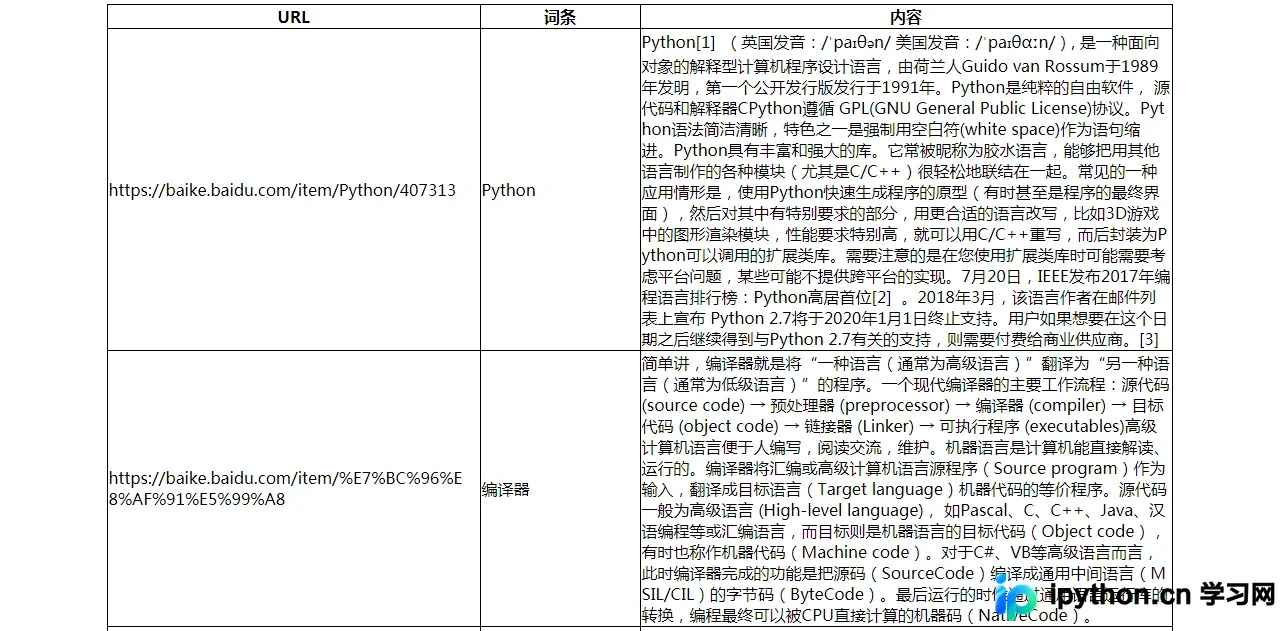
本文详细介绍如何使用Python编写一个完整的网页爬虫程序,重点解析URL管理器、网页下载器、网页解析器和输出处理器四大核心组件的实现逻辑。通过具体代码示例,演示如何从百度百科抓取词条数据,包括链接提取、HTML解析及结果存储,适合Python初学者理解爬虫工作原理。
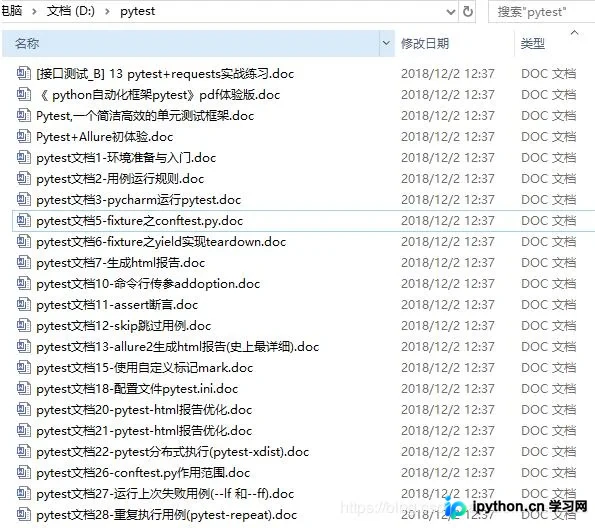
本文介绍使用Python脚本从搜狗微信搜索抓取特定公众号文章的方法。通过requests获取列表页,利用bs4解析标题与链接,并结合自定义HTML解析器将文章内容、代码块及图片提取并保存为Word文档。示例以“从零开始学自动化测试”公众号的pytest系列文档为例,展示了完整的下载与转换流程。
本文介绍如何在Python中从HTML的div标签中提取纯文本。通过结合使用re.compile编译正则表达式与re.sub进行替换,配合BeautifulSoup解析HTML结构,可有效去除标签符号。文中详细解析了正则编译标志及原生字符串的使用,并提供了完整的抓取与保存示例代码。
本文详细介绍Python中BeautifulSoup库的安装方法及基础使用。通过PyCharm自动安装bs4库,并演示如何将HTML源码转换为BeautifulSoup对象。文章解析了HTML标签的层级结构,讲解如何提取title等节点信息,并对比多种属性访问方式,帮助初学者快速掌握网页数据抓取的核心技巧。
本文介绍在Python3中如何利用urllib请求网页数据,并结合BeautifulSoup库解析HTML内容。通过具体代码示例,演示如何获取标题、类名、ID等属性值,以及使用select方法按标签、类名或ID进行精准查找,为网页数据抓取提供实用参考。
本文分享一段Python爬取链家租房信息的完整代码,涵盖从网页请求、数据解析到数据库存储的全流程。通过封装获取列表页链接与详情页信息的函数,结合SQL Server数据库操作,实现自动化数据采集。代码包含关键逻辑说明及错误处理思路,适合Python初学者参考学习。
本文详细介绍如何使用Python3结合Requests和BeautifulSoup模块爬取赶集网列表数据。文章涵盖环境配置、模块安装及核心代码实现,通过构造请求头模拟浏览器访问,解析HTML并提取标题信息,帮助开发者快速掌握基础爬虫技巧。
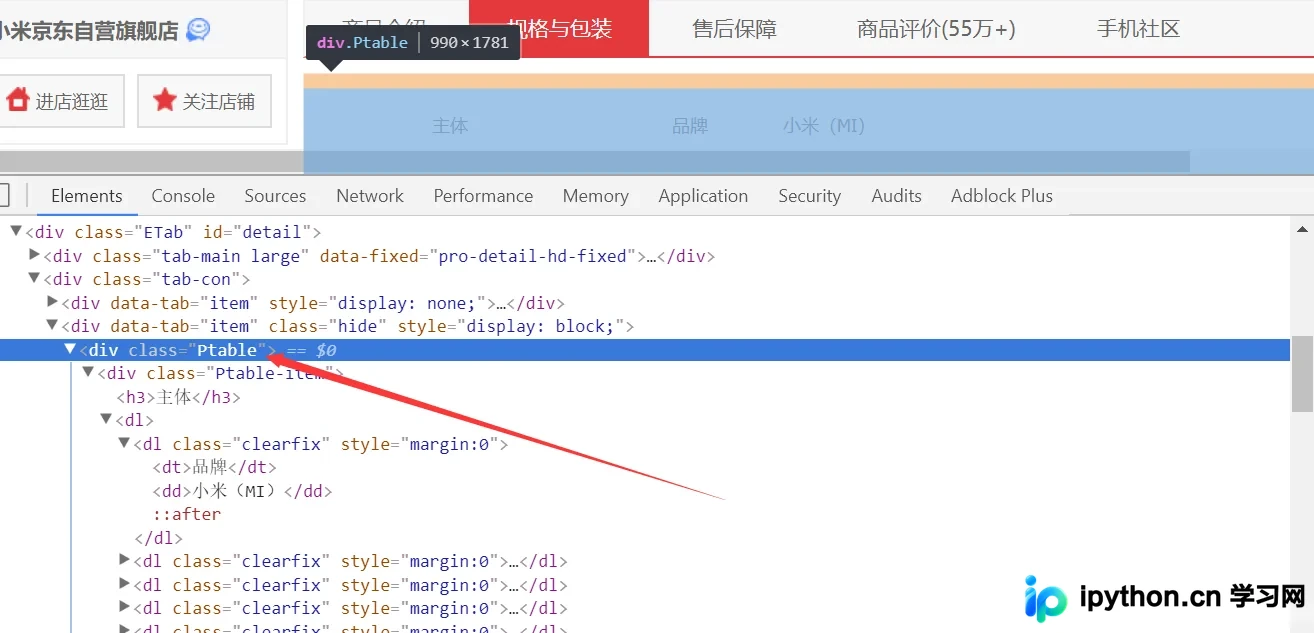
本文演示如何使用Python的requests库获取京东商品页面源码,并结合BeautifulSoup解析HTML结构。通过定位特定class的div容器,提取dl、dt和dd标签中的键值对数据,最终使用pandas构建DataFrame存储商品参数信息。
本文详细介绍Python中BeautifulSoup库的基础使用方法。内容涵盖库的安装命令、HTML文档的引入方式,以及利用find、select等API提取标题、属性、文本及特定标签的实操技巧,帮助开发者快速掌握HTML数据解析核心技能。