SQL 子查询如何优化亿级数据查询
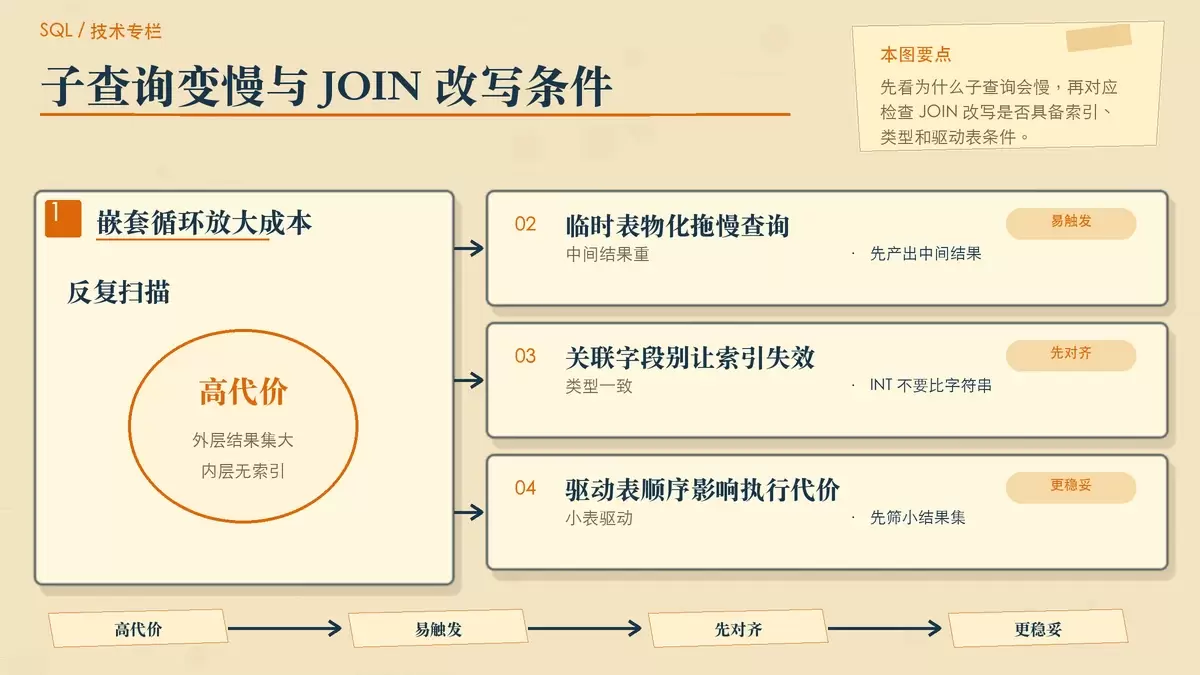
在亿级数据表上,子查询慢往往不是语法本身的问题,而是嵌套循环、临时表物化和索引缺失叠加造成的。本文围绕何时把 IN/EXISTS 改写为 JOIN、索引该补在哪些位置,以及深度分页场景该如何拆解,整理出一套更适合线上排查的判断方法。
2026-08-25
62

在亿级数据表上,子查询慢往往不是语法本身的问题,而是嵌套循环、临时表物化和索引缺失叠加造成的。本文围绕何时把 IN/EXISTS 改写为 JOIN、索引该补在哪些位置,以及深度分页场景该如何拆解,整理出一套更适合线上排查的判断方法。
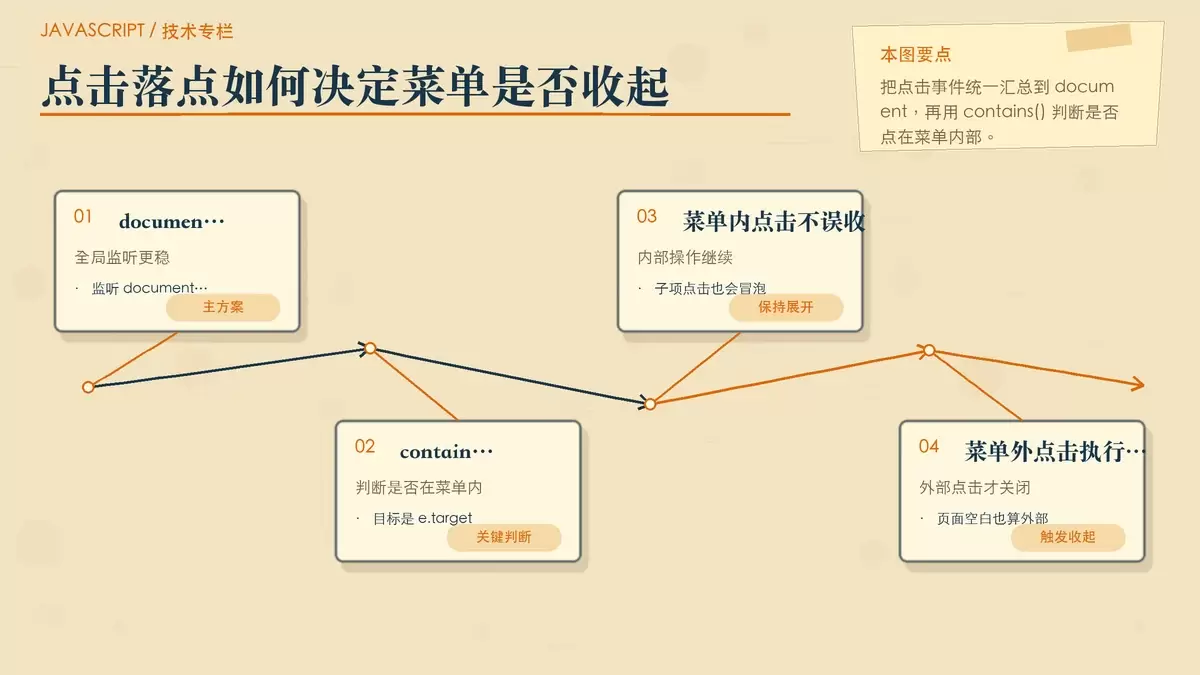
级联菜单的自动收起,关键不在给每个子项单独绑事件,而在于把“点击外部关闭”和“菜单内部继续操作”区分清楚。本文用 document 监听、contains 判断、stopPropagation 取舍,以及 focusout 配合 relatedTarget,整理出一套更稳的实现思路。
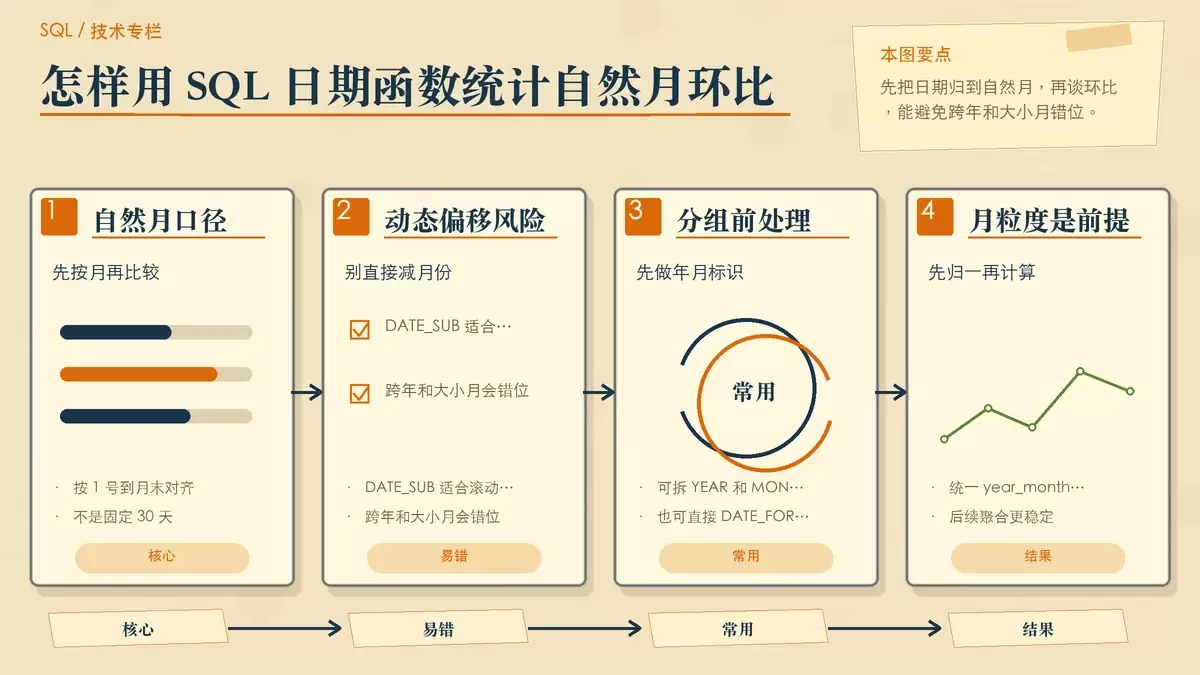
统计自然月环比,难点不在公式本身,而在“按日历月对齐”和“上月值如何准确关联”。本文按 MySQL 8.0+ 与 5.7 及以下两种场景,整理可直接套用的 SQL 写法,并补出时区、空值、除零和时间口径这些最容易让结果失真的细节。
SQL Server 2022/2024 中,存储过程执行计划优化的重点不在改写语法,而在于让既有过程正确触发新机制。排查时应先看统计信息,再分别确认 tempdb 并发更新、参数敏感计划(PSP)、RECOMPILE 使用边界,以及查询存储中的优化重播是否真正带来编译收益。
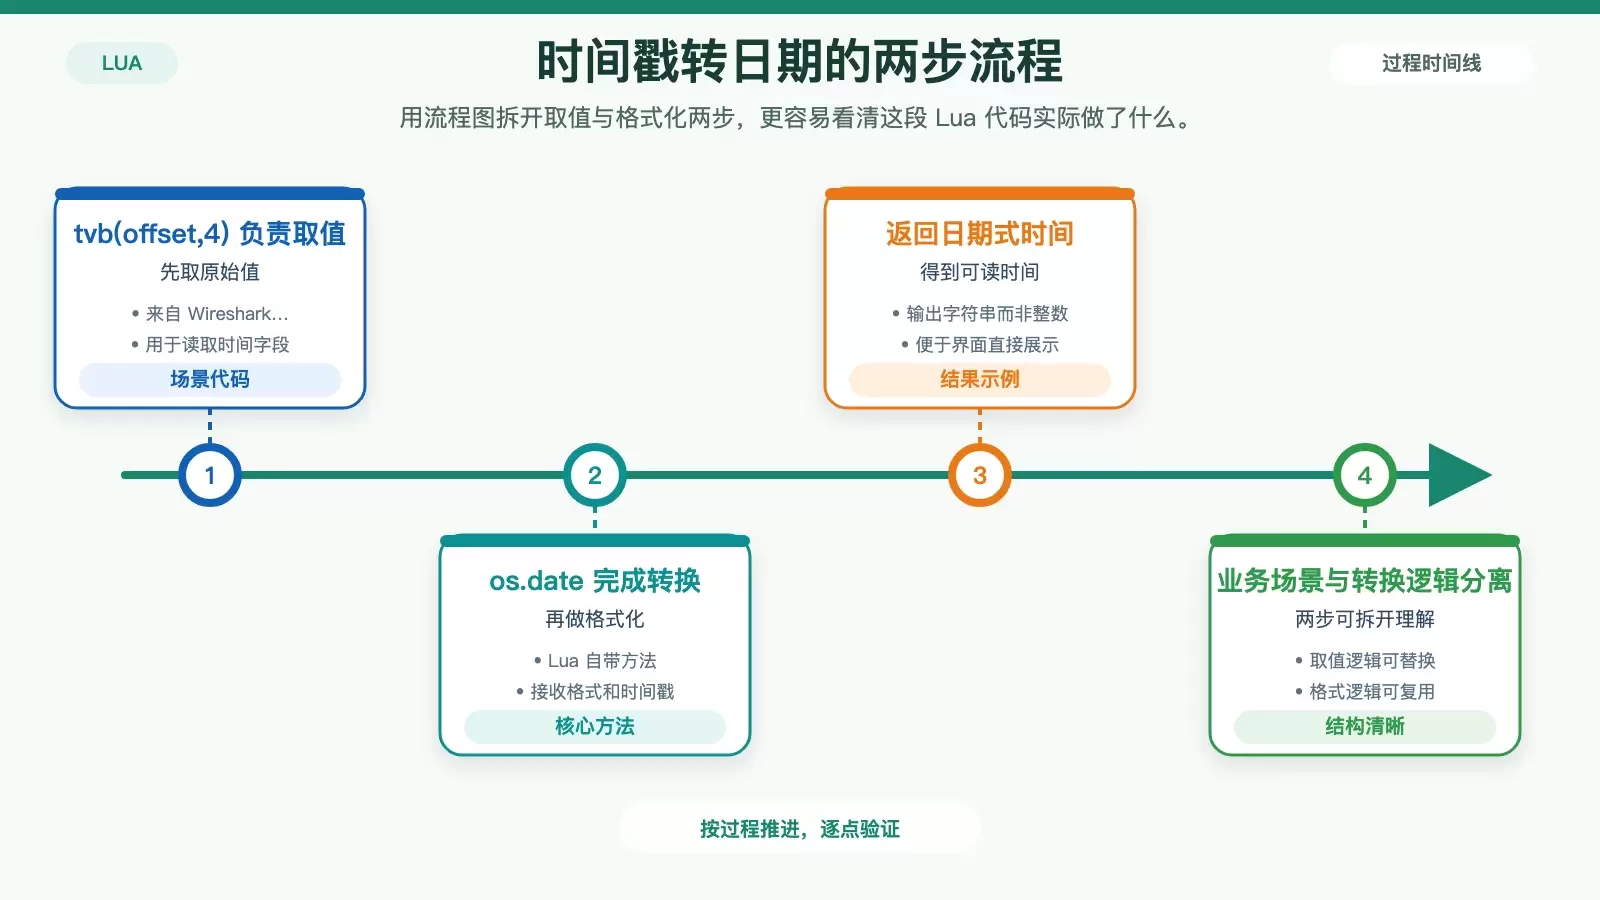
在 Lua 里把时间戳转成可读日期,核心就是 `os.date(format, stampTime)`。本文结合 Wireshark Lua 插件里的实际需求,说明如何用一行代码完成转换,并整理常见格式符的用途与选型,便于直接改成你自己的输出格式。 在 Lua 脚本里,时间戳通常是最原始也最难直接阅读的数据形态。
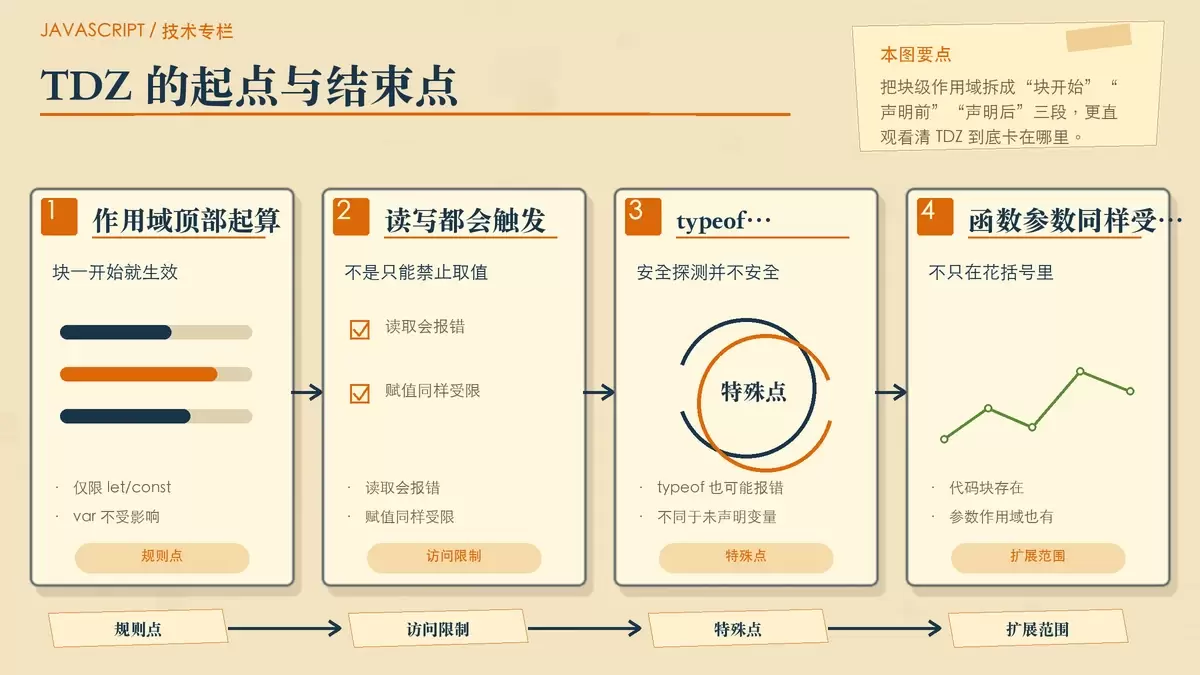
在 JavaScript 里,`let` 和 `const` 并不是“声明了就能先访问”。块级作用域从开始到声明执行前,会进入暂时性死区(TDZ),这会直接影响取值、赋值甚至 `typeof`。理解它的触发范围、典型报错和排查方式,能更稳地写出不依赖变量提升的代码。
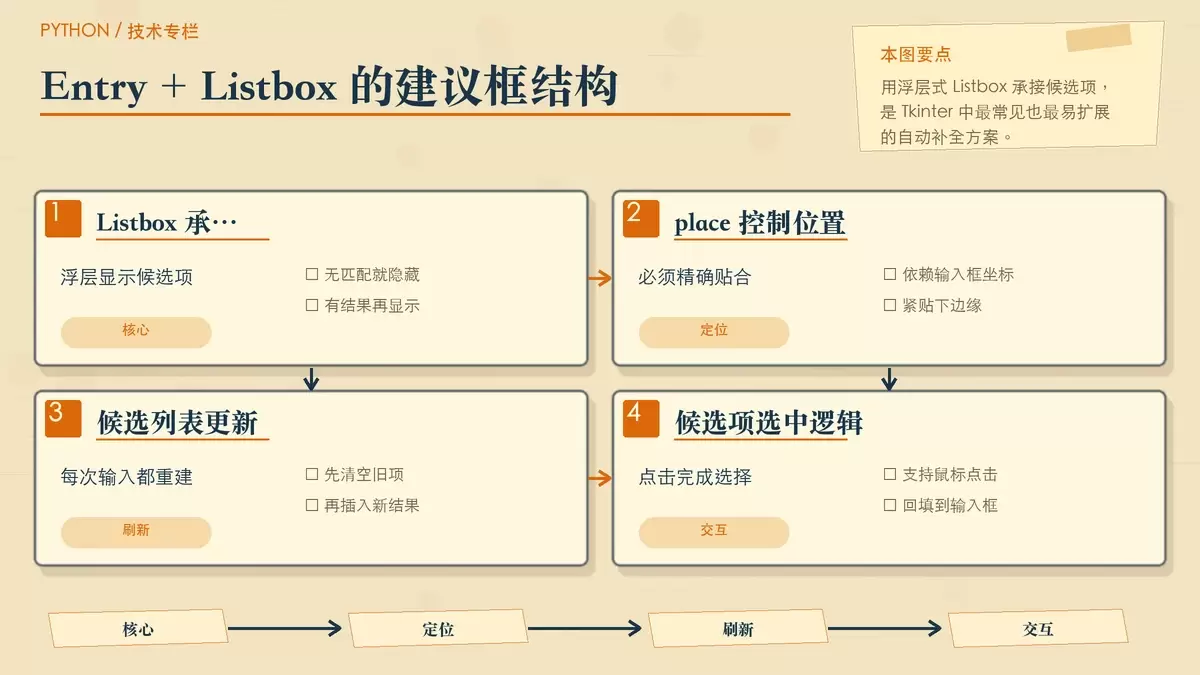
Tkinter 的 Entry 没有原生自动补全能力,常见的搜索建议框其实是 Entry、Listbox 和事件处理拼起来的交互组件。本文从为什么不能直接开箱即用讲起,再拆解轻量实现方式、Combobox 的局限,以及决定可用性的焦点、显隐和防抖细节。
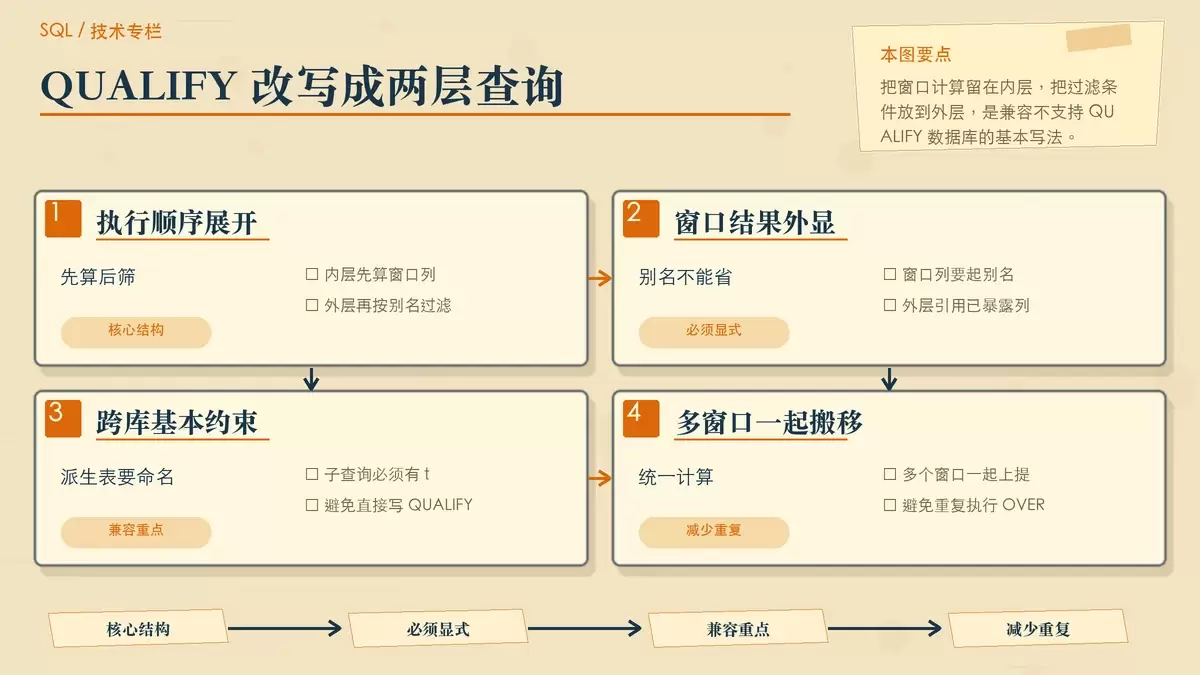
`QUALIFY` 适合在窗口函数计算后直接筛行,但它并不是 SQL 标准语法。遇到 PostgreSQL、SQL Server、以及不支持该关键字的 MySQL 版本时,最稳妥的办法是把查询改写成“内层算窗口、外层做过滤”的两层结构,同时检查排序、NULL 语义和执行计划。
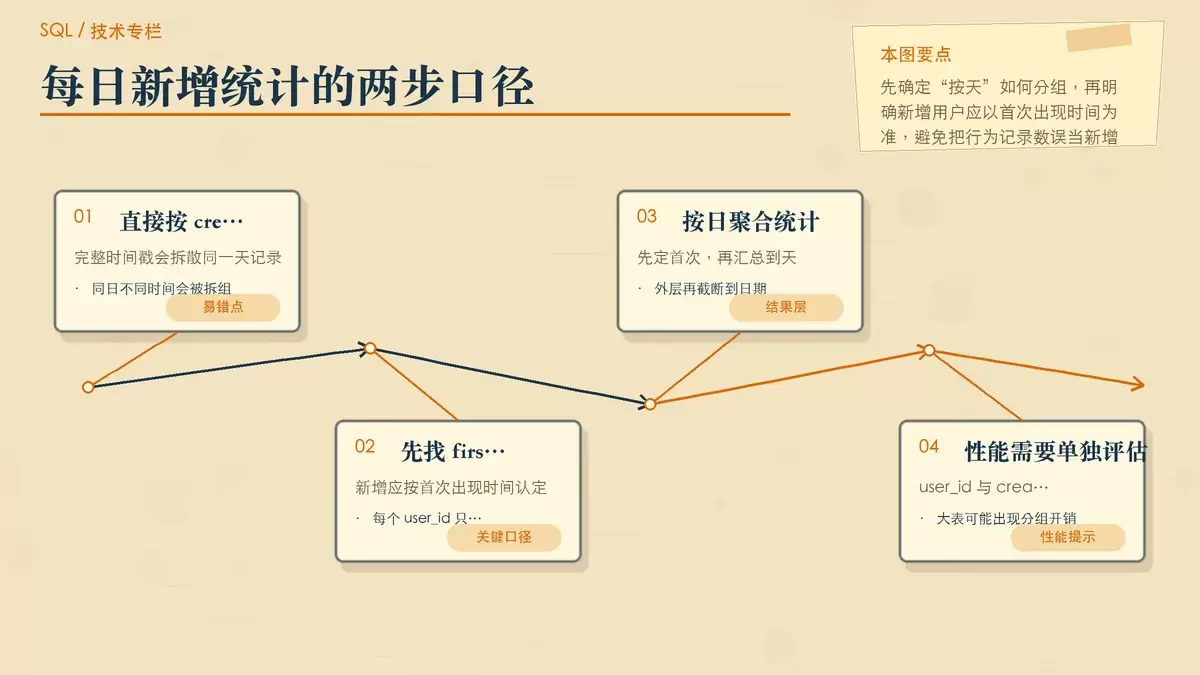
按日期统计每日新增用户,常见误区不是 SQL 语法,而是统计口径和时间处理。关键点有三处:先把时间截断到“日”,再用每个用户的最早注册时间定义新增,最后把时间过滤放进子查询,同时排除 NULL 和异常时间值,结果才可靠。
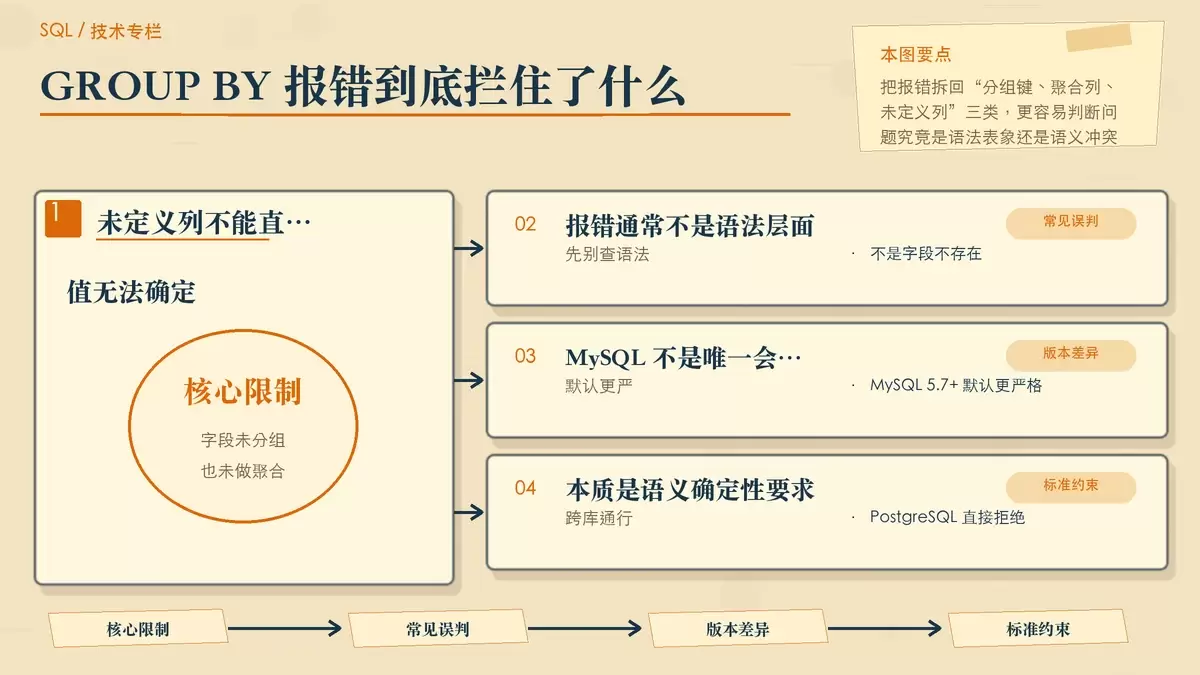
`GROUP BY` 语法看起来没问题却报错,通常不是拼写失误,而是数据库在拦截“结果不确定”的查询。本文从报错含义、常见误判、分组键设计、`ORDER BY` 别名可见性,到 `ANY_VALUE()` 的适用边界,梳理出更稳妥的排查与改写方式。
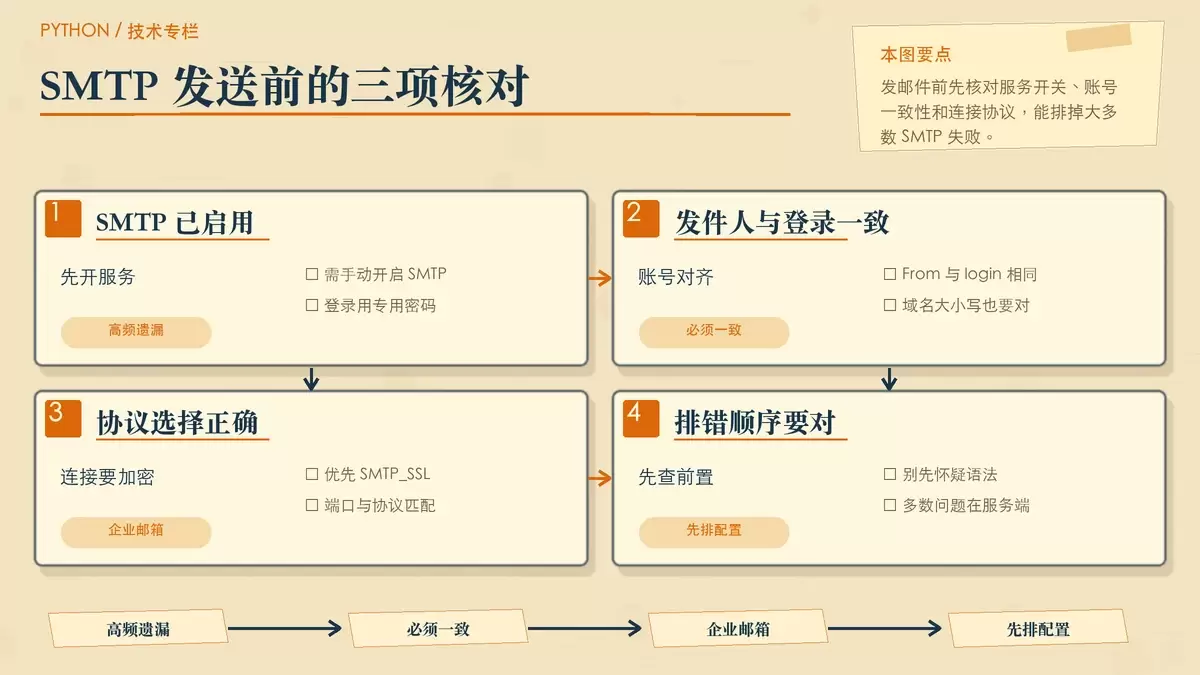
把分析结果自动推送到邮箱或企业微信,真正容易出问题的不是发送代码本身,而是鉴权、消息格式、调度稳定性和密钥管理。本文按这四个环节拆解常见报错与避坑点,并给出可直接改造的 Python 示例。
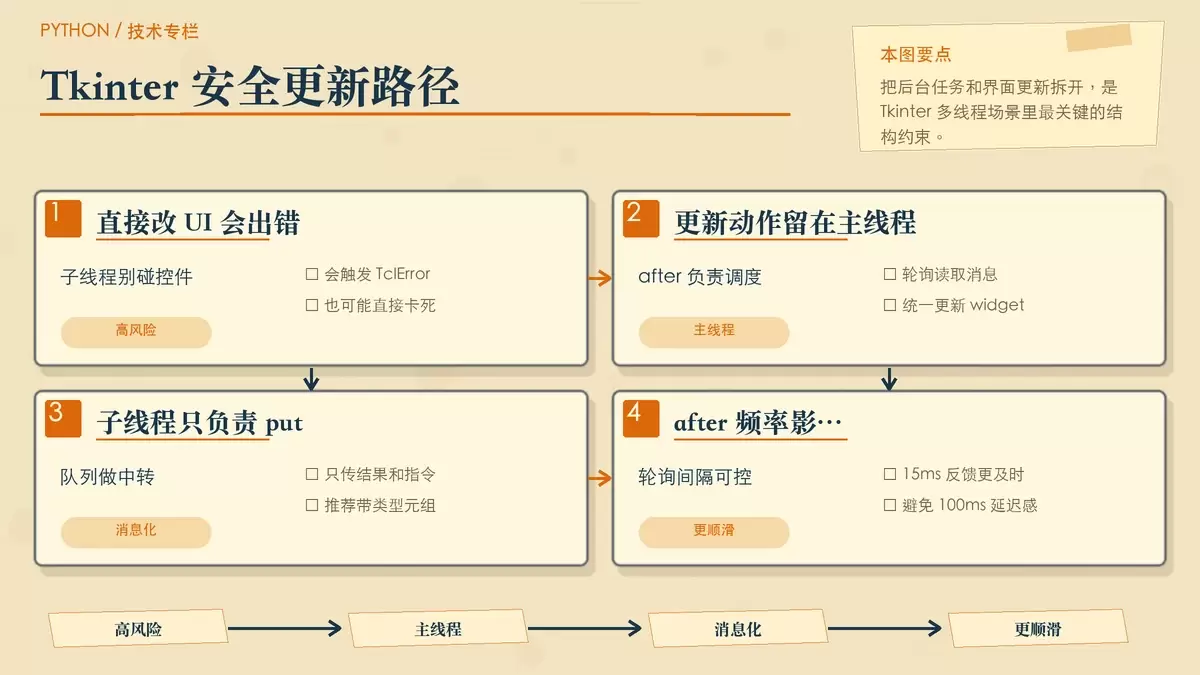
在 Tkinter 里,子线程直接改界面不是“有风险”,而是设计上就不成立。稳定做法只有一条:子线程把结果放进 `queue.Queue`,主线程借助 `root.after()` 定时取出并更新控件。文章会把原因、正确写法,以及线程池和退出清理这些常见细节一次讲清。