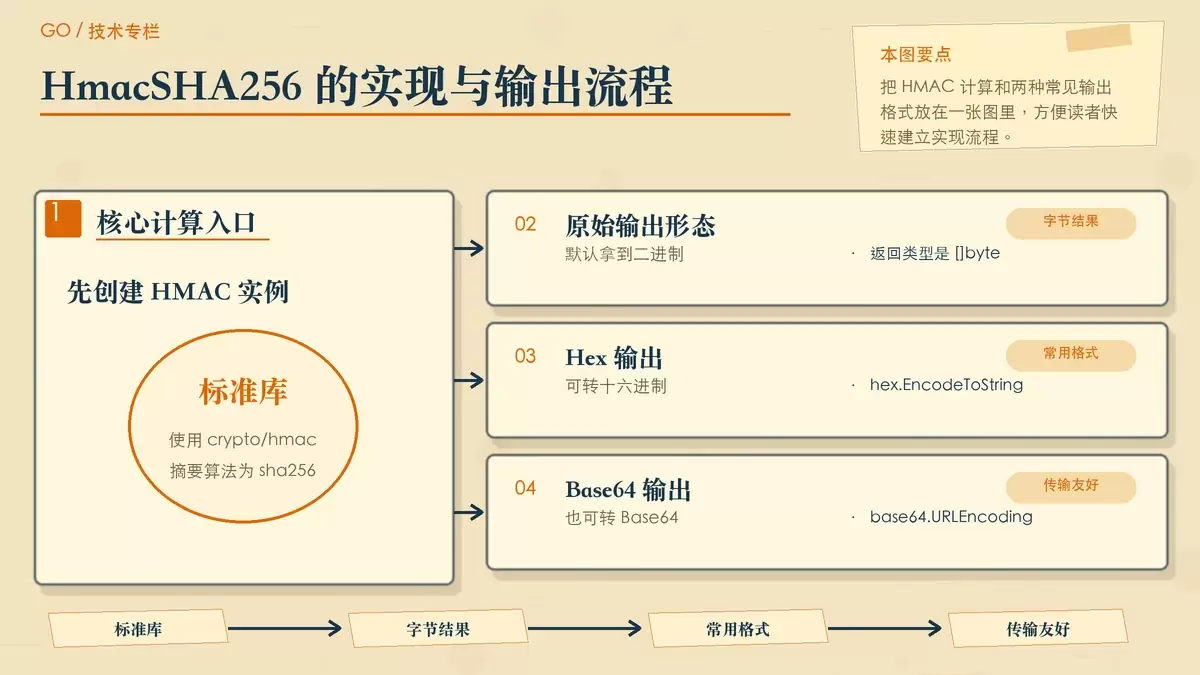
使用 Go 语言如何处理大小端字节序?
在 Go 里处理二进制数据时,大小端决定了多字节数值如何写入内存、文件或网络。本文结合 Go 标准库 `encoding/binary` 的常用接口,说明什么时候该用大端或小端、怎样在代码里完成转换,以及实际使用时最容易踩到的几个点。
2026-08-25
210

在 Go 里处理二进制数据时,大小端决定了多字节数值如何写入内存、文件或网络。本文结合 Go 标准库 `encoding/binary` 的常用接口,说明什么时候该用大端或小端、怎样在代码里完成转换,以及实际使用时最容易踩到的几个点。
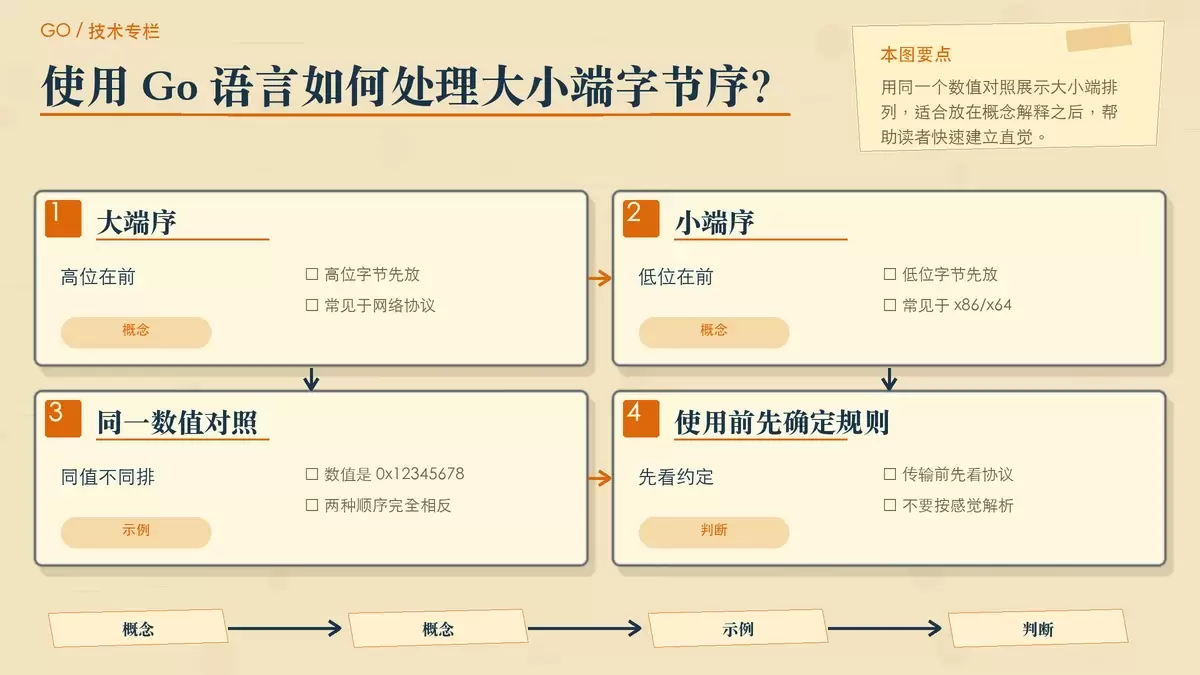
`[...]int{}` 不是错误语法,而是 Go 中“由编译器推断数组长度”的写法。配合按索引初始化和 `rune` 字符常量后,这道看起来像 `map` 的题,结果其实是长度 `100`。文章会把三处容易混淆的点拆开解释清楚。 `[...]int{}` 在 Go 里并不是少见语法,但和按索引初始化、单引号字符放在一起时,很容易让人误判成 `map` 或直接怀疑会编译失败。
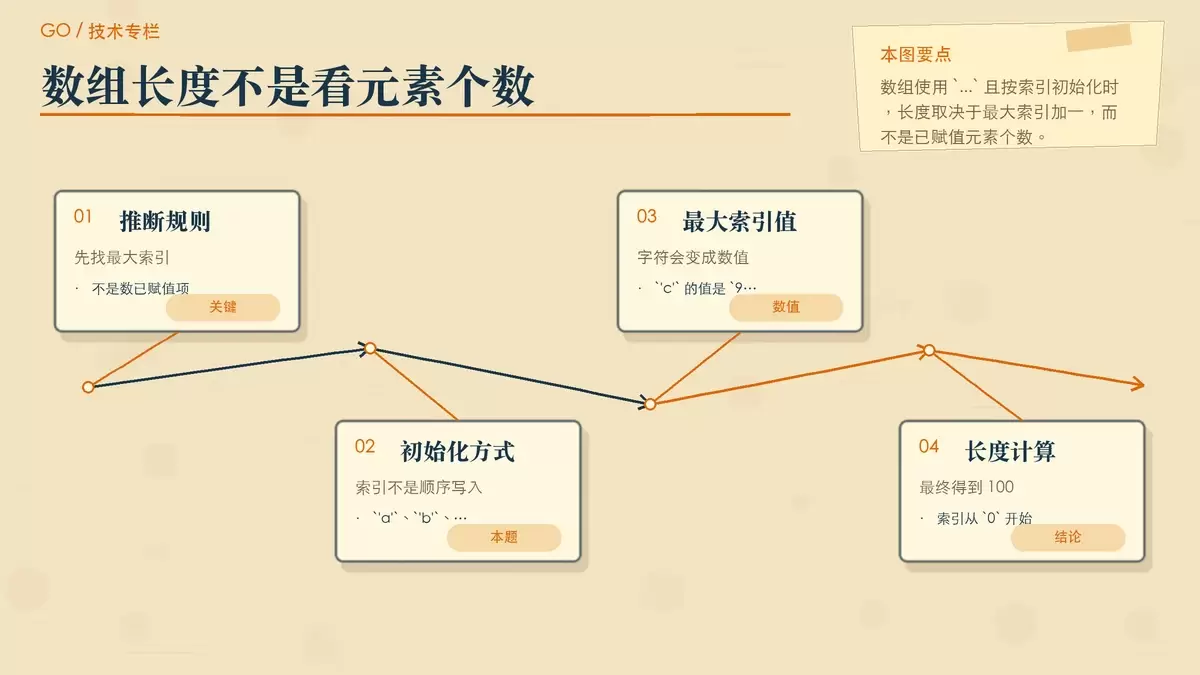
这篇文章按 Kotlin 官方语义把 77 个关键字重新梳理成三组:硬关键字、软关键字和修饰符关键字。重点不在机械背表,而是帮你判断它们分别会在什么场景触发语法规则、哪些绝不能当标识符、哪些只在上下文中生效。
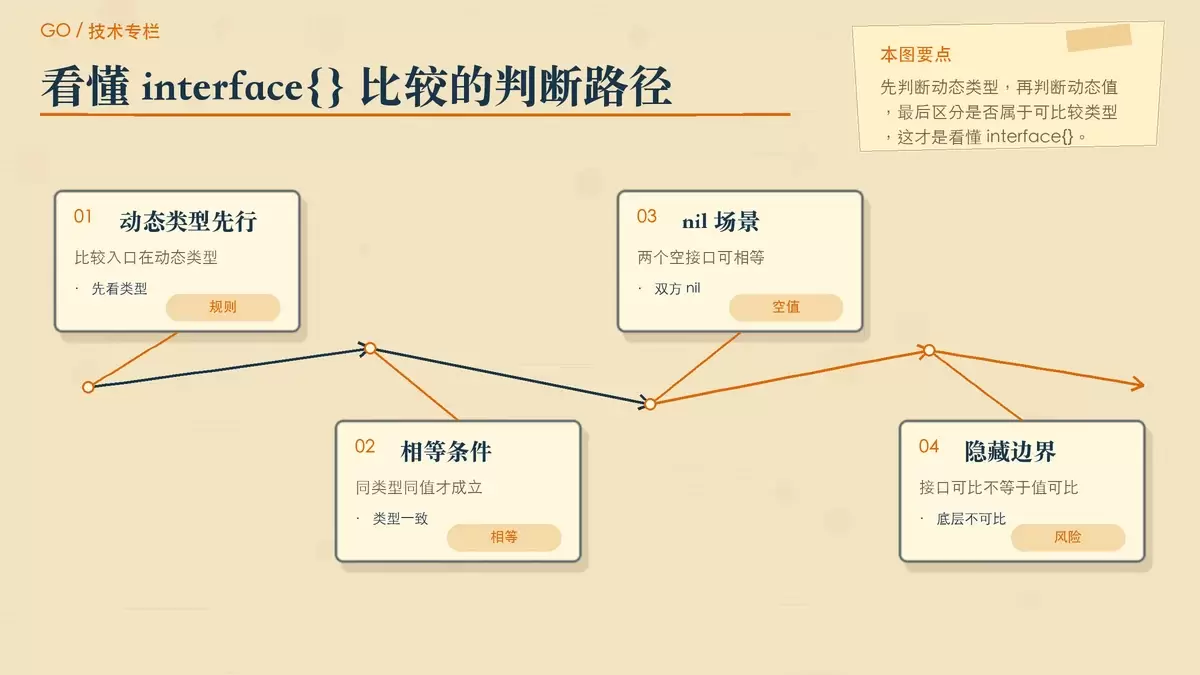
在 Go 里,两个 `interface{}` 能不能直接用 `==` 比较,答案不是简单的是或否。关键在于它们的动态类型、动态值,以及底层具体类型是否本身可比较;一旦把 `slice`、`map`、`func` 装进接口再硬比,就可能在运行时直接 `panic`。
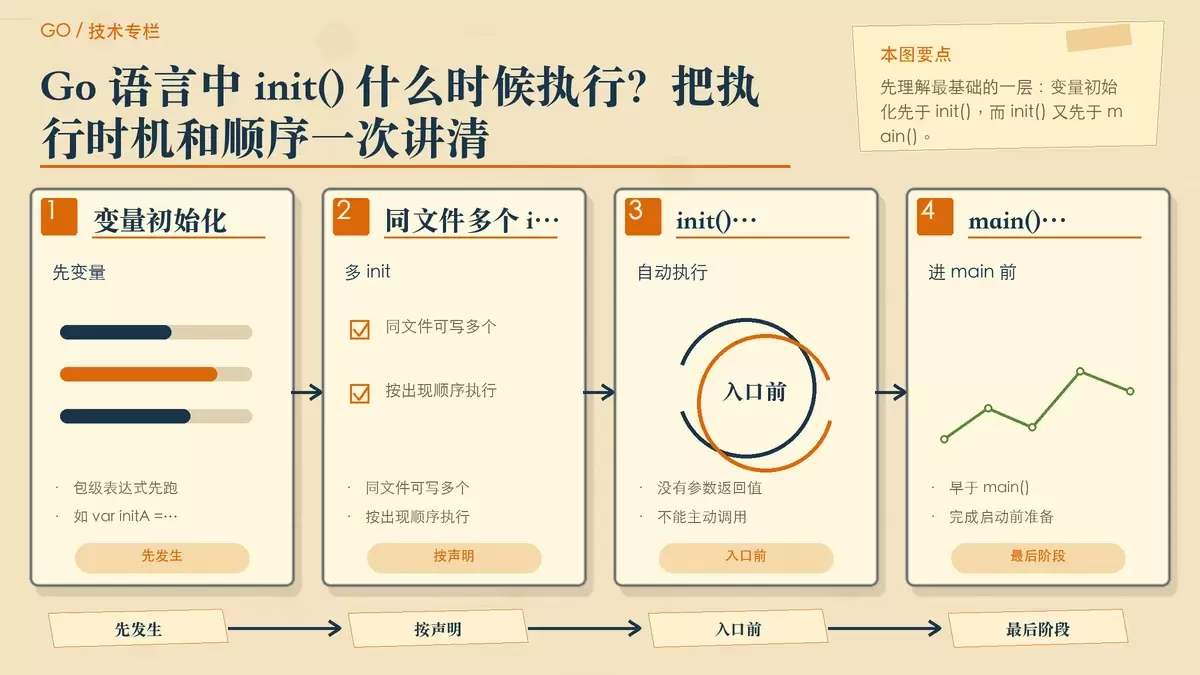
Go 里的 init() 常被说得很神秘,实际可以拆成几个明确规则:变量初始化先于 init() ,同文件内按出现顺序执行,同包内跨文件通常按文件名顺序执行,而跨包则先执行被依赖包。把这些顺序梳理清楚,才能判断哪些初始化方式适合放进 init() 。
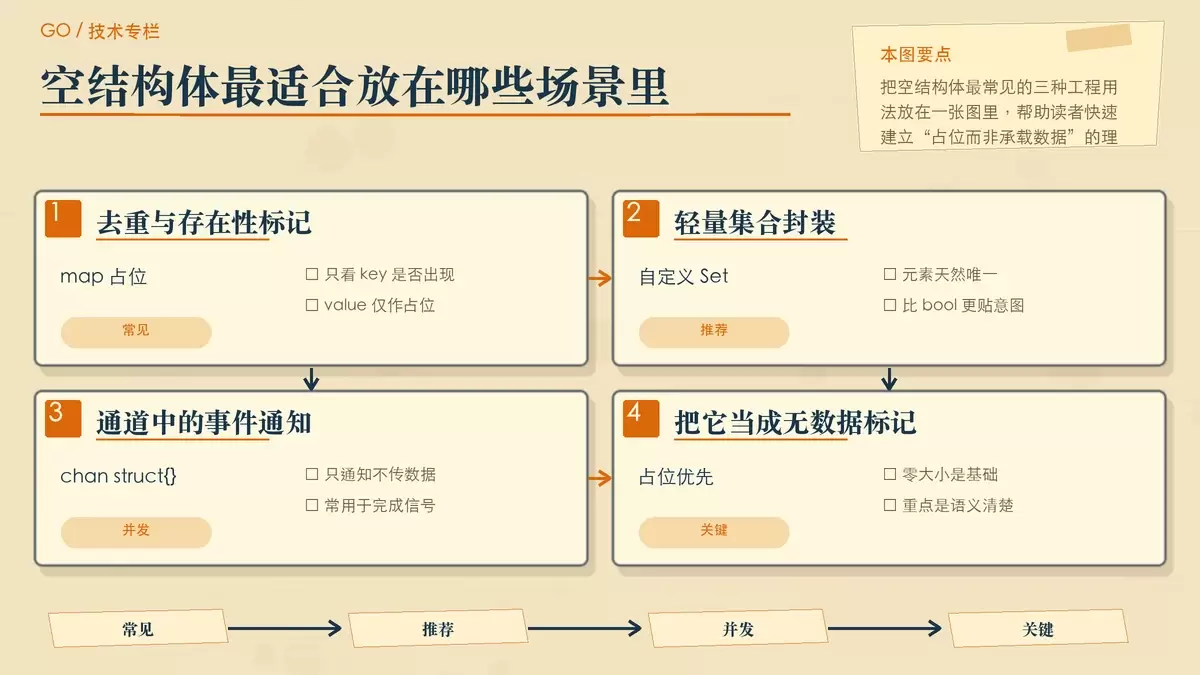
Go 里的空结构体 `struct{}` 看起来只是“没有字段”的类型,真正有价值的地方在于它的零大小特性,以及由此带来的占位、去重、信号通知等常见用法。本文结合代码示例梳理它在项目中的实际场景,也说明“零内存”与“地址可能相同”分别该怎样理解。
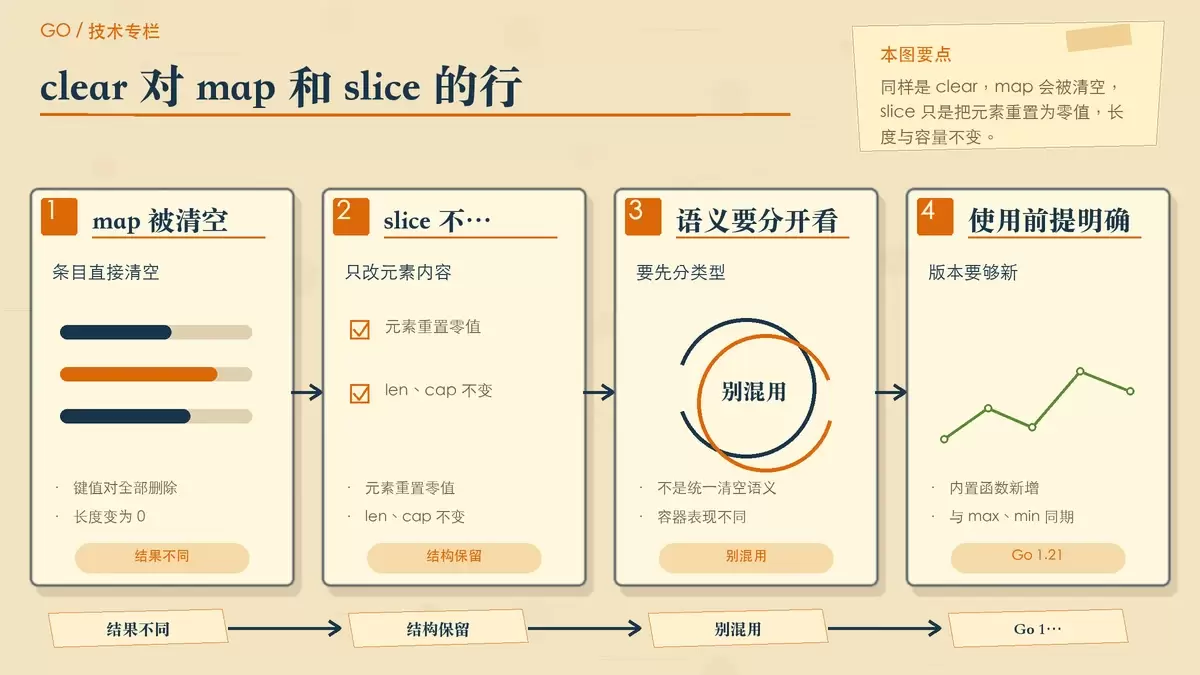
Go 1.21 新增的内置函数 clear,专门用于 map 和 slice,但两者的行为并不相同:map 会被清空,slice 只会把元素重置为零值。本文结合官方定义和代码示例,讲清它的适用范围、实际效果,以及在泛型场景下应如何理解。
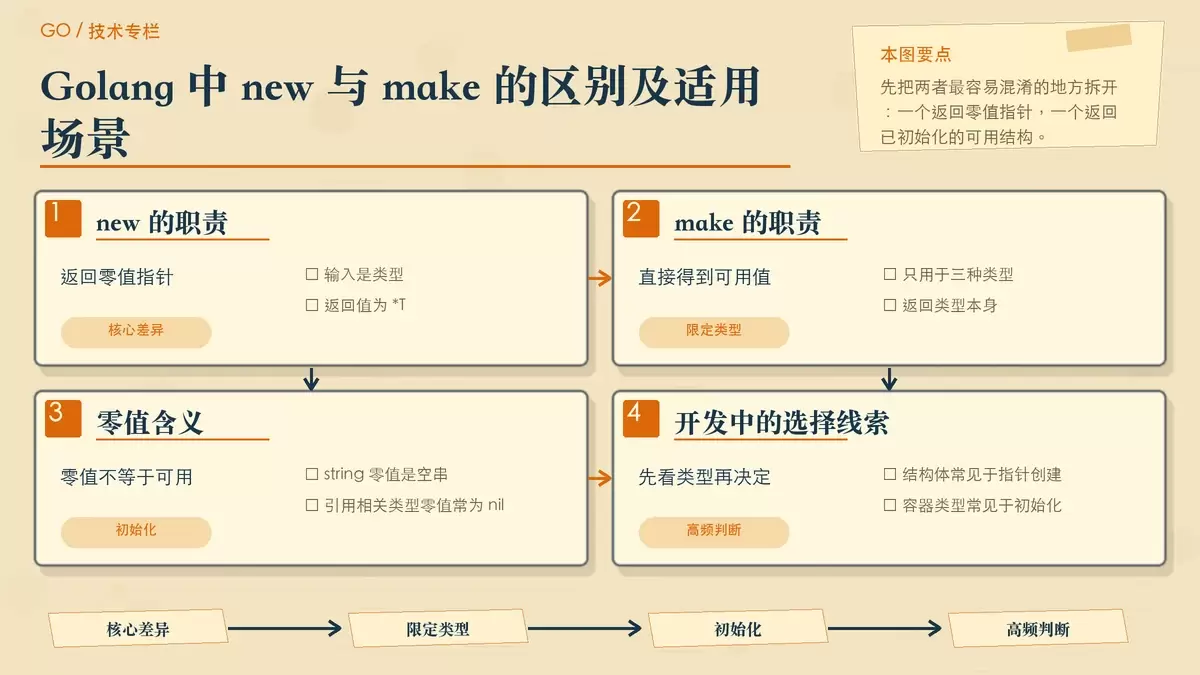
在 Go 里,`new` 和 `make` 都和内存分配有关,但职责并不相同。前者返回某个类型的零值指针,后者只服务于 `slice`、`map`、`channel`,并直接完成可用结构的初始化。理解这层差异,才能避免 `nil map`、空通道这类常见问题。 刚接触 Go 时, new 和 make 很容易被当成“两个都能申请内存的函数”来记忆,但一到写结构体、切片或映射时,差别马上就会暴露出来。
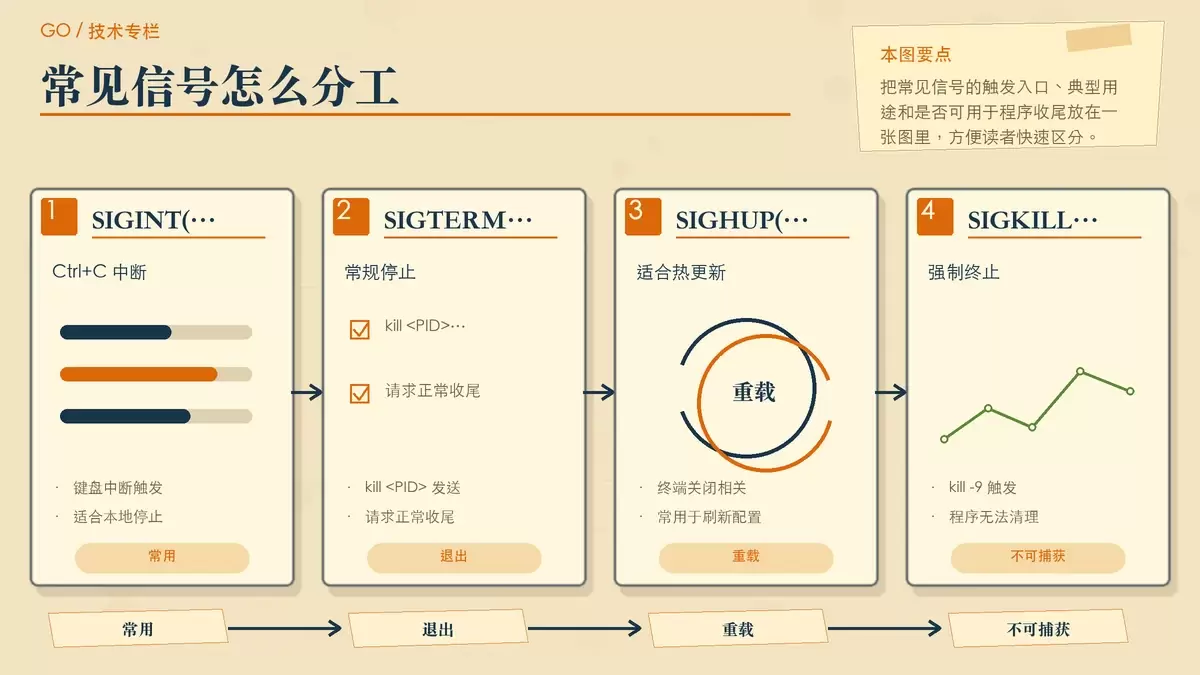
在 Go 程序里接收系统信号,核心并不复杂:用 `os/signal` 监听,用带缓冲通道接收,再按 `SIGINT`、`SIGTERM`、`SIGHUP` 等类型决定退出、清理或重载。文章结合基础示例和 HTTP 服务优雅退出,梳理信号处理的常见做法与边界。
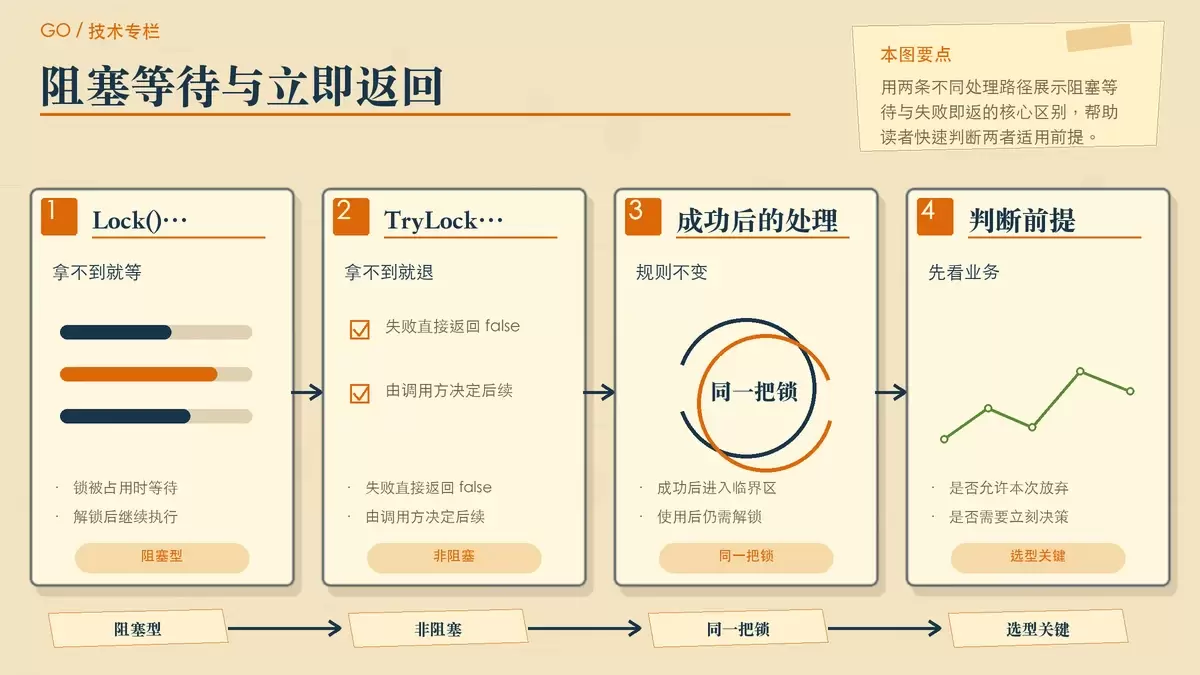
Go 1.18 为 `sync.Mutex` 和 `sync.RWMutex` 补上了 `TryLock()`,让加锁失败时可以立即返回,而不是像 `Lock()` 一样持续阻塞。它适合“抢到就做、抢不到就放弃”的轻量并发控制,但也不该被当成通用解法,关键还是先判断场景是否真的需要非阻塞锁。
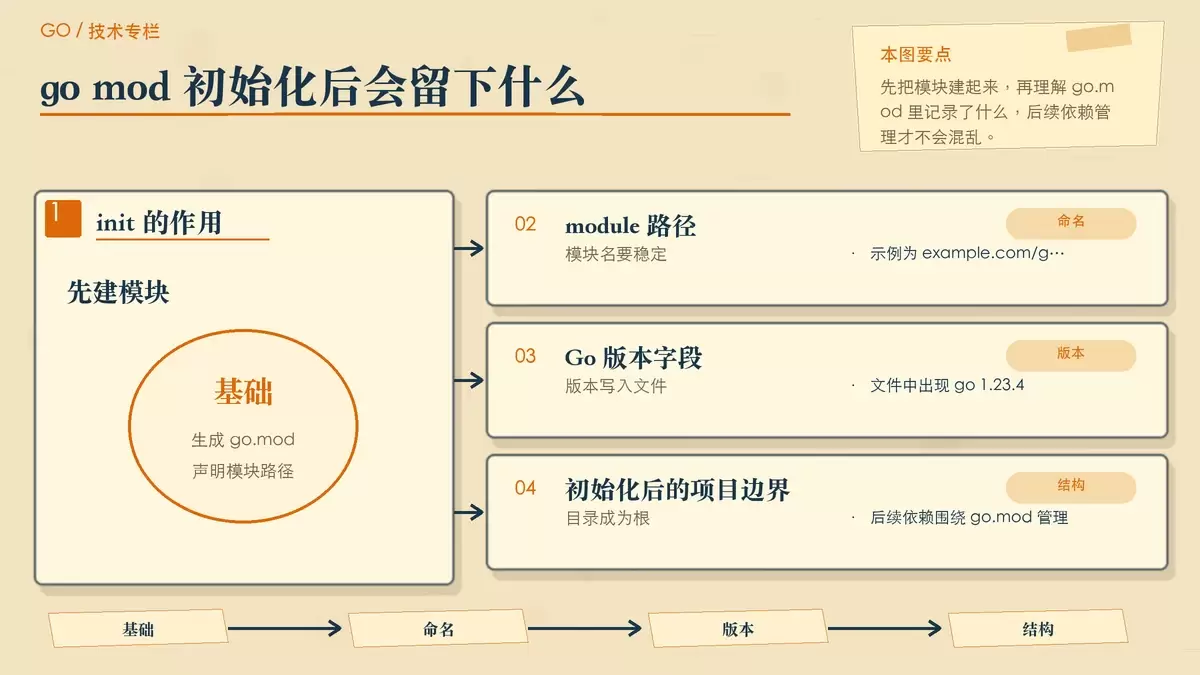
go mod 是 Go 项目默认的依赖管理方案,从初始化模块、引入依赖到清理和校验,都有相对稳定的工作流。本文按实际开发顺序梳理常用命令,帮助你判断该在什么场景下用 init、get、tidy 以及其他子命令。
这篇文章用一个完整的 Go 示例说明如何实现 `HmacSHA256`,并解释为什么结果通常还要再转成十六进制或 Base64 字符串。文中保留原始代码与输出,适合需要对接支付签名、接口鉴权或通用消息摘要的开发者快速上手。