


在 BigQuery、Snowflake 里,QUALIFY 常被用来直接过滤窗口函数结果,写法简洁,但一到 PostgreSQL、SQL Server,或者不支持该语法的 MySQL 环境,查询往往连解析阶段都过不了。要把这类 SQL 安全迁到通用数据库,关键不只是把关键字换掉,而是把“先做窗口计算、再按结果筛选”的执行语义完整保留下来,并顺手排查排序稳定性、NULL 处理和性能是否发生偏移。
为什么很多数据库根本不支持 QUALIFY
QUALIFY 是 BigQuery、Snowflake、Teradata 等分析型数据库支持的窗口过滤子句,用来在窗口函数计算完成后直接筛选结果行。问题在于,它不是 SQL 标准的一部分,所以很多常见数据库并不识别这个关键字。
这意味着,原本在分析型数据库里可以直接执行的查询,迁到通用数据库后通常会立刻报语法错误,而不是返回错误结果这么简单。
- MySQL 8.0.x:解析器遇到
QUALIFY会直接中断,连语法检查都无法通过 - PostgreSQL:报错为
syntax error at or near "QUALIFY" - SQL Server 2024 及更早:常见错误是
Msg 156, Level 15, State 1: Incorrect syntax near the keyword 'QUALIFY' - MySQL 在 8.1 才计划支持,但尚未 GA,因此不能按已可用能力处理
如果你维护的是跨库 SQL,或者正在做报表、视图、ETL 查询迁移,就不能把 QUALIFY 当成“普遍可用”的语法糖。兼容性处理必须提前做。
通用改写方式:窗口函数放内层,过滤条件移到外层
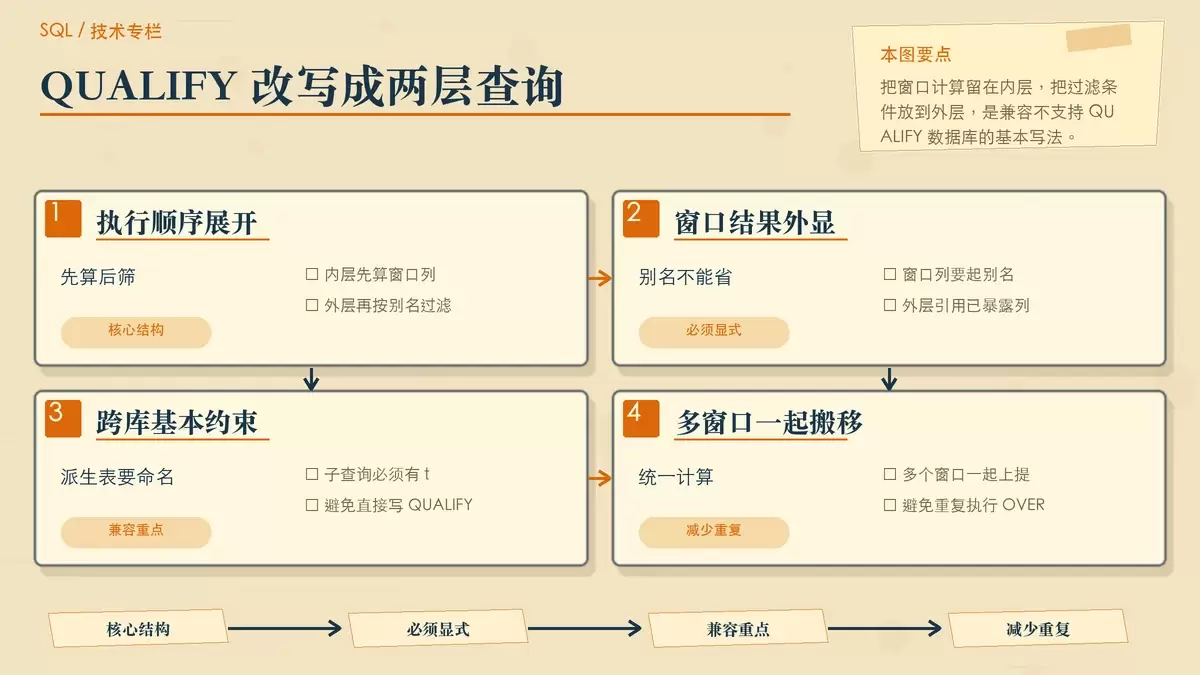
兼容改写的核心思路很简单:把 QUALIFY 条件移到外层 WHERE,同时把原本要参与过滤的窗口函数先在内层 SELECT 中算出来,并显式起别名。换句话说,不能再依赖 QUALIFY 隐式引用窗口结果,而要把这一步展开写清楚。
单个窗口条件的标准改写
原始写法通常类似下面这样:
SELECT user_id, amount, ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY ts DESC) rn FROM orders QUALIFY rn = 1改写成通用 SQL 后,应写成两层结构:
SELECT user_id, amount FROM (SELECT user_id, amount, ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY ts DESC) AS rn FROM orders) t WHERE t.rn = 1这样做的本质,是先在子查询中生成 rn,再在外层按 t.rn = 1 过滤。这个结构在 PostgreSQL、SQL Server、以及支持窗口函数的 MySQL 环境中都更容易落地。
改写时必须保留的几个规则
- 窗口函数必须出现在内层
SELECT列表里,并带别名,例如AS rn - 外层过滤只能引用内层已经暴露出来的列,不能继续写原始的
QUALIFY逻辑形式 - 子查询必须有别名,例如
t,否则 MySQL 会报Every derived table must have its own alias - 如果原查询中已有普通过滤条件,比如时间范围,通常要优先放进内层,避免窗口计算作用在过大的数据集上
多个窗口表达式时不要重复计算
如果原来的 QUALIFY 条件不止一个窗口函数,例如:
QUALIFY rn = 1 AND SUM(amount) OVER () > 1000那就不能只把 rn 提到内层,另一个窗口表达式也要一起搬进去,统一在内层算完,再交给外层筛选。这样既能保持逻辑一致,也能避免重复执行窗口计算,减少不必要的开销。
三类最容易出错的地方
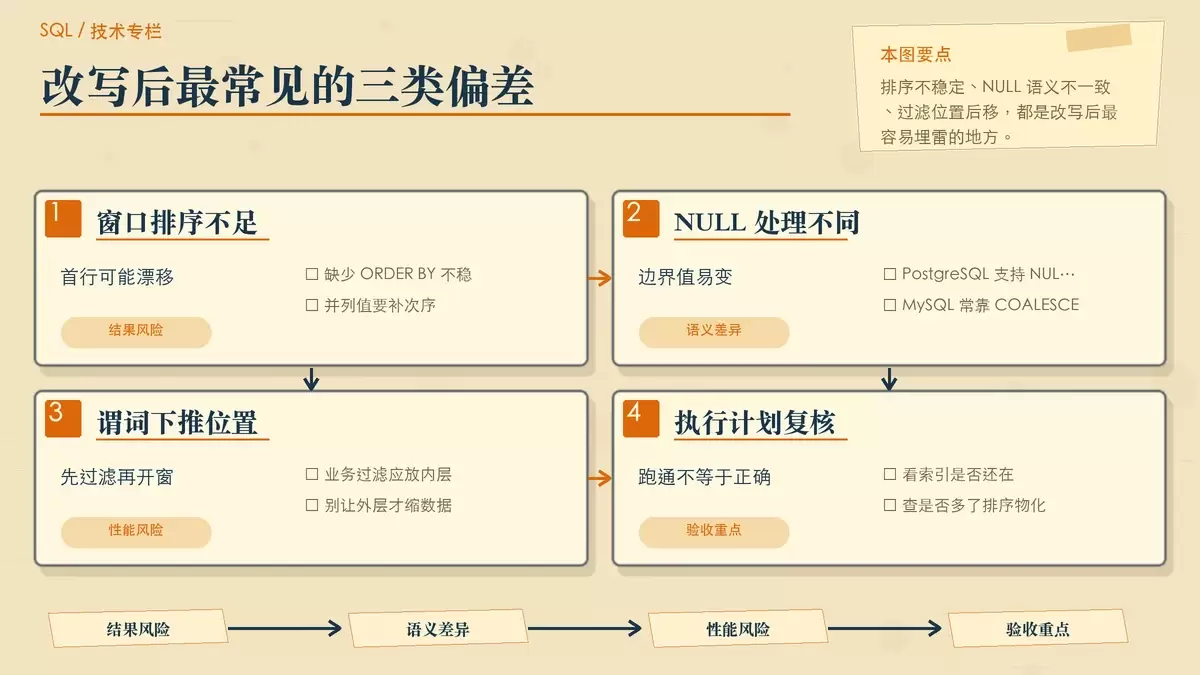
把 QUALIFY 改成子查询并不难,难的是改完后结果是否还和原来一致。实际迁移里,最容易出问题的通常是下面三类细节。
1. 窗口排序不完整,ROW_NUMBER 结果会漂移
ROW_NUMBER()、RANK() 这类窗口函数对排序条件高度敏感。如果窗口定义里没有稳定的 ORDER BY,同一批数据在不同数据库中可能得到不同结果,甚至同一数据库多次执行顺序也不完全可控。
- 窗口缺少
ORDER BY时,结果本身就没有稳定保证 - MySQL 8.0+ 某些场景下会直接报错,如
Window 'w' lacks an ORDER BY clause - 如果排序字段存在重复值,最好补足第二排序键,避免“第一条记录”在并列情况下反复变化
因此,凡是从 QUALIFY rn = 1 这类语句迁出的查询,都应该先检查窗口排序是否能唯一确定结果。
2. NULL 排序语义在不同数据库里并不一致
另一个常见陷阱是 NULL。分区键或排序字段一旦包含 NULL,不同数据库对 NULLS FIRST、NULLS LAST 的默认行为并不相同,窗口结果就可能出现偏差。
- PostgreSQL 默认有自己的 NULL 排序行为,并支持显式写
NULLS LAST - MySQL 不支持同样的控制写法,往往需要改写表达式来模拟
- 为了统一语义,可以考虑使用
COALESCE(col, '9999-12-31')这类方式做兜底,但前提是该占位值与业务语义匹配
这类问题最麻烦的地方在于:SQL 能正常执行,结果看起来也“差不多”,但在边界数据上会少一条或多一条记录。做迁移时,必须拿带 NULL 的样本专门核对。
3. 过滤位置放错,性能可能明显退化
两层嵌套结构虽然兼容性更好,但也可能影响优化器的判断。最典型的问题,是把本来可以提前过滤的数据,拖到外层才处理,导致内层先做了大规模窗口计算。
例如原查询中如果已经有:
WHERE date > '2025-01-01'这类条件通常应该保留在内层子查询中,让数据库先缩小参与窗口运算的数据范围;外层再只负责类似 WHERE t.rn = 1 的结果过滤。要是把业务过滤全留到外层,执行计划就可能变差,索引利用率也会下降。
批量改写时,先避免误替换,再验证执行计划
很多人第一反应是用正则或脚本批量替换 QUALIFY,但这一步其实风险很高。因为 QUALIFY 后面的条件可能跨多行、带括号嵌套,也可能混在注释或字符串字面量里,简单替换很容易把 SQL 结构改坏。
- 不要直接使用
sed -i 's/QUALIFY/), t WHERE t./g'这类暴力替换方式 - 如果涉及视图迁移,优先通过
SHOW CREATE VIEW取出定义,再逐条重写 - 不要指望
mysqldump一类导出工具自动处理QUALIFY兼容问题,它们通常只负责导出定义,不会修复语法差异
改写完成后,除了验证结果集,还应检查执行计划是否发生异常变化:
- MySQL 8.0+ 可用
EXPLAIN FORMAT=TREE - PostgreSQL 可用
EXPLAIN (VERBOSE)
重点不是计划长什么样,而是看改写后是否仍能利用原有索引、是否出现额外的全表扫描、排序或物化步骤。
兼容的关键不在语法,而在语义是否完整保留
从表面看,QUALIFY 只是一个数据库不认识的关键字;但真正需要迁移的是它背后的执行顺序,也就是“先计算窗口结果,再按结果过滤”。只要把这个顺序准确展开为“内层计算、外层筛选”,大多数查询都能改写成功。
不过,语法能跑通不代表迁移已经完成。排序是否稳定、NULL 的处理是否一致、原有过滤是否被提前下推、执行计划有没有明显退化,这些才是判断改写是否可靠的依据。对于跨数据库 SQL,最后一定要拿边界数据和执行计划一起验收,而不是只看语句能否执行。









