C++ 如何去掉字符串中的所有特定协议头
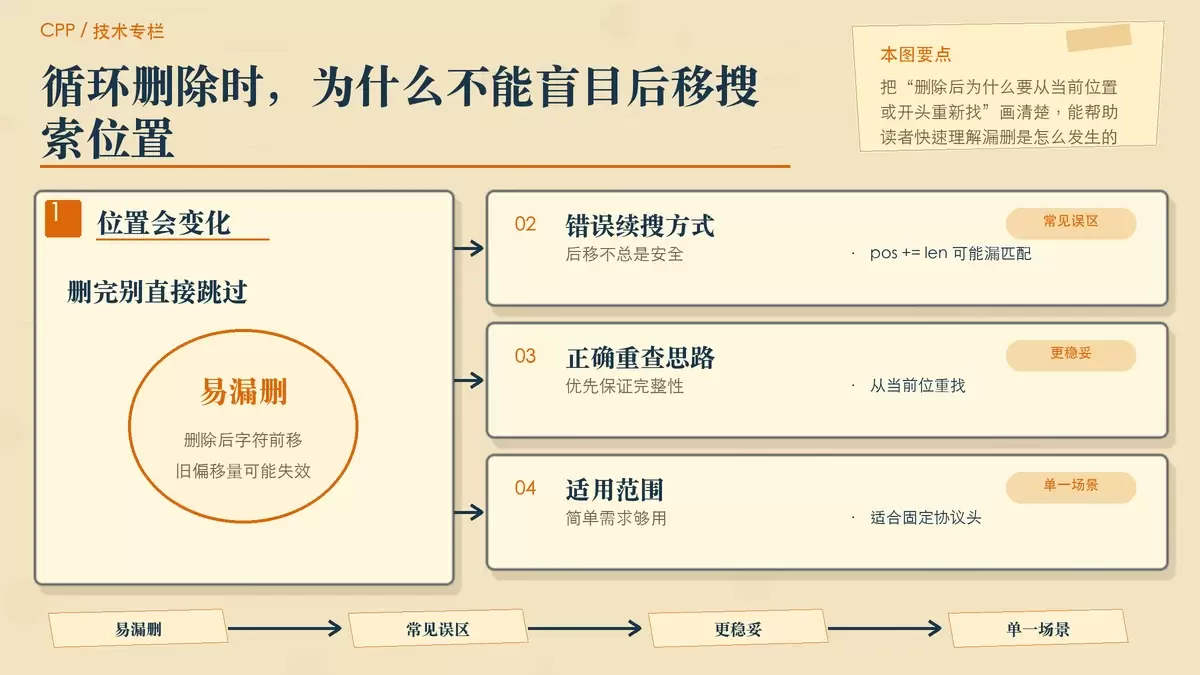
去掉字符串里的协议头,看似只是一次替换,实际要先分清是“原地删除所有匹配”、还是“只做只读解析”。本文结合 `find + erase`、`std::regex_replace` 和 `std::string_view` 三种写法,说明各自适用场景,以及重复匹配、长度优先和边界判断这些最容易出错的细节。
2026-08-25
205

去掉字符串里的协议头,看似只是一次替换,实际要先分清是“原地删除所有匹配”、还是“只做只读解析”。本文结合 `find + erase`、`std::regex_replace` 和 `std::string_view` 三种写法,说明各自适用场景,以及重复匹配、长度优先和边界判断这些最容易出错的细节。
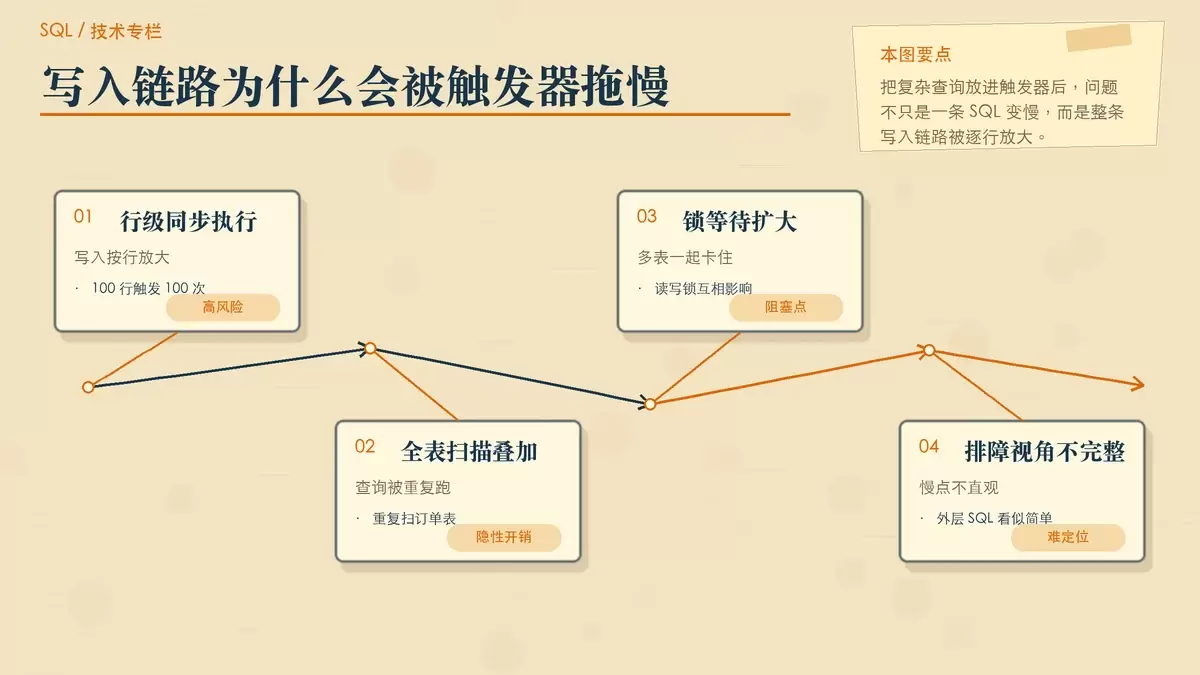
把复杂查询塞进 SQL 触发器,问题不只是“可能变慢”,而是会把写入路径直接拖进同步阻塞。本文拆开触发器为何会放大全表扫描、锁等待和排障难度,也给出更适合上线环境的替代做法,帮助你判断哪些写法该立即移除。
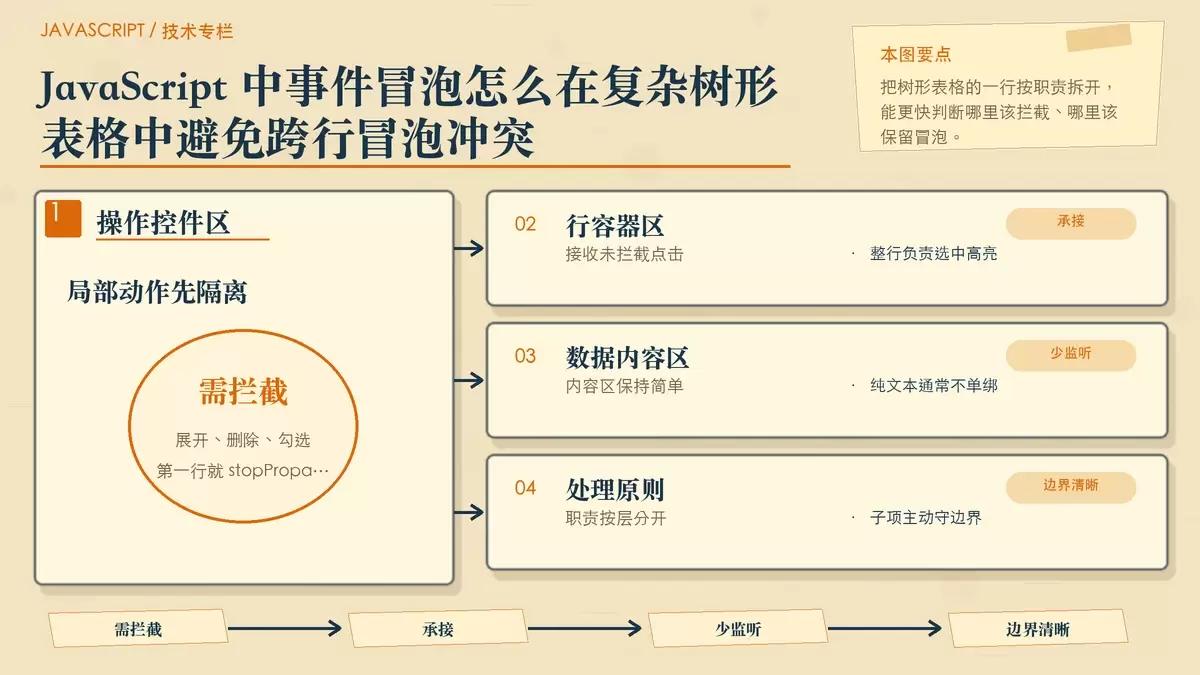
复杂树形表格里的点击冲突,通常不是事件冒泡机制失灵,而是行级交互和局部控件的边界没有划清。处理这类问题的核心是:只在展开按钮、复选框、操作按钮等局部控件上精准调用 e.stopPropagation(),让整行监听继续承担选中、高亮或跳转职责。
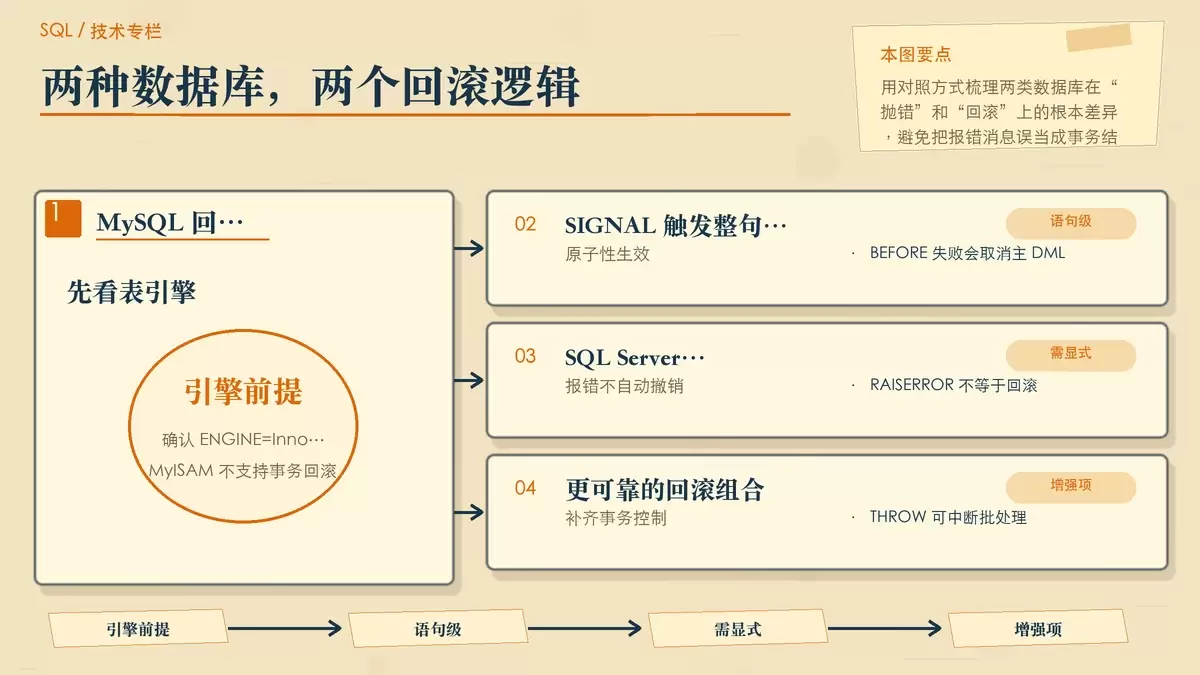
触发器里一旦抛错,为什么有的库会自动回滚,有的却只是报错后继续保留数据?关键不在“触发器会不会回滚”,而在数据库引擎、事务设置和异常传播链路。本文用 MySQL 与 SQL Server 对照拆开讲清常见误判与排查方法。
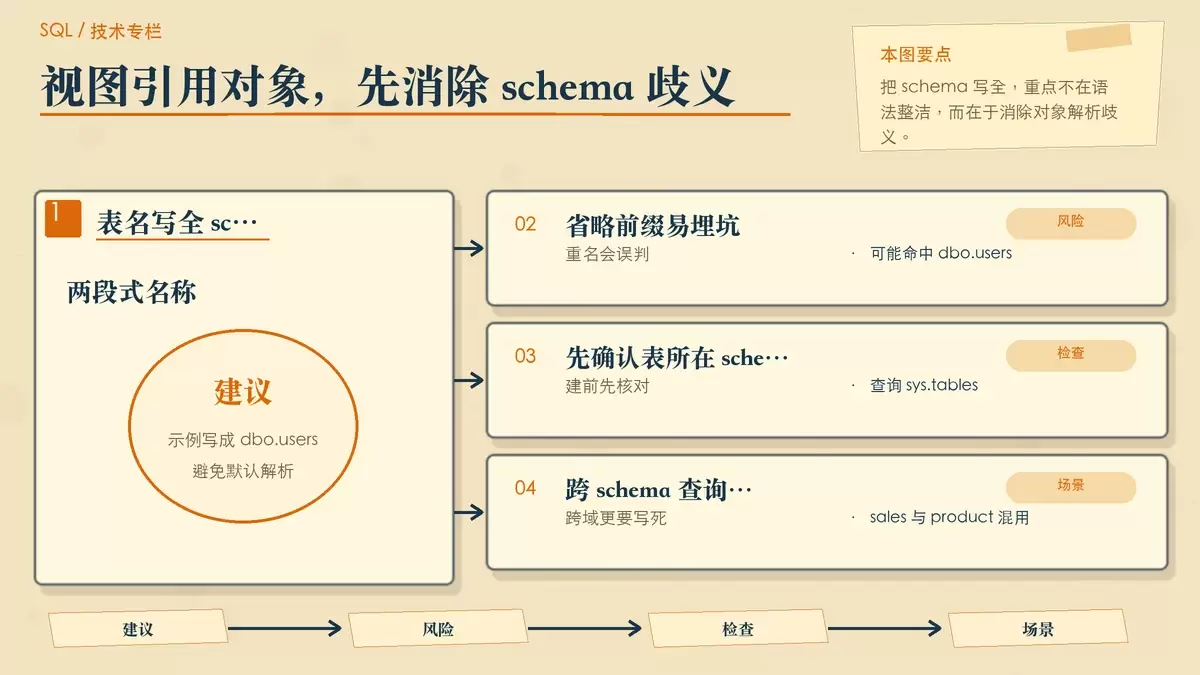
在 SQL Server 2019 里,视图并不只是把一段 SELECT 包起来。真正决定它是否稳定、可维护的,是架构名是否写全、是否启用 WITH SCHEMABINDING,以及过滤和计算逻辑放在什么位置。本文按创建、约束和排障三个层面梳理常见坑点与可执行做法。
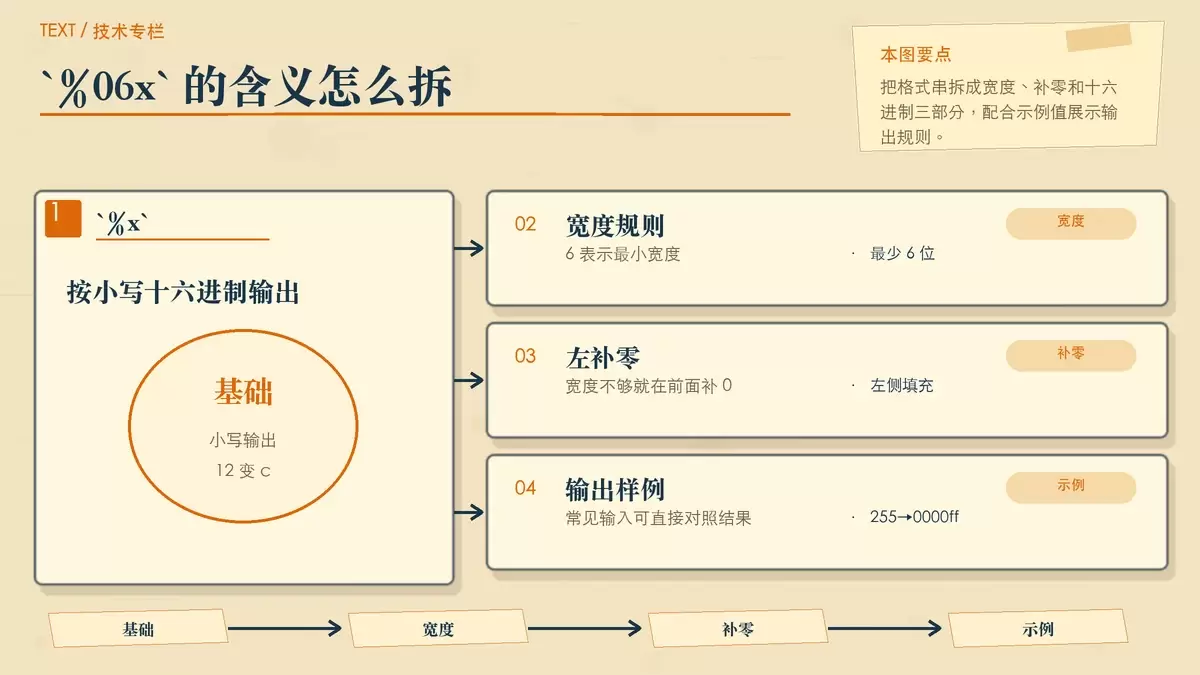
在 Go 里把整数转成固定长度的 6 位十六进制字符串,最直接的做法是 `fmt.Sprintf("%06x", num)`。它能输出小写、左侧补零的结果,但要注意这里的 6 只是最小宽度,不会在超出时自动截断;如果你只想保留低 24 位,还需要先做位掩码处理。
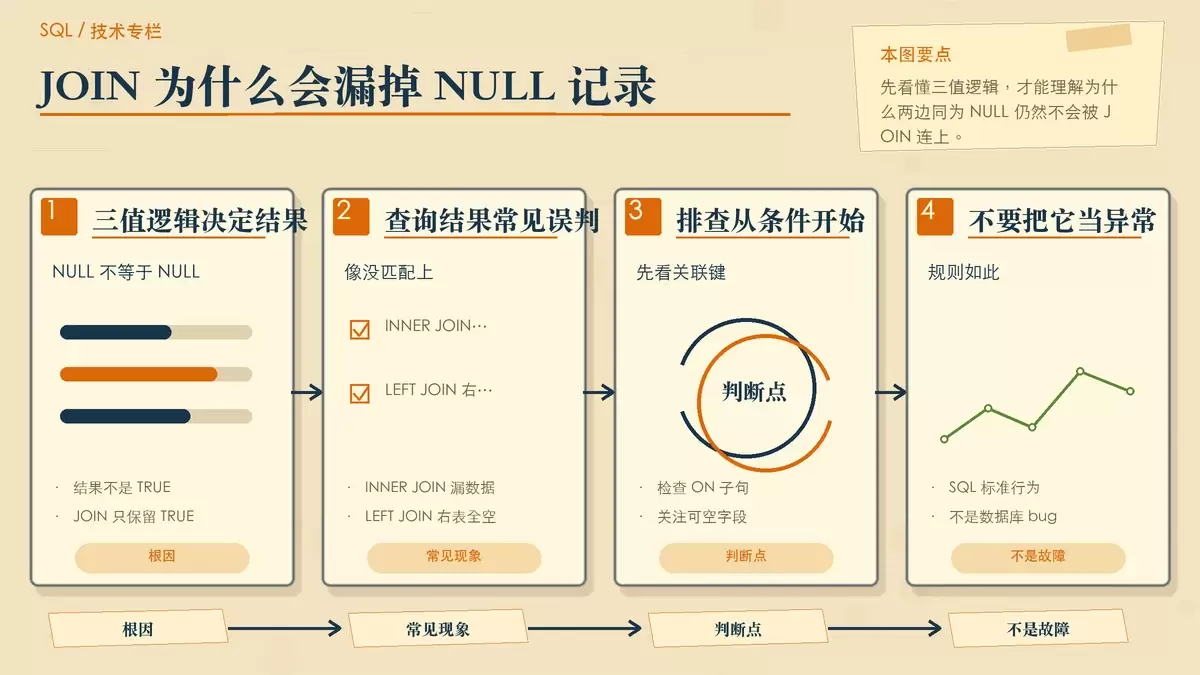
SQL 里 `JOIN` 字段包含 `NULL` 时,`=` 并不会把两边都是 `NULL` 的记录连起来,因为 `NULL = NULL` 的结果是 `UNKNOWN`。这篇文章把三种常见处理方式拆开说明:`IS NOT DISTINCT FROM`、显式 `OR` 分支,以及 `COALESCE` 的适用边界,帮助你同时判断语义是否正确、执行计划是否可靠。
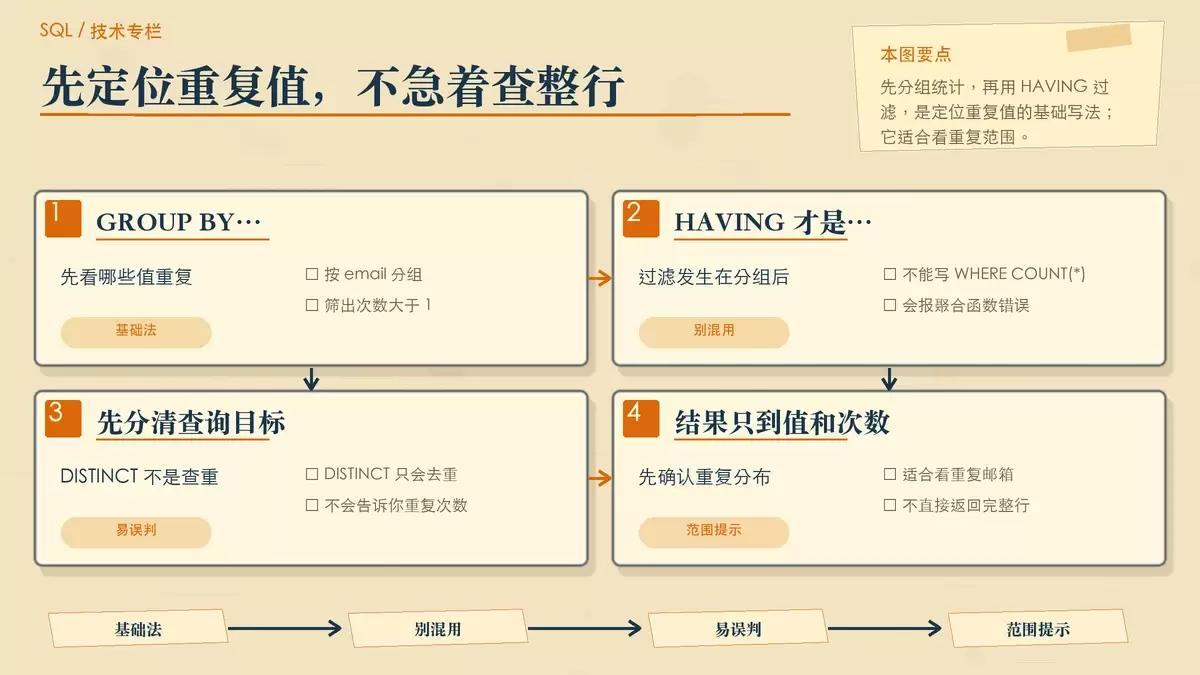
SQL 查重常见分成两类:先找出哪些值重复,再定位到具体重复行。本文按查询目标和数据库版本拆开说明,分别给出 GROUP BY + HAVING、ROW_NUMBER() 以及 MySQL 5.7 自连接方案,并补上删除前最容易忽略的保留策略与复核要点。
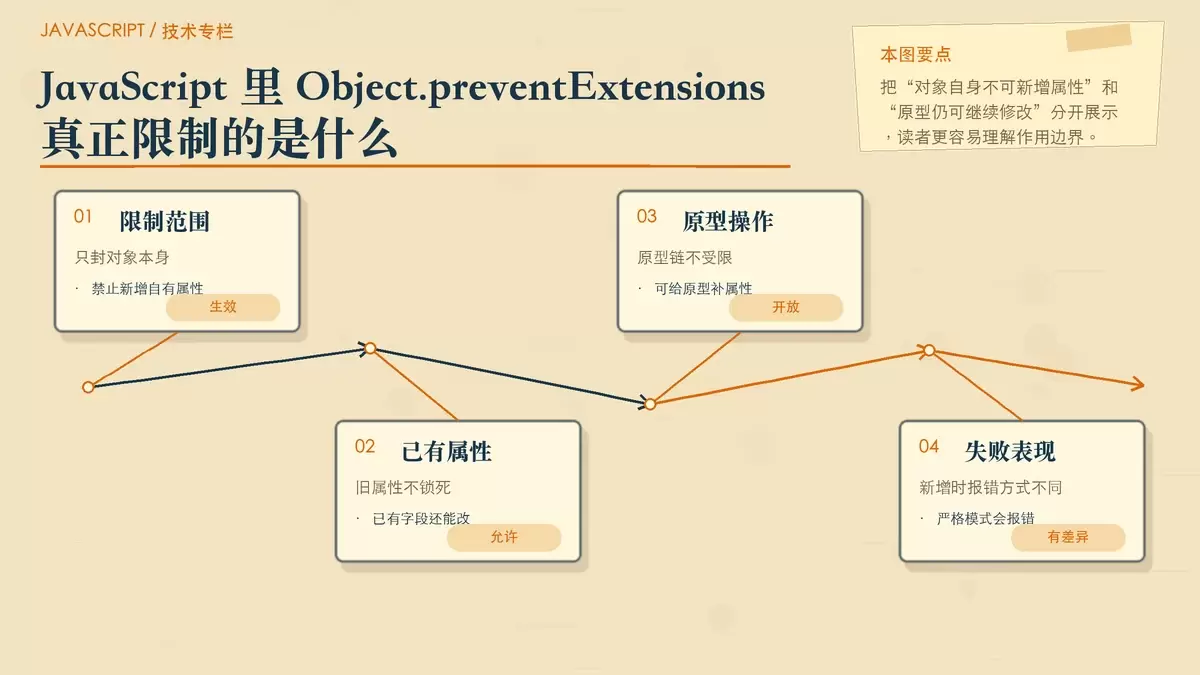
`Object.preventExtensions()` 只会阻止对象新增“自有属性”,不会封住原型链。实例仍可修改已有字段、删除属性,也能继续从原型继承新方法。理解它与 `prototype`、`__proto__`、`seal`、`freeze` 的边界,才能避免把“不可扩展”误当成“完全不可改”。 很多开发者会把 Object.preventExtensions() 误解成“对象彻底不能再动”,结果在看到原型还能继续加方法时感到困惑。
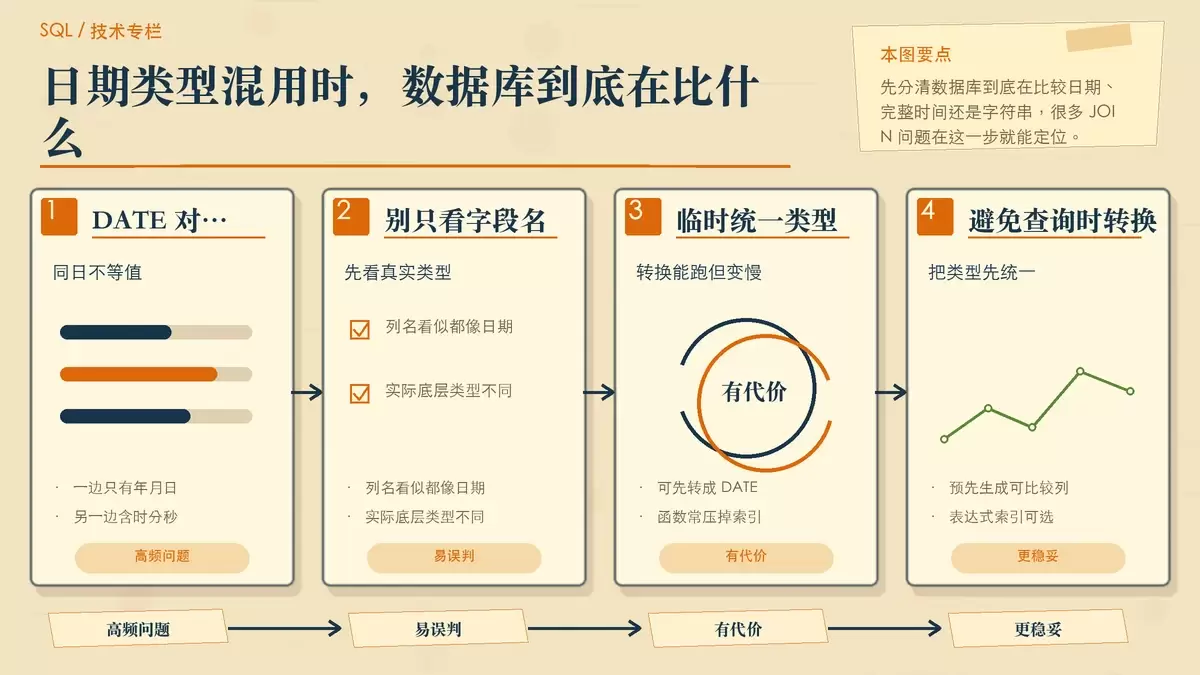
SQL 里日期字段 JOIN 匹配不到,通常不是“连不上”,而是比较条件本身有偏差。常见问题集中在类型不一致、时间精度不同、LEFT JOIN 条件位置错误,以及 NULL 和时区干扰;把排查顺序理清后,定位会快很多。
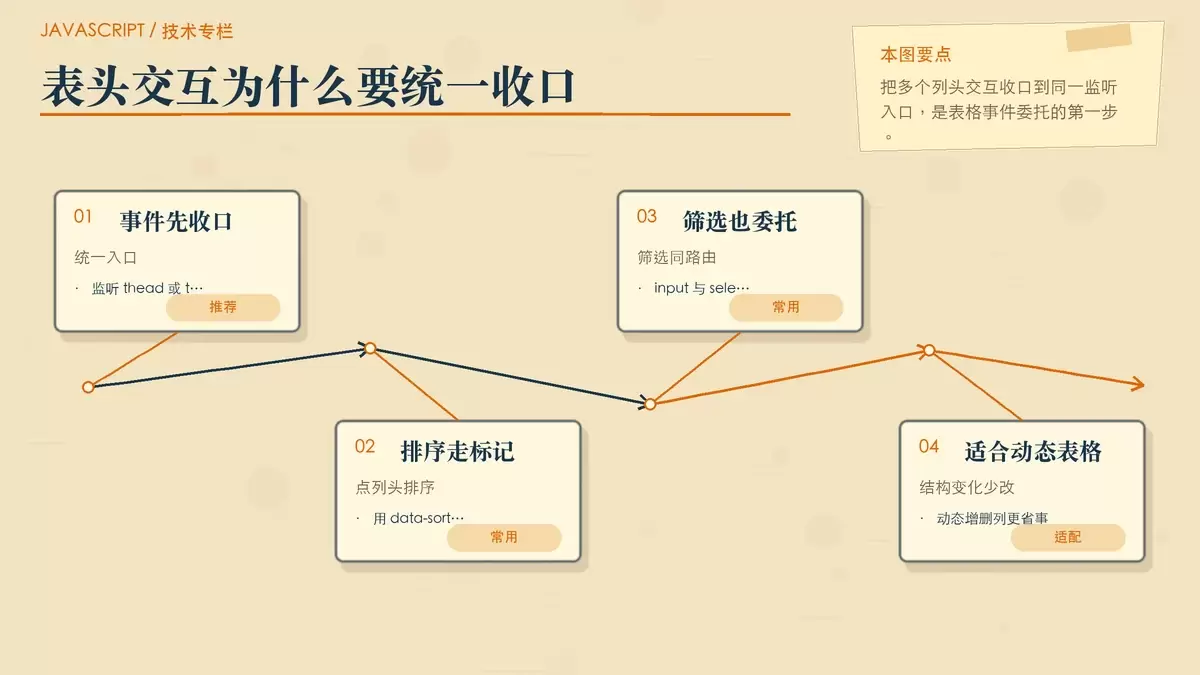
在可排序、可筛选的表格里,把事件统一委托到 或 ,能减少逐列绑定带来的开销,也更适合动态列场景。关键不只是拦截事件,还要借助 event.target.closest() 准确识别交互来源,并把排序、筛选和状态同步拆分清楚。
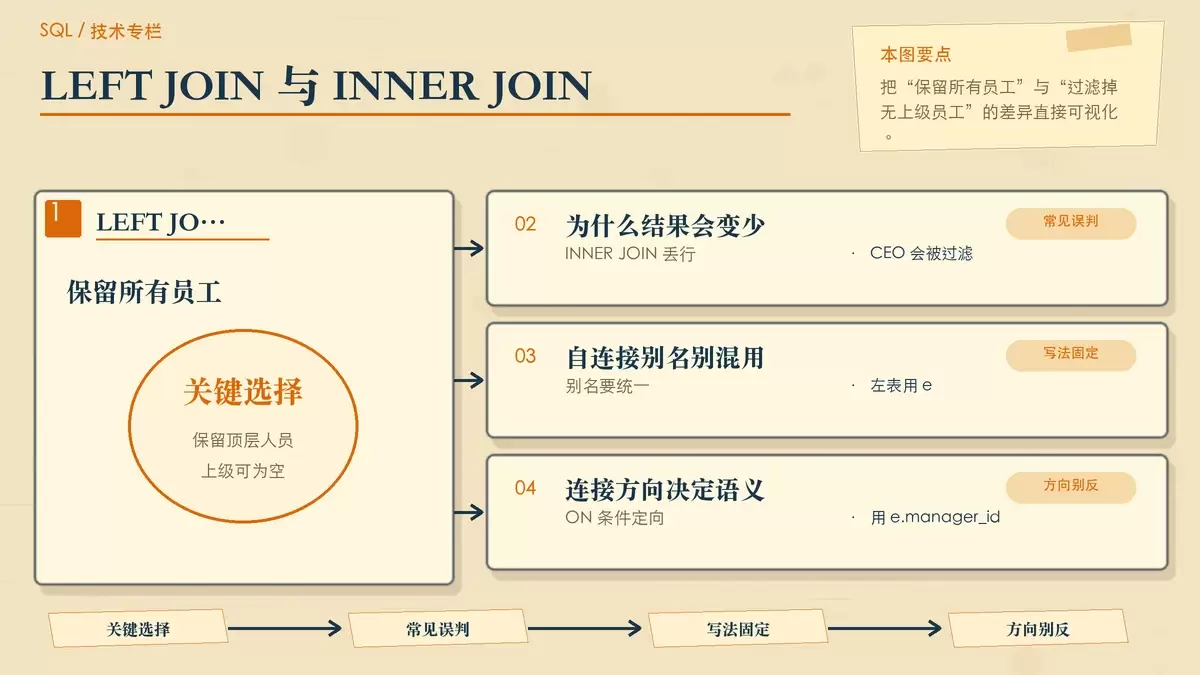
在同一张表里查询员工与经理这类层级关系时,关键不只是会写自连接,还要分清什么时候该用 LEFT JOIN、条件该写在 ON 还是 WHERE、以及索引是否到位。本文用员工表场景梳理正确写法、常见误区与多层查询边界。