


表一大,子查询就容易从“能跑”变成“拖垮查询”。问题通常不在于你写了 IN 还是 EXISTS,而在于执行计划是否落入嵌套循环、临时表物化,以及关键字段有没有让索引真正生效。下面按最常见的几个判断场景展开:先看子查询为什么会慢,再看能否改写成 JOIN,如果不能改写,索引至少该补到哪,最后处理最容易踩坑的深度分页组合。
为什么子查询在亿级表里特别慢
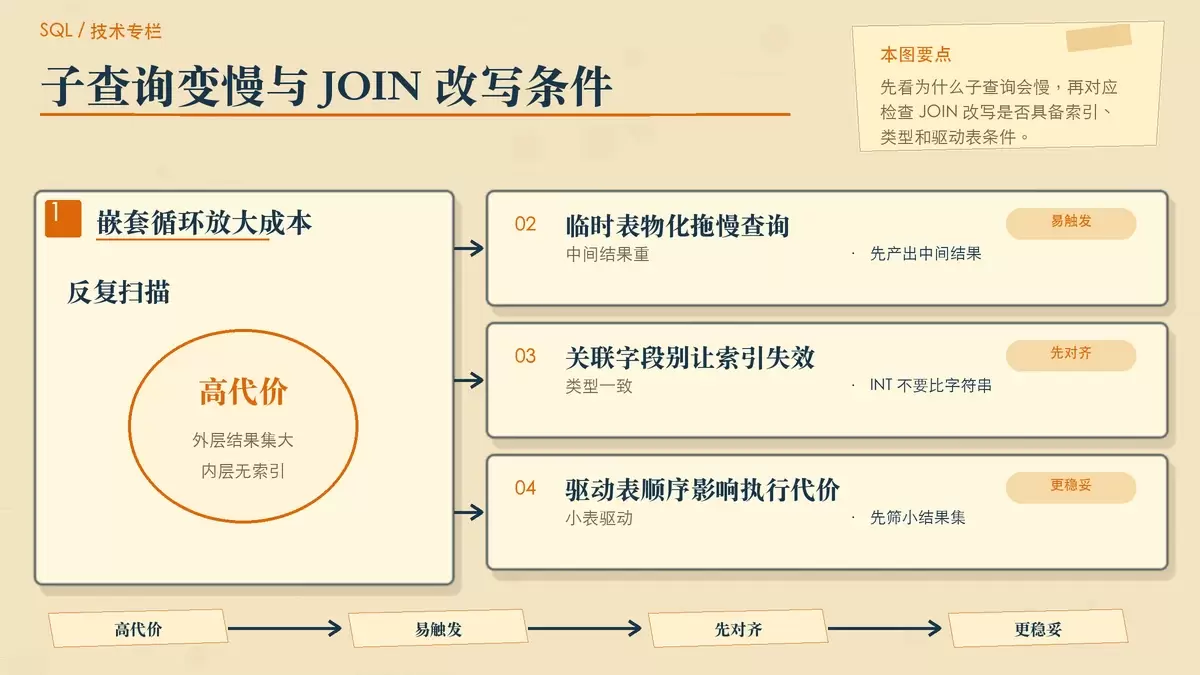
子查询在小数据量下往往看不出问题,但到了亿级表,执行代价会被迅速放大。原因通常有两个:
- 数据库可能对这类写法采用嵌套循环(Nested Loop)
- 或者先把子查询结果物化成临时表,再参与外层过滤
一旦外层结果集很大、内层又缺索引,数据库就可能对外层的每一行都重复做一次高成本查找,最坏情况下接近“外层行数 × 内层扫描代价”。
例如下面这条语句:
SELECT * FROM orders WHERE user_id IN (SELECT id FROM users WHERE region = 'CN')如果 users.id 没有索引,且 orders 有 1 亿行,那么执行时就可能出现非常夸张的扫描量。表面上只是一个子查询,实际代价却可能接近对大量数据反复做全表扫描。
所以,遇到子查询慢,第一反应不该只是改语法,而是先确认它是否把数据库带进了高代价执行路径。
把 IN/EXISTS 改写成 JOIN 时,重点看什么
大多数 IN 子查询和相关 EXISTS 子查询,都可以改写为 JOIN。这样做的核心价值,是让优化器更容易选择基于索引的关联路径,而不是反复执行内层子查询。
一个直接的改写示例如下:
SELECT o.* FROM orders o JOIN users u ON o.user_id = u.id WHERE u.region = 'CN';但能不能提速,不是只看你把子查询改成了 JOIN,而是要同时满足几个前提。
1. 关联字段类型必须严格一致
JOIN 两边字段的数据类型要完全对齐。比如 user_id INT 去和 '123' 这种字符串比较,就可能触发隐式转换,进一步导致索引失效。很多线上慢查询不是没加索引,而是索引因为类型不一致根本没被用上。
2. 尽量让小结果集做驱动表
如果 region = 'CN' 只会筛出几千个用户,那么更理想的路径是先缩小 users 结果集,再拿这些用户 ID 去 orders 表走索引查找。驱动表越小,关联代价通常越低;反过来,如果让大表先启动,再去匹配另一侧,执行成本就会明显上升。
3. 不要靠 JOIN 后补 DISTINCT 或 GROUP BY 收场
有些查询改写后出现重复行,开发者会顺手在外层加 DISTINCT 或 GROUP BY。这通常是在把一个问题换成另一个更贵的问题。更稳妥的做法,是尽量在子查询阶段先去重,或者根据语义改成 LEFT JOIN + IS NOT NULL 来模拟 EXISTS,减少额外排序或聚合开销。
判断标准很简单:如果改写成 JOIN 之后,执行计划能稳定走到索引、驱动表规模也明显更小,那这类重写通常值得做。
不能改写时,索引至少要补在这三个位置
并不是所有子查询都能直接改成 JOIN。如果里面带了聚合、窗口函数,或者业务逻辑本身就依赖子查询结构,那就别强行改写。这种情况下,最现实的办法是把索引补到关键位置,先把最重的扫描压下来。
1. 子查询自身的 WHERE 条件字段
例如 users.region。如果这个条件字段没有索引,数据库为了找出 region = 'CN' 的记录,仍然可能先把整张 users 表扫一遍。这样即便外层写得再漂亮,内层也已经慢了。
2. 子查询与外层的关联字段
例如 users.id 和 orders.user_id。这两个位置都要有索引,必要时可以进一步考虑复合索引。只给一侧建索引,另一侧仍可能成为瓶颈,导致关联阶段回表或扫描过多数据。
3. 外层查询本身的过滤字段
例如 orders.status。很多人会把注意力全部放在子查询上,却忽略外层过滤条件。如果外层依旧要扫全表,那么子查询提速的收益会被整体查询成本吞掉。
一个很常见的错误是:只知道 users.id 是主键,于是默认它已经足够快,却漏掉了 users.region。结果子查询为了找出命中的用户,先做了一次全表扫描,真正的慢点反而出在过滤字段上。
深度分页遇上子查询,为什么代价会失控
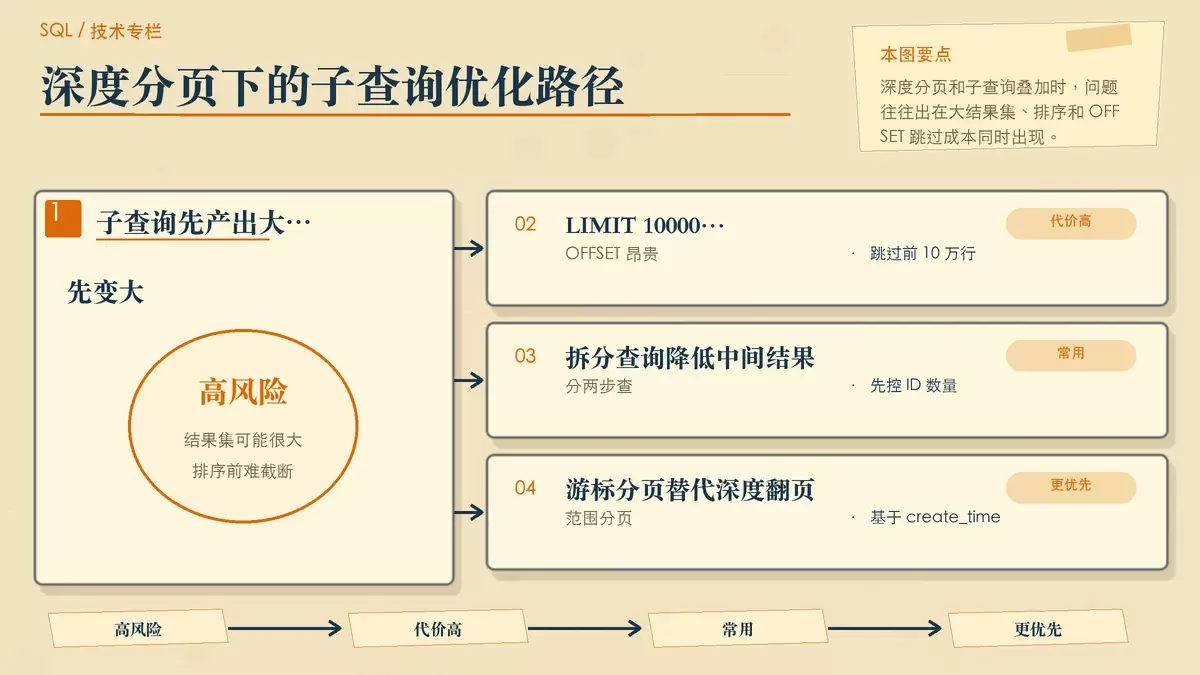
在亿级数据环境里,深度分页本来就昂贵,再叠加子查询,基本就是高风险组合。典型写法如下:
SELECT * FROM t1 WHERE id IN (SELECT id FROM t2 WHERE x=1) ORDER BY create_time LIMIT 100000, 20这条语句的问题不止一个:
- 子查询
SELECT id FROM t2 WHERE x=1可能先产出一个非常大的结果集 ORDER BY create_time可能触发额外排序或临时结果处理LIMIT 100000, 20并不会让数据库“直接跳到第 100001 行”,而是往往仍要先处理前面的大量记录
所以在这种场景下,MySQL 很可能需要先生成完整或接近完整的中间结果,再跳过前 10 万行,最后只返回 20 行。语句看起来只取很少的数据,执行成本却可能非常高。
可行的优化方向
- 拆成两步:先通过子查询拿到满足条件的 ID 列表,并用
LIMIT控制规模;再按这些 ID 做主键IN查询详情 - 放弃传统
OFFSET分页,改用游标分页:基于上一次查询返回的create_time和id做范围过滤 - 如果子查询结果集特别大,超过 10 万行,可以考虑先落到临时表,再为临时表补索引
这里真正难的,其实不是把 SQL 改写得多漂亮,而是判断“这一步是否必须实时算出来”。如果某个子查询结果变化不频繁,缓存到物化视图,或者放到应用层做预计算,往往比持续硬扛线上实时查询更有效。
优化子查询,先判断路径,再决定改写方式
处理亿级数据下的子查询,优先级通常很明确:先看是否能避免嵌套循环和临时表物化,再看能否改写成 JOIN,不能改写时就把索引补到过滤字段、关联字段和外层条件字段上。遇到深度分页,还要单独审视 LIMIT offset, size 的代价,不要把分页问题和子查询问题混在一起处理。
很多时候,决定查询快慢的不是某个单独语法,而是执行路径、结果集规模和索引命中是否同时站在正确一边。能据此判断,再去改 SQL,优化才更容易见效。









