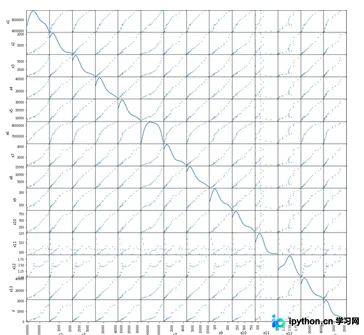
详解pandas绘制矩阵散点图(scatter_matrix)的方法
本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
2026-10-13
23

本文详细介绍pandas中scatter_matrix函数的用法,涵盖frame、alpha、figsize、diagonal等关键参数。通过sklearn的iris样本进行实战演示,展示如何配置颜色、标记及直方图选项,生成特征间关系的矩阵散点图,帮助开发者快速掌握多维数据的可视化技巧。
本文介绍在Jupyter Notebook中查看单元格运行时间的两种方法:通过安装jupyter_contrib_nbextensions启用Execute Time插件,以及使用%time和%%time Magic命令进行代码性能分析。详细解释了CPU时间与Wall time的区别,帮助用户优化代码执行效率。
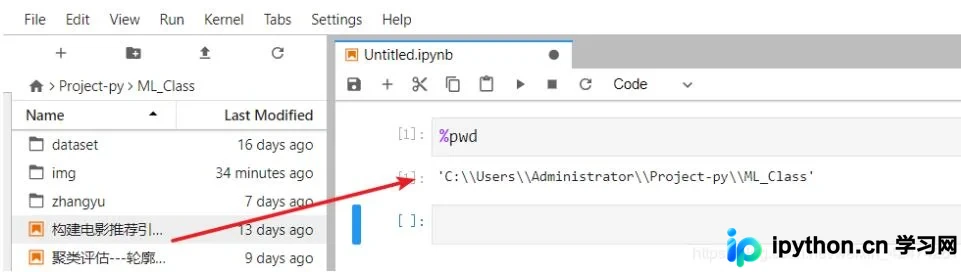
本文介绍Jupyter Lab中文件导出的两种常用方式。首先通过%pwd命令定位实际工作目录,理解其与磁盘文件的同步关系。接着详解直接复制文件以及利用浏览器右键菜单中的“在新标签页打开”或“复制下载链接”功能实现下载的操作步骤,帮助开发者高效管理Notebook文件。
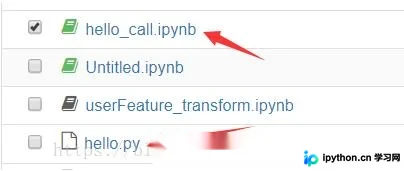
本文详解如何在Jupyter Notebook中处理.py与.ipynb文件的相互调用。通过将.ipynb转换为.py模块实现跨文件导入,并解决代码修改后需手动重载模块的问题,优化开发流程与工程结构。
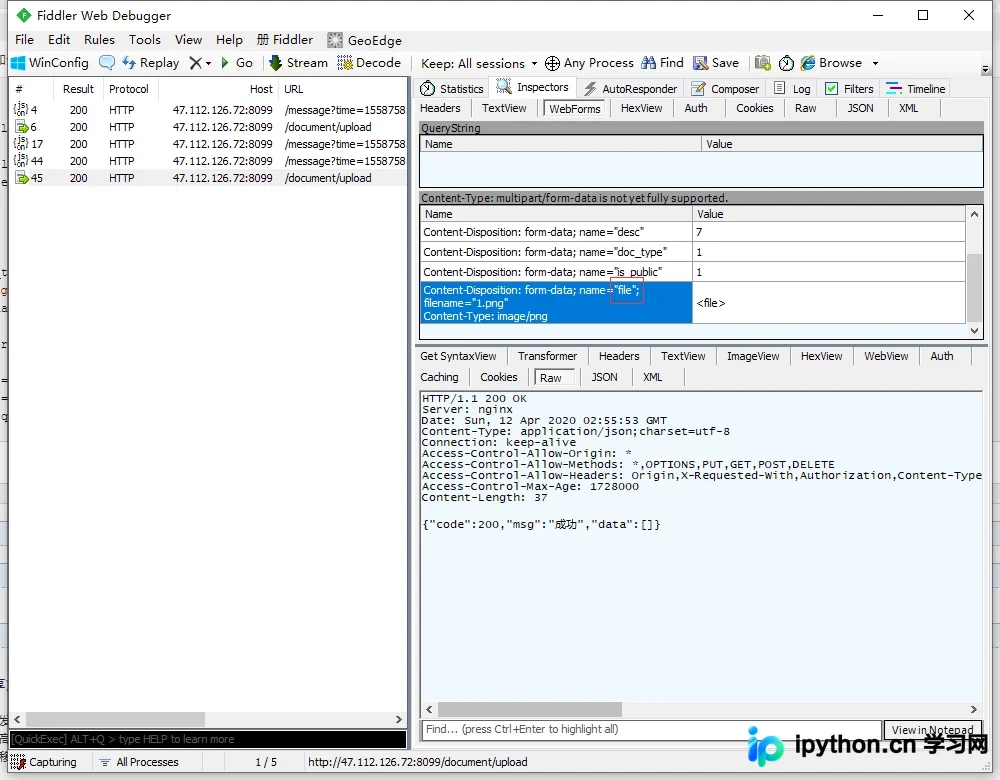
本文详细介绍Python中使用requests库进行文件上传的两种实现方式。方法一利用requests_toolbelt库的MultipartEncoder处理复杂表单数据,需手动转换参数类型并设置Content-Type;方法二直接使用原生requests,通过data和files参数分别传递附加信息与文件,无需额外依赖。文章包含完整代码示例及常见错误处理,适用于CRM接口测试等场景。
本文介绍在Jupyter Notebook环境中使用TensorFlow时,如何正确打印设备分配信息。通过设置log_device_placement=True及output_partition_graphs=True,可获取详细的设备日志。同时解决了因中文编码导致的控制台输出异常问题,提供完整的代码示例与配置方法。
在Python Spyder环境中使用Pandas查看DataFrame时,常因列数或行数过多导致数据显示省略号。本文介绍利用pd.set_option函数调整display.max_columns和display.max_rows参数,完整展示所有数据列与行,解决Spyder下的显示截断问题。
本文详细介绍Python中json模块的使用方法,涵盖字典与JSON字符串的相互转换。重点解析json.dumps和json.loads函数的参数配置,如ensure_ascii、indent和sort_keys的作用,并演示如何将数据写入JSON文件及从文件读取数据,提供完整代码示例。

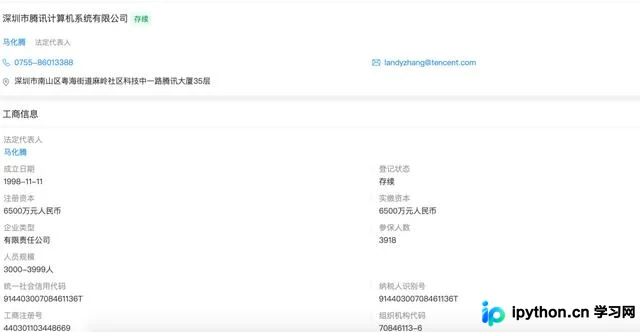
本文介绍利用Python结合Selenium与Web接口技术,实现无账号、无IP限制地批量获取全国企业基本信息的方法。通过对比Selenium登录验证、Requests Cookie请求等方案的局限性,最终确定仅依赖IP代理即可有效获取可公开展示的企业数据,为数据分析提供基础素材。
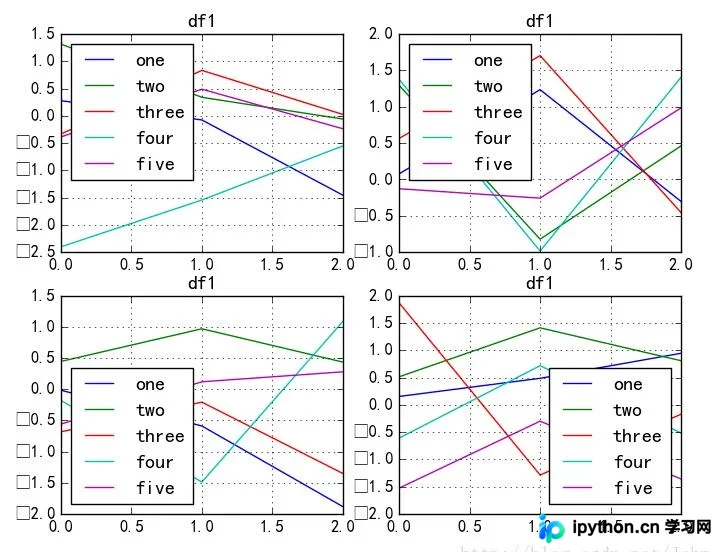
本文介绍在Python Matplotlib中处理多子图时图例重复的问题,通过调用legend_.remove()移除冗余图例,并利用loc和bbox_to_anchor参数将单个图例精确放置在图表外部,提升可视化效果。
本文介绍Python中getopt模块处理命令行参数的基本用法。通过示例展示如何定义短选项(如-t, -s, -h)和长选项(如--walletype, --servicename, help),并演示如何遍历解析后的选项列表,根据选项前缀提取对应的参数值或设置标志位。
本文分析在Jupyter Notebook或QtConsole中运行PyQt程序时内核自动重启的原因,指出这是由于app.exec_()阻塞导致内核进程被意外终止。通过修改退出逻辑为sys.exit(app.exec_()),可避免内核崩溃。同时解释了随之出现的异常提示,并建议在交互环境中使用命令行执行脚本以规避此类报错。