

Python list.sort()与sorted()的区别及适用场景
深入解析Python中list.sort()与sorted()的核心机制、内存表现、类型兼容性及工程适用场景,配有内存变化、执行流程、决策树及对比矩阵四幅内联图示。
在 Python 中对数据进行排序时,list.sort() 与内置函数 sorted() 是最常出现的两种选择。二者虽然都基于高效稳定的 Timsort 算法,但设计定位与底层行为截然不同:list.sort() 是列表类型专有的实例方法,直接在原列表内存中重排元素并返回 None;而 sorted() 则是全局内置函数,能接收任意可迭代对象,在保持原对象不变的前提下分配并返回一个全新的已排序列表。理解这一差异,是避免代码产生静默副作用与不必要内存消耗的关键。
一、核心机制差异:原地修改与新列表创建
判断使用哪个排序工具,首要考虑的是数据所有权与原序列是否需要保留。
list.sort() 属于原地操作(in-place)。当调用该方法时,Python 解释器在当前列表底层的数组结构上进行就地换位。这意味着没有新的列表容器被分配,原变量引用的内存地址维持不变。为了提醒开发者“原列表已被修改”,Python 刻意将其返回值设计为 None。如果误将结果赋值给新变量,就会导致变量变成 None,这是初学者最容易踩中的语法陷阱。
相对地,sorted() 是非侵入式操作。它从输入的可迭代对象中逐个读取元素,将其填充到一个新开辟的列表空间中进行排序,最终将该新列表作为返回值返回。原始数据无论位于何处、属于何种结构,都不会发生任何改变。
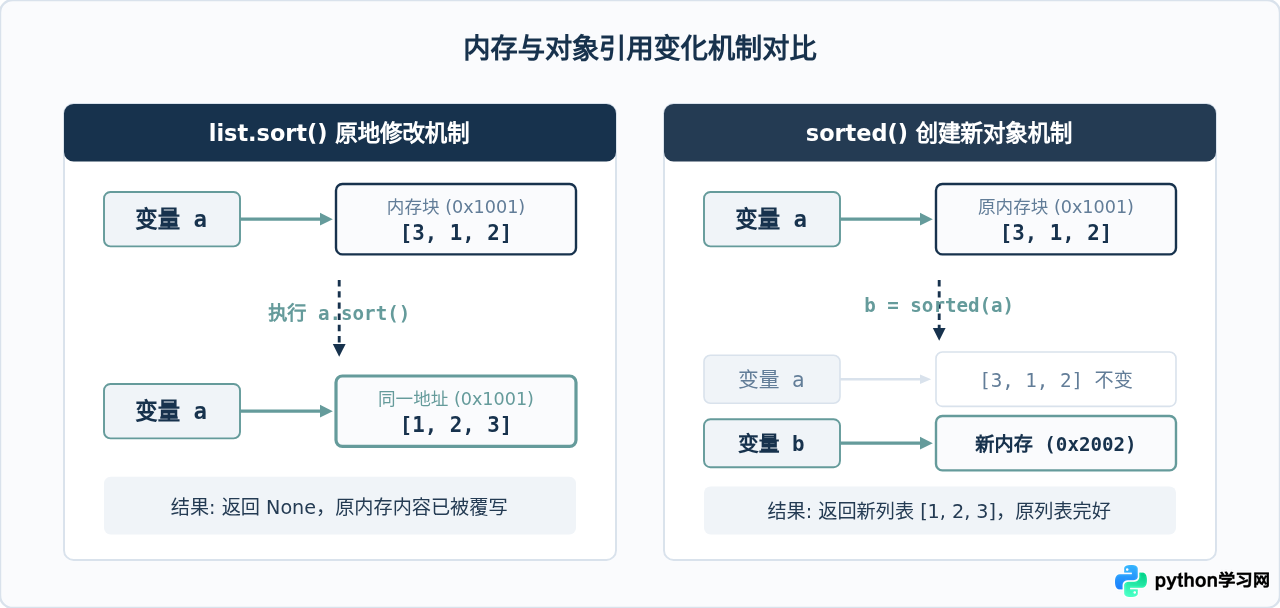
通过下方代码可以清晰观察到两者在返回值与原列表状态上的区别:
# 1. 使用 list.sort() 原地修改
raw_list = [5, 2, 9, 1]
sort_res = raw_list.sort()

print("sort() 返回值:", sort_res)       # 示例输出: sort() 返回值: None
print("raw_list 当前状态:", raw_list)  # 示例输出: raw_list 当前状态: [1, 2, 5, 9]

# 2. 使用 sorted() 创建新列表
original_nums = [5, 2, 9, 1]
new_nums = sorted(original_nums)

print("sorted() 返回值:", new_nums)        # 示例输出: sorted() 返回值: [1, 2, 5, 9]
print("original_nums 当前状态:", original_nums)  # 示例输出: original_nums 当前状态: [5, 2, 9, 1]
二、支持的数据类型:方法限定与全迭代器通用
除底层内存机制外,第二个核心差异在于数据类型的兼容范围。
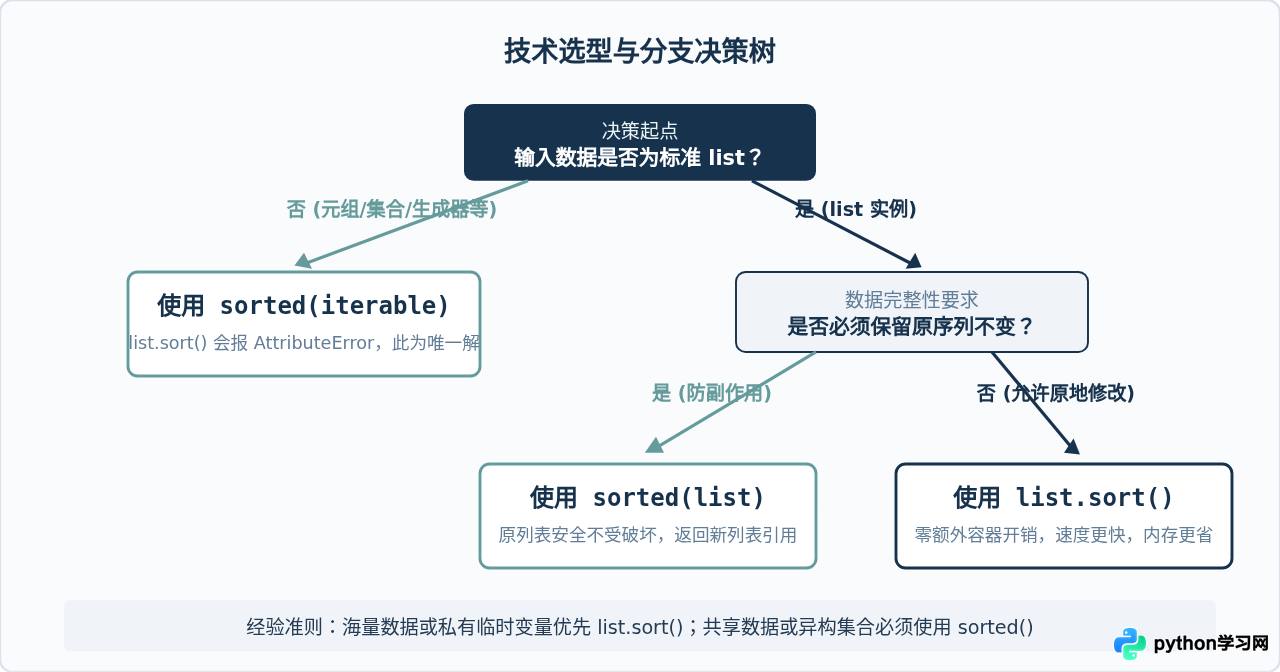
list.sort() 是属于 list 类的专有方法。如果尝试在元组(tuple)、集合(set)、字典(dict)或生成器(generator)上调用 .sort(),Python 会直接抛出 AttributeError 异常。这符合 Python 对数据结构的职责设计:元组是不可变类型,集合是无序类型,它们都不允许也不支持在自身结构上进行原地顺序重组。
而 sorted() 属于 Python 顶层内置函数,它的第一个参数是标准的 Iterable(可迭代协议)。任何支持迭代的对象都可以直接传入 sorted(),包括:
- 不可变序列:如字符串、元组;
- 无序集合:如集合(
set)、冻结集合(frozenset); - 字典:默认对其键(keys)进行排序,也可指定
dict.items()对键值对排序; - 惰性序列:如生成器表达式、读取文件产生的行迭代器等。
需要特别注意:不论传入的是什么类型的可迭代对象,sorted() 永远返回一个全新的 list 对象。例如传入字符串会返回排好序的字符列表,传入集合也会返回由集合元素构成的列表。
# 排序不可变元组
tpl = (10, 4, 7, 2)
sorted_tpl = sorted(tpl)
print(sorted_tpl)  # 示例输出: [2, 4, 7, 10] (返回列表)

# 排序字典键值对(按值从大到小)
scores = {"Alice": 88, "Bob": 95, "Charlie": 78}
ranked = sorted(scores.items(), key=lambda item: item[1], reverse=True)
print(ranked)  # 示例输出: [('Bob', 95), ('Alice', 88), ('Charlie', 78)]

# 排序生成器表达式
gen = (x * 2 for x in [3, 1, 4])
sorted_gen = sorted(gen)
print(sorted_gen)  # 示例输出: [2, 6, 8]
三、排序流程与参数机制:key 与 reverse 的高级用法
在底层算法实现上,两者完全一致,均采用著名混合排序算法 Timsort。Timsort 具备极强的稳定性(Stable Sort,即相对相等的元素在排序后保持原先的前后次序),并且在最坏情况下的时间复杂度为 \(O(n \log n)\),在已部分有序的实际数据中能达到近乎 \(O(n)\) 的线性性能。
在参数接口上,两者均支持完全相同的两个关键字参数:
key:接收一个单参数函数。在比较发生前,对每一个元素调用该函数,并依据其返回值作为比较键;reverse:布尔值,默认False为升序,指定为True时为降序。
Python 在设计 key 参数时采用了预计算映射(Decorate-Sort-Undecorate)思想:在整个排序周期中,对列表中的每个元素,key 函数仅被精确调用一次。计算得到的比较键与元素捆绑参与 Timsort 比较,排序结束后解绑,输出原元素。这保证了即便是耗时的复杂转换(如正则提取、多字段拆解),也不会因多次比较而被重复执行。
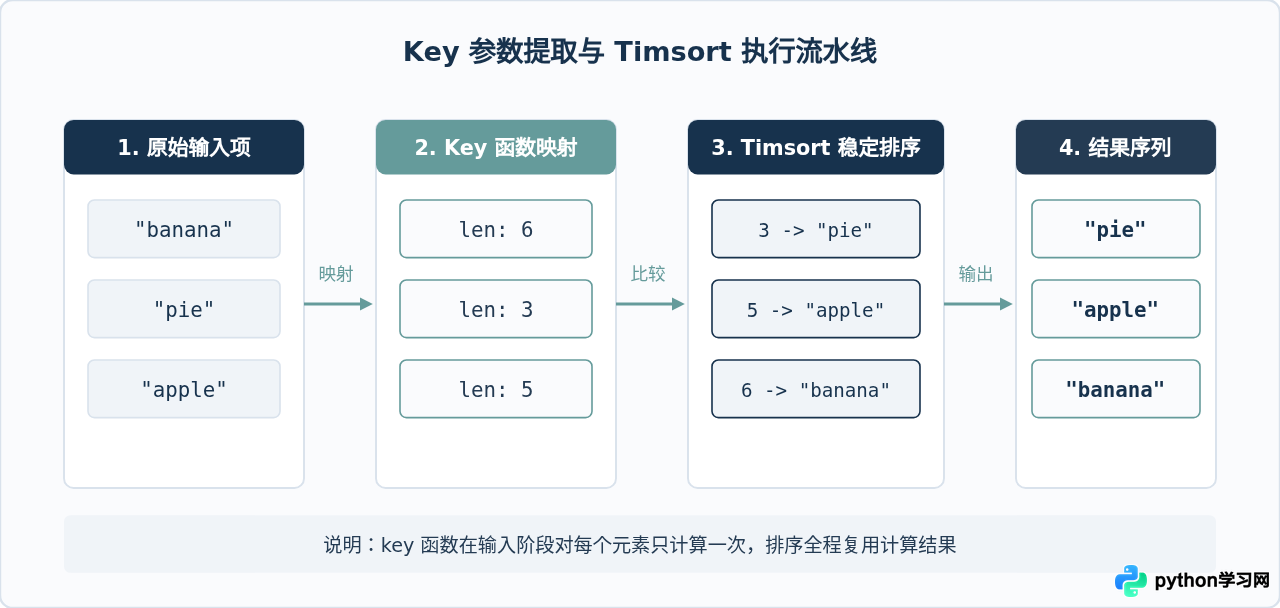
利用稳定排序特性,可以轻松实现多字段排序。例如优先按照部门升序,部门相同时按照工龄降序:
employees = [
    {"name": "赵六", "dept": "技术", "years": 5},
    {"name": "钱七", "dept": "财务", "years": 3},
    {"name": "孙八", "dept": "技术", "years": 8},
]

# 在 key 中返回元组:dept 升序,-years 模拟数值降序
employees.sort(key=lambda x: (x["dept"], -x["years"]))

for emp in employees:
    print(emp)
# 示例输出:
# {'name': '孙八', 'dept': '技术', 'years': 8}
# {'name': '赵六', 'dept': '技术', 'years': 5}
# {'name': '钱七', 'dept': '财务', 'years': 3}
四、性能与内存开销分析:何时选择哪一个?
在性能测试中,对于同一组列表数据执行排序,list.sort() 通常比 sorted() 稍快 10% 到 20%。造成这一微小速度差异的原因不是排序比较逻辑,而是内存管理:sorted() 必须先遍历输入序列构建一个新列表对象,在完成排序后还要处理该对象的引用计数与内存注册;而 list.sort() 直接在已有的 PyListObject 内部指针数组中搬移引用,避免了新建容器的开销。
更加关键的考量是空间复杂度与峰值内存消耗:
- 内存敏感场景(大型列表):当列表中包含数千万个对象引用时,额外构建一个等长列表意味着瞬时内存需求翻倍。在服务资源受限的环境下,极易触发操作系统的 OOM(Out Of Memory)杀进程机制。此时必须选择
list.sort()。 - 函数式编程与不可变场景:当原始列表需要被后续代码、外部调用者或其他并发逻辑读取时,就地修改会产生难以排查的“幽灵副作用”。此时应果断选用
sorted()。 - 非列表数据结构:如果输入源是生成器、元组或集合,只能通过
sorted()进行排序并聚合为列表。
五、常见错误与开发避坑指南
在日常代码编写和评审过程中,与这两个函数相关的错误往往集中在以下三个典型场景:
1. 错误的方法链式调用(Chaining Trap)
许多习惯了其他语言流畅接口(Fluent Interface)的开发者,倾向于写出如下代码:
# 错误示例:试图将排序与反转或取切片串联
numbers = [4, 1, 8, 3]
result = numbers.sort().reverse()  # 触发 AttributeError!
# 原因:numbers.sort() 返回值为 None,None 没有 reverse 属性正确解决方式:若要原地处理,分步调用 numbers.sort(reverse=True);若要在表达式中链式使用,使用 sorted():
# 正确写法 A(原地):
numbers = [4, 1, 8, 3]
numbers.sort(reverse=True)

# 正确写法 B(表达式):
top_two = sorted(numbers, reverse=True)[:2]
2. 函数参数传递产生的静默副作用
在 Python 中,列表是通过引用传递的对象。如果在业务函数内部直接对传入的入参列表调用 .sort(),将直接改变外部调用者的数据状态:
def get_median(data_list):
    # 隐患:修改了调用方传入的外部列表
    data_list.sort()
    mid = len(data_list) // 2
    return data_list[mid]

raw_data = [9, 1, 5]
median = get_median(raw_data)
print(raw_data) # 输出变为 [1, 5, 9],原有时序信息丢失!正确解决方式:在纯函数或库函数内部,除非文档明确约定会修改入参,否则一律使用 sorted_data = sorted(data_list)。
3. 循环体内部不必要的新列表生成
如果需要在循环内部频繁对同一个已有的工作列表进行重新排序,且旧顺序已经作废,使用 sorted() 会导致在每次迭代中都向 Python 内存分配器申请新内存并丢弃旧列表,增加垃圾回收(GC)负担。这种情况下应该在循环内复用 work_list.sort()。
六、全景特性对比与选型速查表
为了便于在日常开发中快速核对,下表与图示整理了 list.sort() 与 sorted() 的全维度对比指标:
| 比较维度 | list.sort() | sorted() |
|---|---|---|
| 语法归属 | list 专有实例方法 |
Python 全局内置函数 |
| 支持参数类型 | 仅限 list 实例 |
任意 Iterable(元组、集合、字典、生成器等) |
| 返回值 | None(严格原地修改) |
新创建的 list 实例 |
| 原始对象影响 | 原有列表元素顺序被永久覆写 | 原始数据保持不变(只读访问) |
| 辅助内存开销 | \(O(1)\)(复用原数组,仅需少量工作栈) | \(O(n)\)(必须完整开辟新列表容器空间) |
| 底层算法与稳定性 | Timsort,稳定排序 | Timsort,稳定排序 |
| 可选控制参数 | key=None, reverse=False |
key=None, reverse=False |
| 最适合的使用场景 | 内部临时大列表、内存敏感型任务、就地重组 | 保留原序、非列表类型排序、函数式传参、表达式链式调用 |
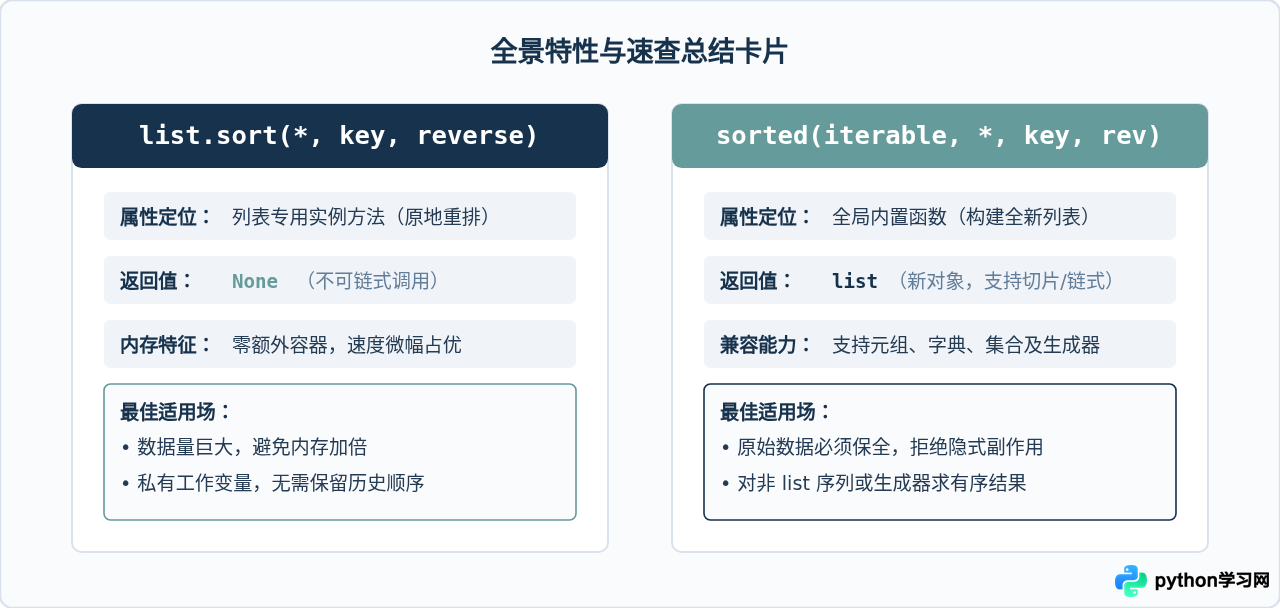
list.sort();当面对未知数据类型、需要维护数据不可变性,或希望在行内表达式中获得有序列表时,毫无疑问选择 sorted()。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









