

Python列表排序的稳定性及其对多次排序结果的影响
深入解析Python列表排序的稳定性原理,探讨稳定排序在多次排序、多字段分级排序中的应用规律与执行顺序,结合代码实例与图示帮助开发者写出高效可靠的排序逻辑。
list.sort() 还是全局函数 sorted())都保证是稳定排序(Stable Sort)。这一特性意味着:当两个元素的比较键值相等时,它们在排序后的相对前后位置严格不变。理解并利用好排序稳定性,是解决“多字段分步排序”、“按次要条件再按主要条件级联排序”等实际业务问题的关键基石。
一、排序的“稳定性”究竟是什么
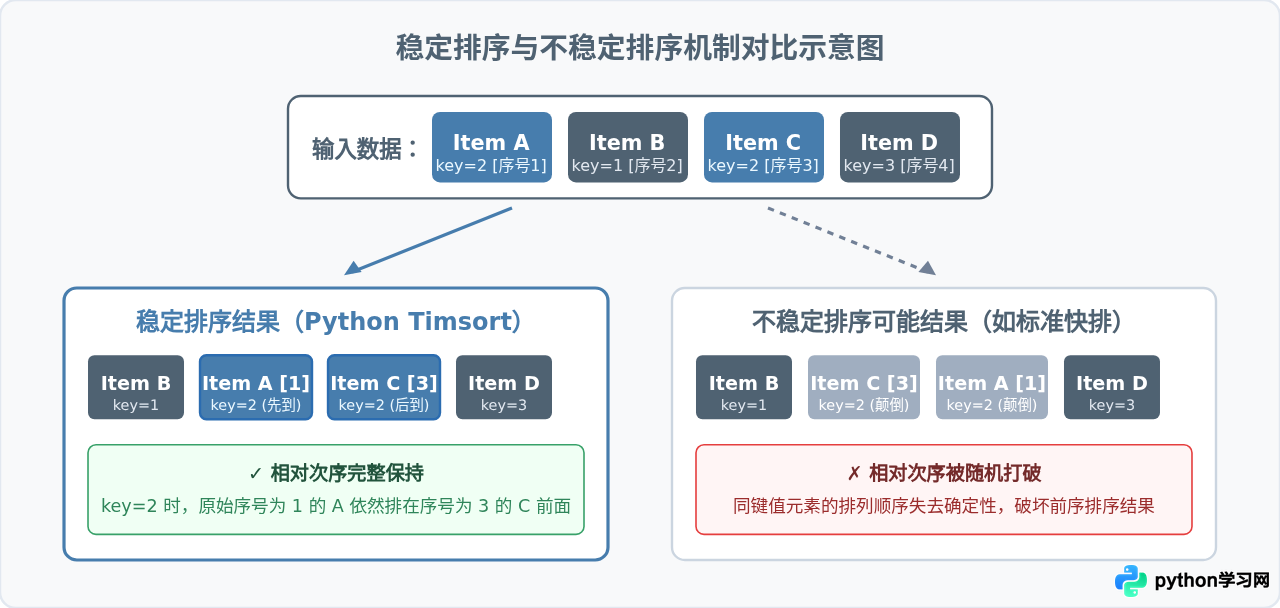
在计算机科学中,如果一种排序算法能够确保键值相同的数据元素在排序后依然保持其在原始输入中的先后次序,那么该算法就被称为“稳定的”。反之,如果两个具有相同键值的元素在排序后相对位置可能颠倒或处于随机位置,则称为“不稳定的”。
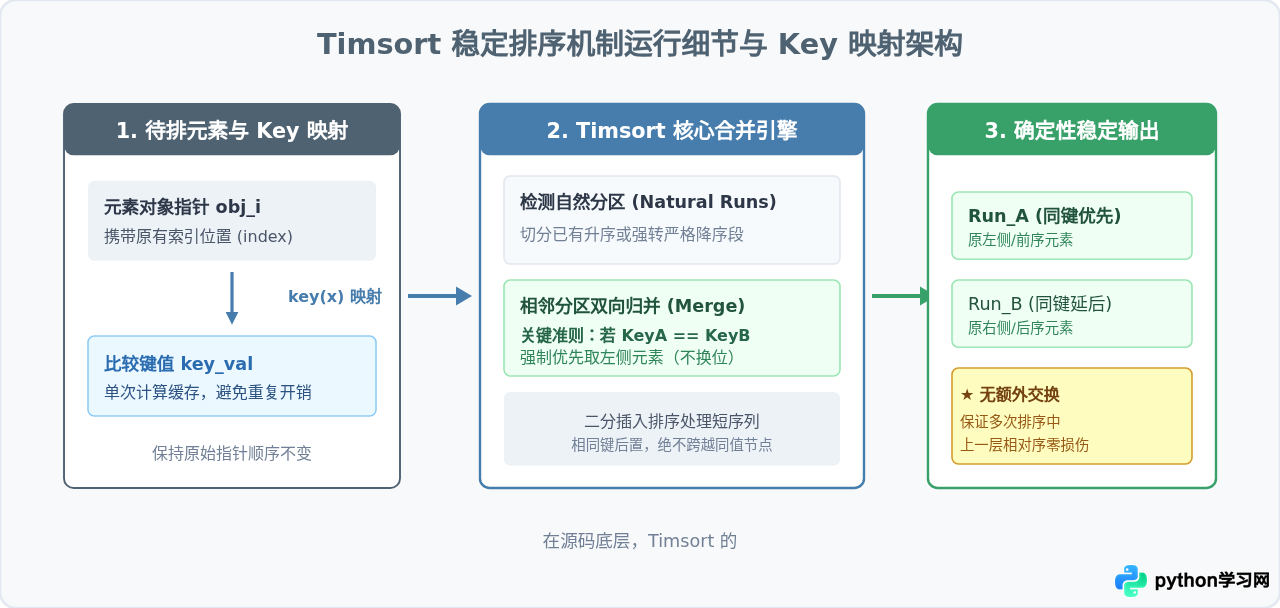
Python 从 2.3 版本开始采用由 Tim Peters 设计的 Timsort 算法作为官方默认排序算法。Timsort 是一种衍生自归并排序(Merge Sort)与插入排序(Insertion Sort)的自适应、混合稳定排序算法。它在最好情况下的时间复杂度为 O(n),最坏与平均时间复杂度均为 O(n log n),并且从设计机制上百分之百保证了排序的稳定性。
我们通过一段简单的 Python 代码来直观印证上述性质:
# 定义包含名字和等级的元组列表
# 注意:'Alice' 和 'Charlie' 的等级都是 'Level_2'
data = [
    ('Alice', 'Level_2'),
    ('Bob', 'Level_1'),
    ('Charlie', 'Level_2'),
    ('David', 'Level_3')
]

# 按等级字符升序排序
sorted_data = sorted(data, key=lambda item: item[1])

print(sorted_data)
# 输出结果:
# [('Bob', 'Level_1'), ('Alice', 'Level_2'), ('Charlie', 'Level_2'), ('David', 'Level_3')]
观察输出可以发现,Level_2 的两个条目中,原先排在前面的 Alice 依然在 Charlie 前面。这就是稳定性的最直接体现。
二、多次排序的核心法则:由次到主(Secondary First)
在实际项目开发中,经常会遇到“多列排序”需求。例如在电子表格或报表系统中:先按“班级”升序排列;在同一个班级内部,再按“考试成绩”降序排列。
正因为 Python 的排序是稳定的,我们可以利用多次调用 sort() 或 sorted() 轻松实现级联排序。但此时存在一条至关重要的执行规则:
为什么必须“由次到主”?让我们从逻辑推导的角度来理解:
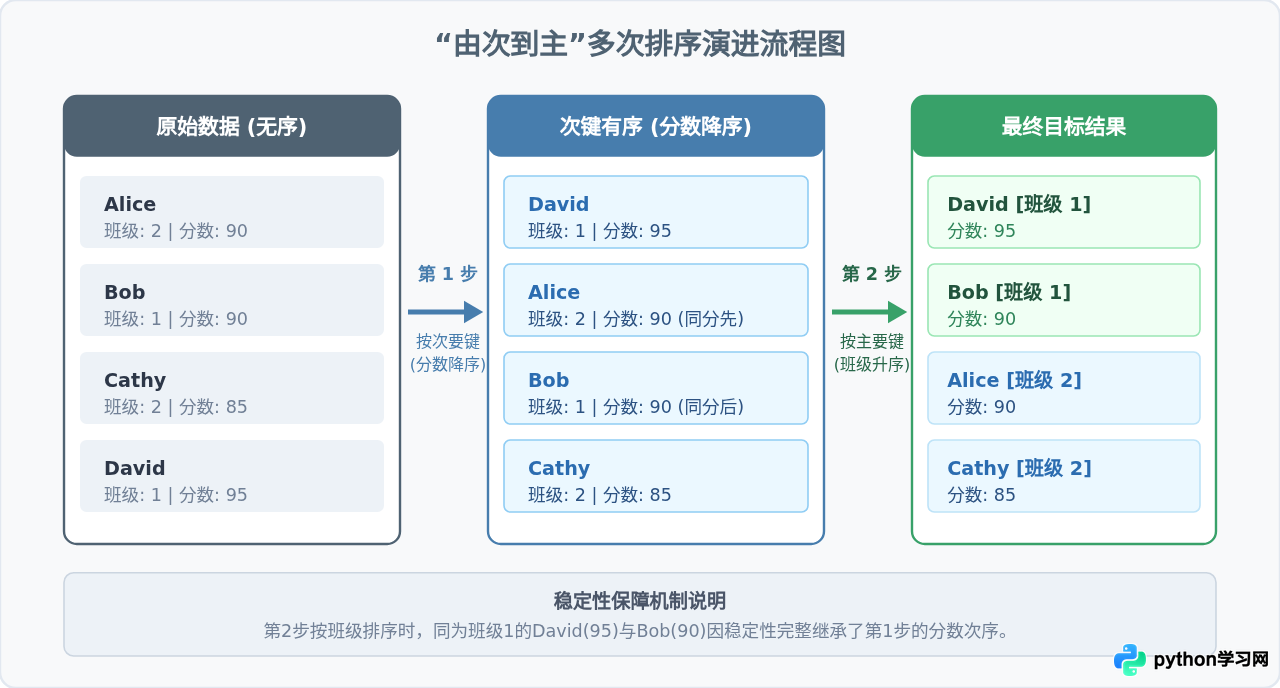
- 第一步(排次要键):先对整个列表按次要键(如分数)进行排序。此时整个列表已经根据次要键排好了先后顺序。
- 第二步(排主要键):接着对列表按主要键(如班级)进行排序。此时主要键不同的元素会被分流到对应的位置;而对于主要键相同的元素,由于算法是稳定的,它们会严格保留第一步排序后的相对次序。
反之,如果先排主要键,再排次要键,那么第二步的排序会彻底打乱主要键已经建立好的分区与顺序。
三、实战案例:电商订单多维筛选
为了加深理解,我们来看一个综合业务场景:处理一批电商交易订单。
每个订单包含三个属性:customer_level(会员等级:VIP 或 Normal)、amount(订单金额)、created_at(下单时间戳)。
业务排序需求:
- 主要条件:会员等级优先(VIP 排在前面,Normal 排在后面);
- 次要条件:相同会员等级内,按订单金额从高到低排序;
- 补充条件:金额完全相同的订单,按创建时间从早到晚(时间戳升序)排序。
按照“由次到主”的铁律,多次稳定排序的执行顺序应为:
- 第 1 次排序(最次要):按
created_at升序; - 第 2 次排序(次要):按
amount降序; - 第 3 次排序(最主要):按
customer_level排序(VIP 优先)。
orders = [
    {"id": 101, "customer_level": "Normal", "amount": 200, "created_at": "10:00:05"},
    {"id": 102, "customer_level": "VIP",    "amount": 500, "created_at": "10:01:20"},
    {"id": 103, "customer_level": "Normal", "amount": 500, "created_at": "09:59:00"},
    {"id": 104, "customer_level": "VIP",    "amount": 200, "created_at": "10:02:15"},
    {"id": 105, "customer_level": "VIP",    "amount": 500, "created_at": "10:00:10"}
]

# 步骤 1:最次要条件——按时间升序
orders.sort(key=lambda x: x["created_at"])

# 步骤 2:次要条件——按金额降序
orders.sort(key=lambda x: x["amount"], reverse=True)

# 步骤 3:主要条件——按会员级别,VIP 排在前面 (True 视为 1,False 视为 0)
orders.sort(key=lambda x: x["customer_level"] == "VIP", reverse=True)

# 打印最终排序结果
for o in orders:
    print(f"ID:{o['id']} | Level:{o['customer_level']:<6} | Amount:{o['amount']} | Time:{o['created_at']}")
执行结果输出:
ID:105 | Level:VIP    | Amount:500 | Time:10:00:10
ID:102 | Level:VIP    | Amount:500 | Time:10:01:20
ID:104 | Level:VIP    | Amount:200 | Time:10:02:15
ID:103 | Level:Normal | Amount:500 | Time:09:59:00
ID:101 | Level:Normal | Amount:200 | Time:10:00:05
验证输出细节:
- VIP 订单(105, 102, 104)排在 Normal 订单(103, 101)之前;
- 在 VIP 内部,金额为 500 的(105, 102)排在金额 200 的(104)之前;
- 在金额同为 500 的 VIP 订单中,下单时间更早的 105(10:00:10)精准排在 102(10:01:20)之前。
三次排序层层递进,每一层都依靠底层 Timsort 的稳定性完美保住了上一层的计算成果。
四、多次排序 vs. 单次元组键排序(Tuple Key)
在 Python 中,实现多字段排序还有另一种更为广泛使用的惯用写法(Idiomatic Python):构建元组键(Tuple Key)进行单次排序。
因为 Python 中的元组是按位置从左到右依次进行元素比较的,所以我们可以将多个字段封装为一个元组传给 key 函数:
# 使用元组单次排序实现同样的业务需求
# 注意:customer_level == 'VIP' 为 True(1) 或 False(0),配合负金额可实现混合方向
orders.sort(
    key=lambda x: (
        not (x["customer_level"] == "VIP"), # False(0) 在前,True(1) 在后
        -x["amount"],                       # 负数实现数值降序
        x["created_at"]                     # 字符串自然升序
    )
)
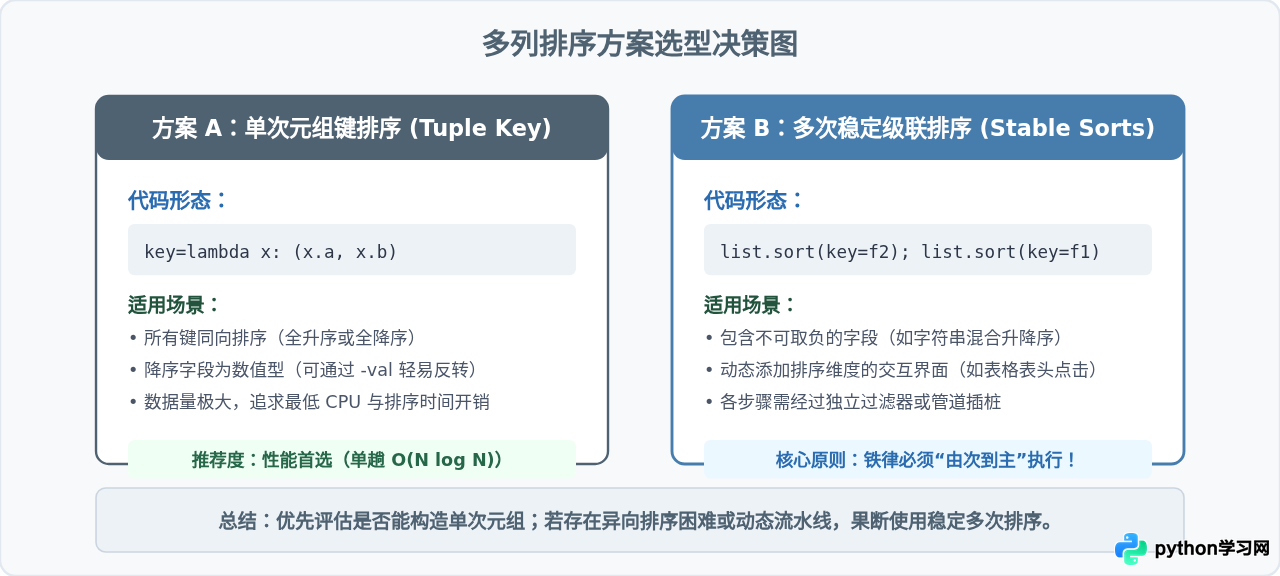
既然单次元组键如此方便,为什么还需要了解多次排序?两者应该如何选择?以下是详细对比:
| 对比维度 | 多次稳定排序 (Multiple Stable Sorts) | 单次元组键排序 (Single Tuple Key) |
|---|---|---|
| 时间复杂度 | O(k · n log n),k 为排序字段个数 | O(n log n),仅需单次遍历与排序 |
| 混合升降序支持 | 极佳。每一轮排序可独立设置 reverse=True/False |
有限。数值字段可加负号 -x 反转,但字符串、自定义对象无法直接求负,需编写辅助类或反转比较器 |
| 代码可读性 | 步骤清晰,适合管道流(Pipeline)逐步处理 | 简洁紧凑,一行代码搞定 |
| 动态条件配置 | 极强。可根据用户在界面的点击动态追加排序步骤 | 需要动态组装元组返回函数,代码稍显复杂 |
五、常见陷阱与避坑指南
1. 原地修改与返回新对象的链式调用陷阱
Python 初学者在尝试多次排序时,经常会写出如下错误代码:
# 错误示例:试图对 list.sort() 进行链式调用
items = [('C', 2), ('A', 1), ('B', 2)]
result = items.sort(key=lambda x: x[1]).sort(key=lambda x: x[0])
# 报 AttributeError: 'NoneType' object has no attribute 'sort'
原因解析:list.sort() 是原地修改列表的方法,其返回值固定为 None,因此不能链式调用。若想使用链式风格或保持原数据不可变,应使用 sorted():
# 正确做法 1:分步执行原地修改
items.sort(key=lambda x: x[1])  # 先排次要
items.sort(key=lambda x: x[0])  # 后排主要

# 正确做法 2:使用 sorted() 函数生成新列表
step1 = sorted(items, key=lambda x: x[1])
step2 = sorted(step1, key=lambda x: x[0])
2. 混合升降序中 reverse 参数的作用范围
当使用多次排序时,reverse=True 仅对当前这一次调用有效。这也正是多次排序的一大优势:可以随意指定每个维度的升降序。例如先让分数降序,再让班级升序:
# 正确:每一层独立控制升降序
students.sort(key=lambda s: s.score, reverse=True) # 分数高的排前面
students.sort(key=lambda s: s.grade, reverse=False) # 班级小的排前面
3. Key 函数返回非确定值破坏稳定性
Timsort 的稳定性建立在比较结果具有“严格传递性”与“确定性”的前提下。如果 key 函数返回带有随机性(如 random())、外部时变状态或无法确定大小的集合,不仅排序结果无法预测,稳定性保障也将彻底失效。
六、总结
Python 列表排序的稳定性不是一个偶然的实现细节,而是 Timsort 算法在设计之初就确立的确定性契约。归纳全文的核心结论如下:
- 稳定性本质:键值相同的元素在排序前后严格保持原有的相对排列顺序;
- 多次排序法则:如果要通过多次排序实现多列级联排序,必须从最次要的字段排起,最后排最主要的字段;
- 方案选型权衡:单次元组键排序(Tuple Key)性能最佳,适合同向或纯数值混合排序;多次稳定排序灵活性最高,是处理异向混合排序、动态条件排序的利器。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









