

Python怎么直接从URL链接读取远程CSV数据?
详细讲解在Python中直接通过URL链接读取远程CSV数据的多种方法,包含Pandas、标准库urllib与csv模块、Requests请求库的具体实现、原理解析与常见编码和鉴权处理。
在Python中直接从远程URL读取CSV数据,核心解决路径通常有三种:如果项目中已经引入了数据分析库Pandas,直接使用一行代码 pd.read_csv(url) 是最高效直接的方式;如果是轻量化脚本或不希望安装第三方依赖的纯净环境,可以使用Python内置的标准库 urllib.request 配合 csv 模块进行流式解析;而在遇到需要传递认证头(如API Token)或伪装请求头的防爬接口时,则采用 requests 库获取响应流并交由 csv 或 pandas 读取。
本文将围绕这三种典型场景,逐层拆解从网络链接直接获取CSV数据的完整步骤、代码实现与常见异常防护方案,帮助你在不产生本地临时文件的前提下,完成内存中数据的安全高效加载。
一、标准处理流程与决策路径
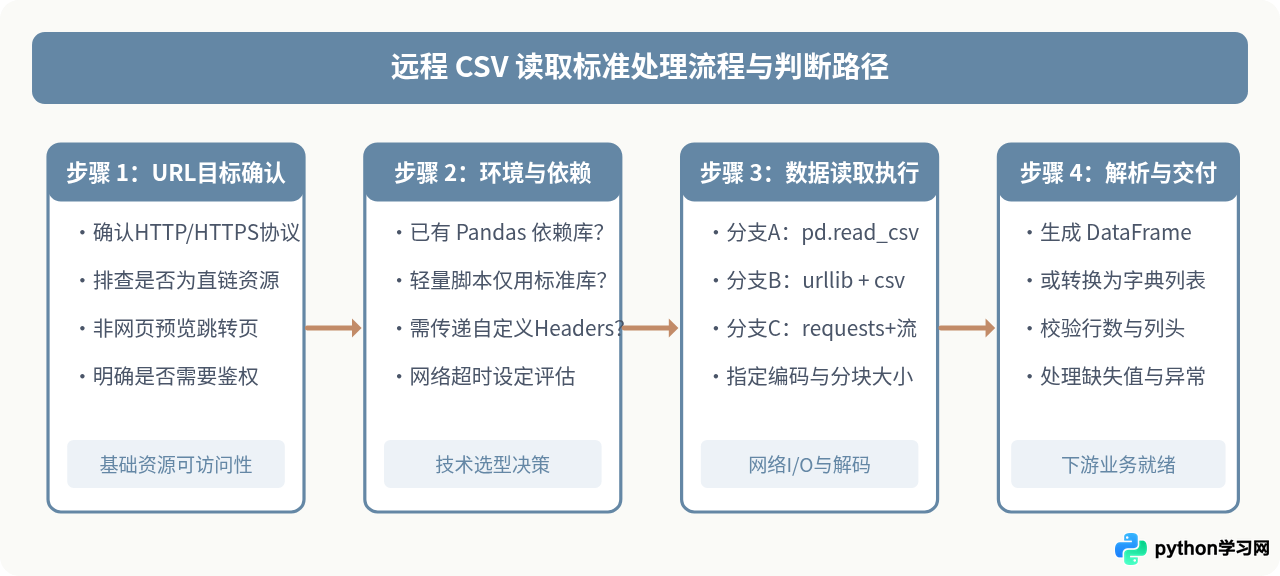
在编写代码前,明确远程URL的性质与当前环境约束,有助于快速选用最合适的技术方案。整个处理过程通常经历URL验证、运行环境评估、数据读取适配及内存对象校验四个阶段。
二、方法一:使用 Pandas 一步读取(最常用)
如果后续工作需要进行统计分析、透视表计算或数据清洗,使用 pandas.read_csv() 是首选方案。Pandas 内部对传入的路径参数做了协议识别,当检测到 http://、https:// 或 ftp:// 开头的字符串时,会自动调用底层的网络支持组件发起请求,并在内存中完成解码与结构化装配。
1. 基础读取代码
import pandas as pd

# 远程可直接下载的CSV公开链接(示例)
url = "https://people.sc.fsu.edu/~jburkardt/data/csv/airtravel.csv"

try:
    # 直接将 URL 传递给 read_csv
    df = pd.read_csv(url)

    # 打印前 5 行数据与数据维度
    print("读取成功,数据形状为:", df.shape)
    print(df.head())
except Exception as e:
    print("读取发生异常:", e)
注意:传入的必须是直接返回 CSV 文本的“直链”,而不是包含网页导航栏、广告或“点击下载”按钮的普通 HTML 页面。如果链接实际返回的是 HTML,Pandas 在解析第一行分隔符时通常会抛出 ParserError。
2. 常用参数与进阶配置
当网络资源存在中文字符编码特殊、需要自定义请求标头或只想加载部分列时,可以添加控制参数:
encoding:远程文件为中文时常用encoding="utf-8"或encoding="gbk";如果是 Windows Excel 导出的带签名文件,建议使用encoding="utf-8-sig"。storage_options:Pandas 支持通过该参数配置底层网络客户端属性(如 User-Agent 请求头)。usecols:仅加载指定的列名或列索引列表,大幅降低网络解包与内存占用。
# 带有编码和请求头配置的读取示例
headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

df = pd.read_csv(
    url,
    encoding="utf-8",
    storage_options={"User-Agent": headers["User-Agent"]}
)
三、方法二:使用 Python 内置标准库(零第三方依赖)
在编写自动化运维脚本、微型云函数(AWS Lambda、阿里云函数计算)或对依赖体积有严苛限制的环境中,专门安装 Pandas(连带 numpy 等依赖数十兆)往往过于沉重。Python 提供了开箱即用的 urllib.request 和 csv 模块,完全能够纯原生实现流式读取。
标准库逐行流式解析实现
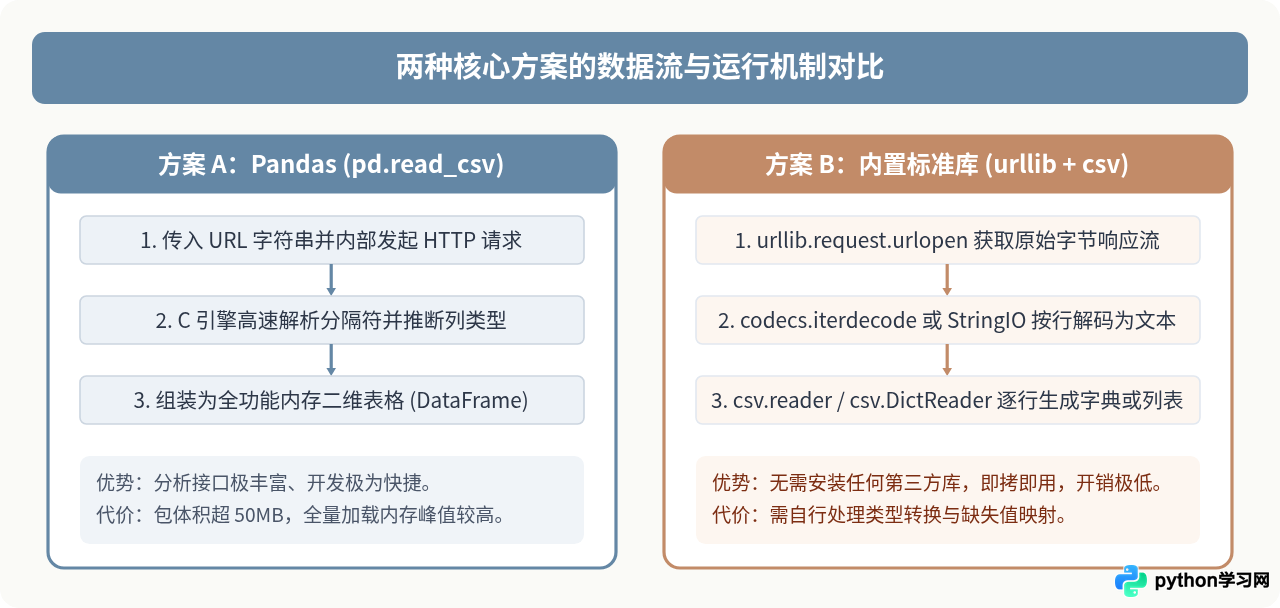
核心技巧在于:urllib.request.urlopen(url) 返回的是一个字节流对象。我们可以使用 codecs.iterdecode 将其包裹为逐行解码的字符生成器,然后直接交给 csv.reader 或 csv.DictReader 解析,这样无需一次性将所有字节加载进内存即可逐行处理。
import urllib.request
import csv
import codecs

url = "https://people.sc.fsu.edu/~jburkardt/data/csv/airtravel.csv"

# 设置 10 秒超时,避免网络挂起
req = urllib.request.Request(
    url,
    headers={"User-Agent": "Mozilla/5.0 (Python Standard Library)"}
)

with urllib.request.urlopen(req, timeout=10) as response:
    # 逐行流式解码为 utf-8
    csv_stream = codecs.iterdecode(response, "utf-8")

    # 使用 DictReader 直接将首行作为字段名映射为字典
    reader = csv.DictReader(csv_stream)

    print("字段标题:", reader.fieldnames)

    # 演示读取前 3 行
    for index, row in enumerate(reader):
        print(f"第 {index + 1} 行:", dict(row))
        if index >= 2:
            break
四、方法三:应对鉴权与复杂网络环境(Requests + 内存流)
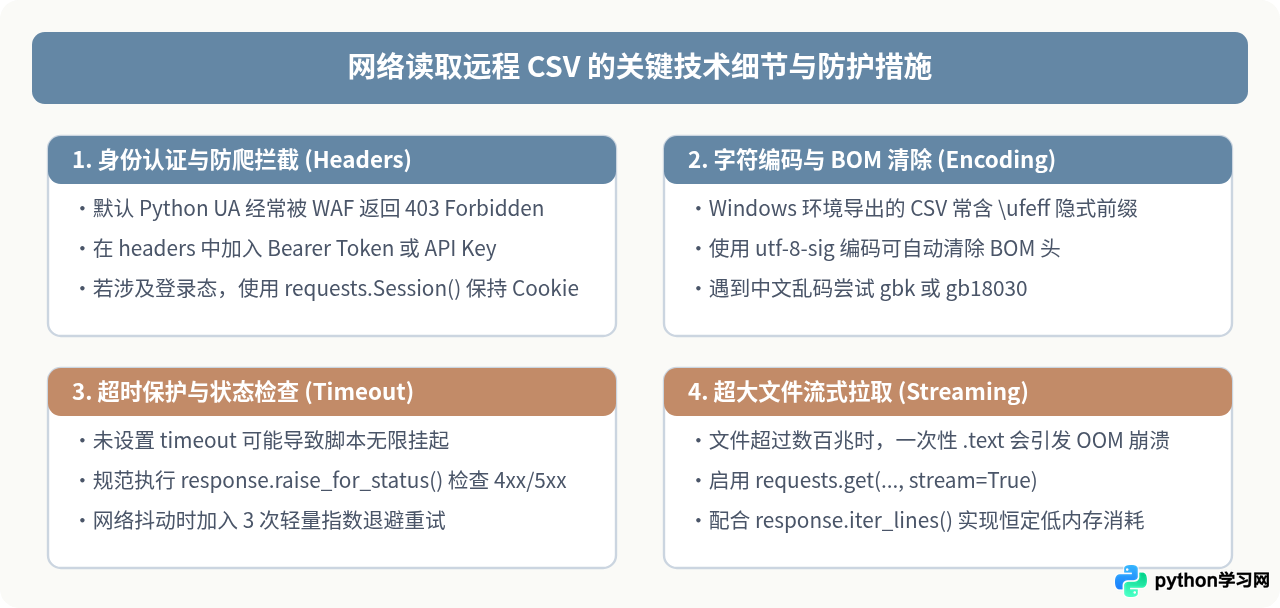
现实工作中,许多CSV接口并不属于完全公开的静态资源,而是受内部系统或API网关保护。例如需要提供 Authorization: Bearer <token>、维持特定 Session Cookie、通过公司代理,或者目标服务器开启了严格的浏览器指纹校验。此时,使用成熟的人性化网络库 requests 能够轻松满足各类鉴权需求,再结合 io.StringIO 将响应文本虚拟成类文件对象转给 Pandas 或 CSV 模块。
带自定义 Headers 的完整调用代码
import io
import requests
import pandas as pd

url = "https://example.com/api/v1/export-report.csv"

# 自定义请求头(模拟真实客户端并附带鉴权凭证)
custom_headers = {
    "User-Agent": "DataSyncClient/1.0 (Enterprise Internal Service)",
    "Authorization": "Bearer your_secret_api_token_here",
    "Accept": "text/csv, text/plain"
}

try:
    # 明确设定连接与读取超时时间 (连接5秒, 响应30秒)
    response = requests.get(url, headers=custom_headers, timeout=(5, 30))

    # 确认 HTTP 响应状态码为 200,非 200 会主动抛出 HTTPError
    response.raise_for_status()

    # 纠正或强制指定正确的字符集编码
    response.encoding = "utf-8"

    # 使用 io.StringIO 将文本字符串在内存中模拟为文件对象
    csv_file_like = io.StringIO(response.text)

    # 转交 Pandas 读取
    df = pd.read_csv(csv_file_like)
    print("成功解析鉴权接口数据,行数:", len(df))

except requests.exceptions.RequestException as e:
    print("网络请求失败:", e)
五、生产环境常见问题与避坑指南
直接通过网络读取远端数据与读取本地文件最大的不同在于:网络环境是不可控且存在抖动的。在实际开发中,有三类高频问题需要特别注意。
1. 常见问题一:首列列名出现奇怪的 \ufeff 乱码
表现:df.columns 中第一个字段名字形如 '\ufeffid' 而不是期望的 'id',导致 df['id'] 访问时报错 KeyError。
原因:这是由于 CSV 文件的生成源(如 Windows Excel 或老旧脚本)在文件开头插入了 UTF-8 字节顺序标记(BOM,即 EF BB BF)。
解决:在读取时将编码格式显式设定为 utf-8-sig。Python 会自动识别并剔除开头的 BOM 特征头,还原干净的字段名称。
2. 常见问题二:读取大文件时脚本内存溢出(OOM)
当远程 CSV 文件达到几百兆甚至数吉字节(GB)时,一次性把全部内容拉取到内存中会直接触发系统的进程保护导致崩溃。解决办法有两种:
- Pandas 分块模式:使用
chunksize参数,此时pd.read_csv会返回一个可迭代的TextFileReader对象,支持逐批次处理并写入数据库。 - Requests 逐行迭代:配置
stream=True,使用response.iter_lines(decode_unicode=True)遍历每行文本。
# Pandas 分块读取超大远程 CSV 示例
chunk_iterator = pd.read_csv(url, chunksize=10000)

for chunk_index, chunk_df in enumerate(chunk_iterator):
    # 每次只在内存中保留 10000 行
    print(f"正在处理第 {chunk_index + 1} 块数据,样本条数: {len(chunk_df)}")
    # 此处可进行逐批持久化,如入库或计算聚合
六、方案选型与最佳实践全景总结
为了帮助你在不同业务约束下迅速挑选出最适合的技术路径,下表及总结图清晰列出了核心维度的对比依据。
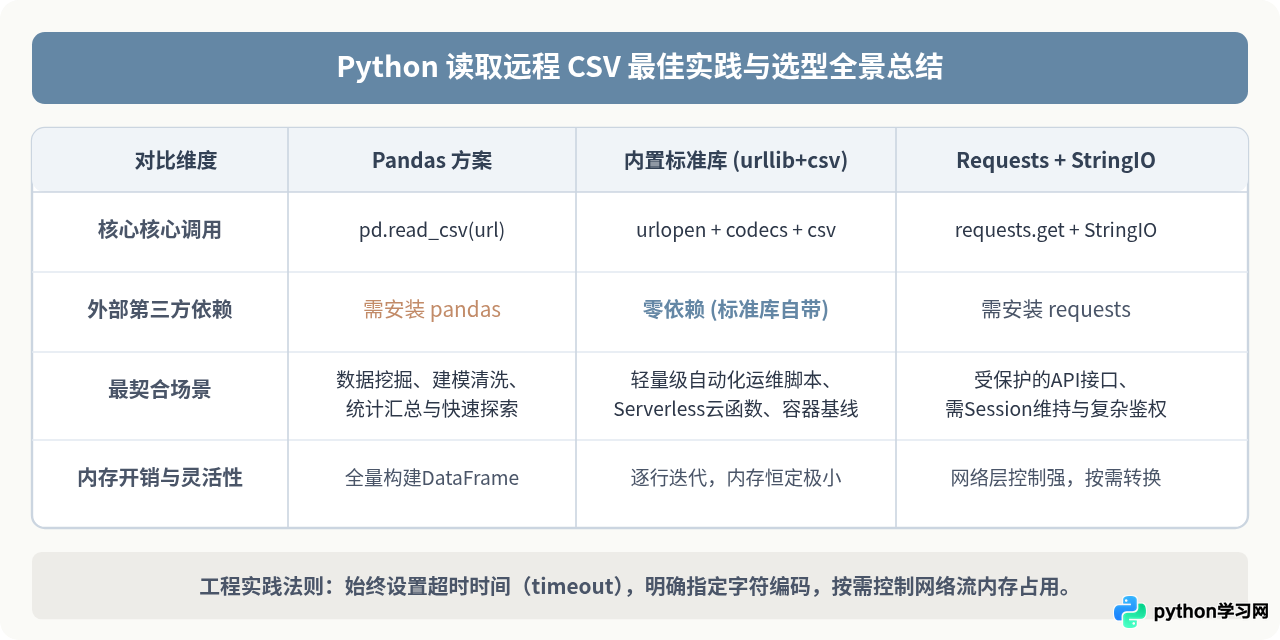
工程总结:如果已有分析环境,pd.read_csv(url) 永远是最省时省力的首选;若要分发轻量脚本,优先选择内置标准库 urllib + csv;在对接具备反爬与权限验证的接口时,则选用 requests 作为网络入口。掌握这三种方式,即可从容应对绝大部分远程数据读取任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









